7.2 容量可靠性与容错
7.2 容量、可靠性与容错
时延账算完,本页翻到另两块表:容量(一个星座最多能同时端多少碗水)与可用性(多久掉一次碗)。本节吸收了原书"可靠性与容错"一节的内容:可用性建模与故障域分析,正是容量问题的孪生兄弟——冗余既吃容量也保容量。
容量的四因子分解
全网容量可以拆成一条清晰的乘法链:单波束吞吐 × 每星波束数 × 在轨卫星数 × 复用增益,再除以统计复用的用户数得到人均速率。每个因子的提升代价完全不同:单波束吞吐吃频谱带宽与调制效率(第 4 章,受物理与频谱地契双重约束);波束数吃天线口径与星上功率;卫星数吃发射预算(第 9 章);复用增益吃染色规划与干扰管理(第 3、4 章)。值得注意的是"覆盖与容量的互斥":同样的卫星数,撒向全球则每处薄、堆向人口带则别处空——星座设计本质是一道带空间约束的资源配置题,而且人口分布高度不均(南北纬二十度到六十度带集中了绝大部分需求),这就是为什么"覆盖重数"在人口带普遍取高、在远洋与极区只保基本盘。
三个常被混用的口径必须分开:单用户峰值(营销最爱引用,等于单波束吞吐,只对独占波束的用户成立)、波束聚合容量(工程口径,一个波束内所有用户分享)、全网容量(运营口径,扣除开销与忙时统计)。用营销数字除以用户数得到的人均值,通常高估真实体验三到五倍。
可用性:串并联的算术
可用性等于正常时间除以总时间,"几个九"是它的小数表示。系统可用性由部件可用性按结构组合:串联相乘、并联互补。脚本算一串典型结构:
def series(avails): a = 1.0 for x in avails: a *= x return a def parallel(avails): a = 1.0 for x in avails: a *= (1 - x) return 1 - a gw = 0.999 # 单信关站(含回传) sat = 0.9995 # 单星链路可用 isl = 0.9999 # 星间链路 term = 0.9999 # 终端侧 path1 = series([term, sat, isl, isl, gw]) # 单路径:2 跳星间 path2 = parallel([series([term, sat, gw]), # 双星分集 series([term, sat, gw])]) print(f"单路径可用性 {path1*100:.5f}%(年停机 {525600*(1-path1):.0f} 分钟)") print(f"双星分集可用性 {path2*100:.6f}%(年停机 {525600*(1-path2):.2f} 分钟)") # 输出: # 单路径可用性 99.86029%(年停机 734 分钟) # 双星分集可用性 99.999966%(年停机 0.18 分钟)
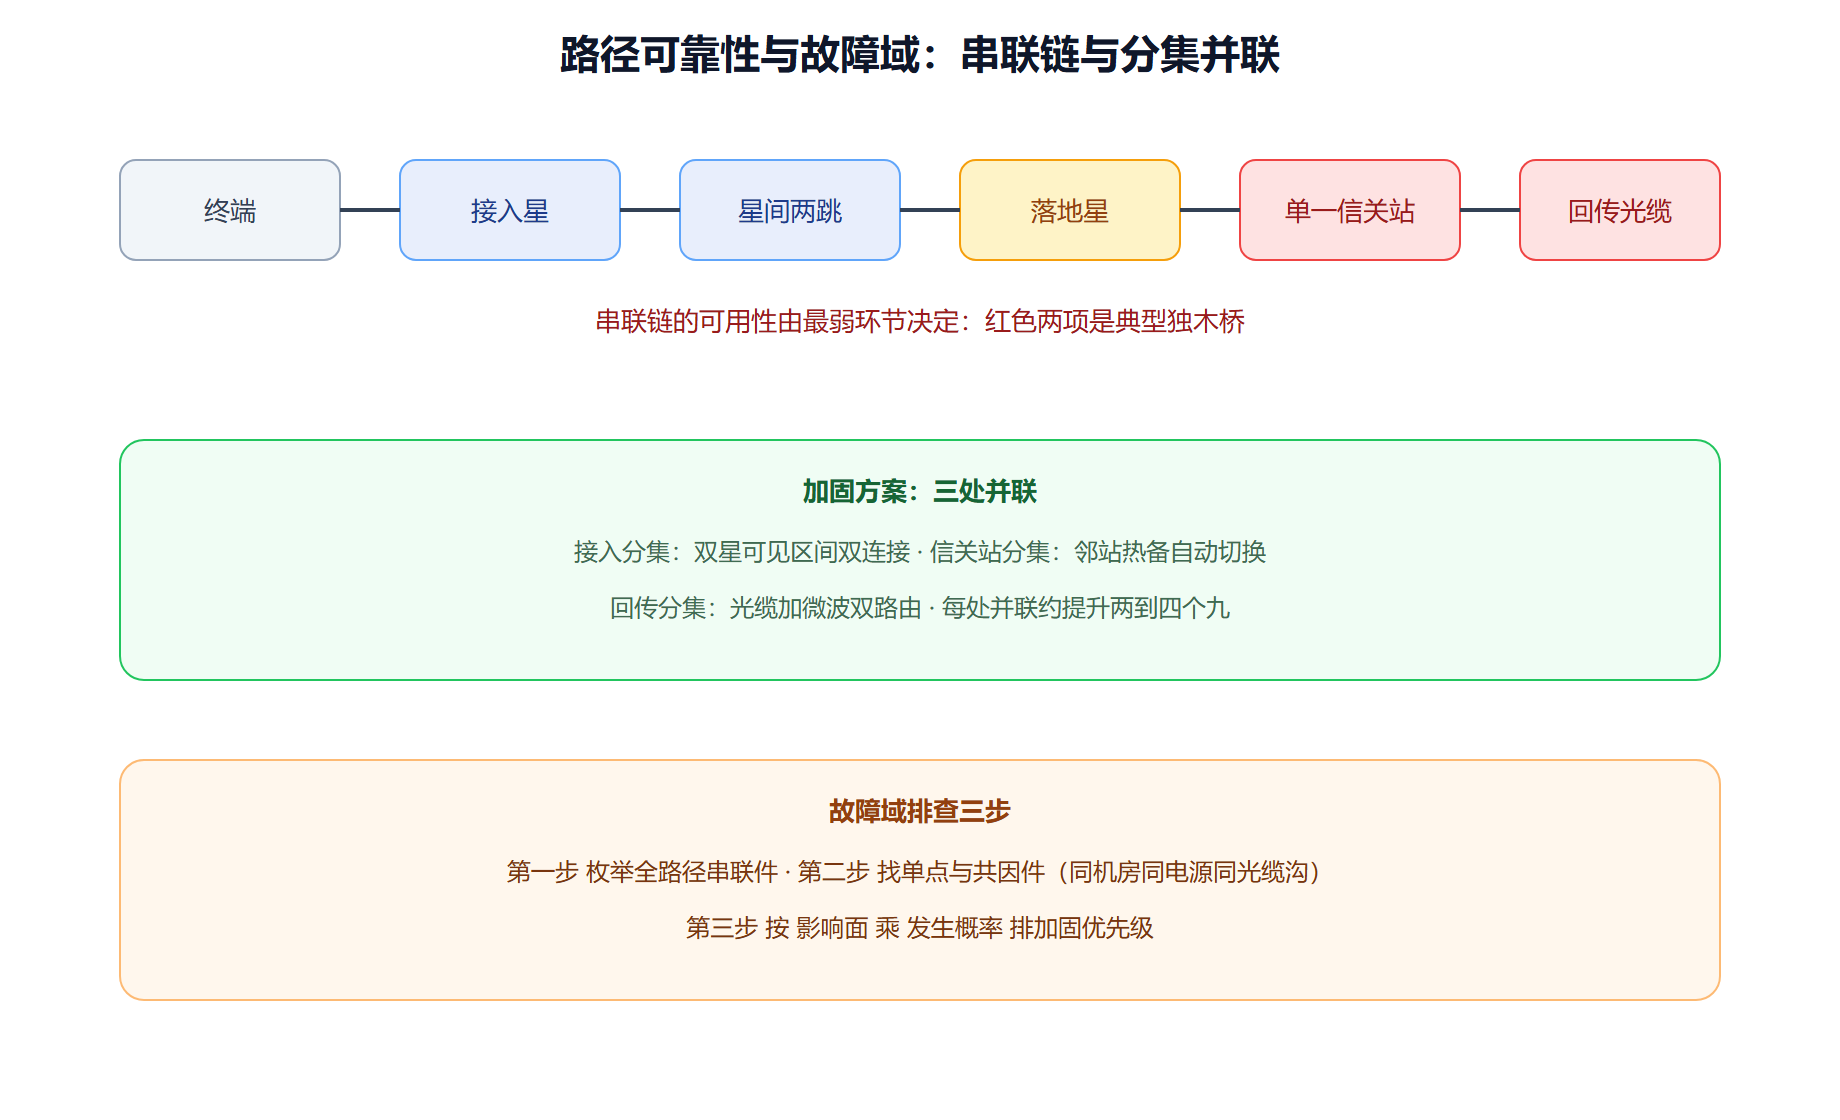
读数的震撼在于对比:单路径一年停机十二个小时,双星分集一年停机十一秒——差四个数量级,而成本只多一颗候选星的部分时频资源。这就是第 2 章"覆盖重数"在可用性维度的兑现方式:重数不是浪费,是最便宜的高可用。把同样的算术反着用就是故障域分析:找出哪些部件是"串联独木桥"——信关站回传光缆、NCC 核心、某颗必经的中继星——独木桥决定系统上限,冗余必须优先投在这里。工程上常见的独木桥包括:单一信关站服务大片区域(回传与市电都是单点)、地面站对之间的地面链路、认证系统。故障域分析的产出是一张"单点清单",清单上每一项都要么加并联、要么降依赖。
容错的三线防御
第一线在部件级:卫星设计的冗余收发机、备份行波管、交叉链路备份,单点失效星内消化。第二线在网络级:路由绕行(第 5 章快照表的增量修正)、切换分集(第 6 章)、波束互援(邻星临时接管故障星的高价值波束)。第三线在运营级:在轨备份星快速补位、地面备份信关站热待命、发射节奏本身作为容量冗余(星座按略高于需求的速率持续补星,天然形成在轨备件池)。三线各自的价格与见效速度不同,组合起来的课题就是"花多少钱买几个九"——这个问题在第 9 章会换成货币单位重问一遍。
容量与可用性是同一枚硬币:容量问"端多少碗",可用性问"掉不掉碗",覆盖重数与故障域分析是把两问统一作答的坐标系。下一章换上安保班组的制服:碗不但要端得稳,还不能被人截走。
故障域地图:把串联独木桥画出来
可用性的统计口径陷阱
"可用性几个九"必须问清统计口径,否则数字毫无意义。口径一问分母:是"全年分钟数"还是"服务时间"(计划内维护算不算停机);二问测量点:从终端测还是从信关站测(中间隔着一整段用户侧网络);三问粒度:全网平均还是单用户分布(平均数会掩盖边缘用户的糟糕体验);四问归因:卫星故障、雨衰、切换失败算不算"不可用"。同一套系统按不同口径能报出三个不同的"九"——服务等级协议谈判时,口径之争往往比数字本身更激烈。工程师的职业习惯是永远附带口径说明,这一条能避免一半的运维纠纷。
容量与可用性的联合演练题
一道把两半合起来的综合题。条件:某地区有 4 颗同时可见卫星、每星单波束容量 1 吉比特每秒、用户需求忙时 2.5 吉比特每秒、单星链路可用性 99.9%。问题一:容量够不够?名义上 4 吉比特大于 2.5,但波束调度与统计复用有约两成开销,实际可用约 3.2,勉强够但不抗增长。问题二:任一时刻全部流量只走最优单星时可用性多差?单星 99.9% 意味着年停机约九小时;若流量可分流到任意两星之一(并联),跳到四个九。问题三:把其中一颗星挪走去补邻区,容量与可用性怎么变?容量降到 2.4,跌破需求——答案是不能挪,除非同时降低该区服务承诺。这道题的教学点:容量与可用性共享同一批卫星资源,运营决策本质是在两个指标间挪预算——第 9 章的服务等级定价,定的就是这个挪动的价格。
容量规划的操作节奏
把容量账变成运营节奏:日级看波束利用率榜单(找过热波束,触发短时调度干预);周级看区域趋势(连续升温的区域启动扩容评估);月级跑需求预测(6.2 节的预测模型喂第 7 章容量公式,输出三个月窗口的扩容清单);季度对齐资本节奏(扩容清单与补射计划对表,把"加波束功率"这类软扩容与"加卫星"这类硬扩容排优先级)。节奏的关键是把容量从事后救火变成前置排程——性能工程师的理想状态是"每个过热波束在变热之前已经在扩容清单上",这个状态靠的不是预测模型多准,而是测量、预测、规划、执行四环的固定节拍。