1.2 形式语言与自动机理论
1.2 形式语言与自动机理论
本节摘要:要定义"计算",得先定义"被计算的对象"——形式语言,和"做计算的机器"——自动机。本节讲清楚 Chomsky 层级(语言按复杂度分类)和对应的自动机模型,最终引出图灵机这个"计算"的标准模型。读完你能理解为什么图灵机被当作计算的极限。
一、形式语言是什么
形式语言是字母表上字符串的集合。给定字母表 Σ(如 {0,1}),语言 L 是 Σ*(所有可能字符串)的子集。
举例:
- Σ = {0,1},L = {所有以 0 开头的串} 是一个语言。
- Σ = {a,b,c},L = {所有括号匹配的串} 是一个语言。
形式语言理论问:哪些语言能被什么样的机器"识别"(判断一个串是否属于 L)?这把"计算"具体化——计算就是机器识别语言的过程。
二、文法
文法是生成语言的规则系统。一个文法 G = (V, Σ, P, S):
- V:非终结符(变量)集合
- Σ:终结符(字母表)集合
- P:产生式规则
- S:起始符号
举例,生成"所有 a 后跟 b 的串"(即 aⁿbⁿ)的文法:
- S → aSb | ε(ε 是空串)
从 S 出发,应用规则:S → aSb → aaSbb → aab(用 ε 规则)。生成 aab,属于 aⁿbⁿ。
文法通过规则推导生成语言。不同限制的文法生成不同复杂度的语言,这就是 Chomsky 层级。
三、Chomsky 层级
Chomsky 1956 年把文法按限制程度分四类,从宽到严:
| 类型 | 文法限制 | 对应语言 | 对应自动机 |
|---|---|---|---|
| 3 型 | 右线性 | 正则语言 | 有限自动机 |
| 2 型 | 上下文无关 | 上下文无关语言 | 下推自动机 |
| 1 型 | 上下文有关 | 上下文有关语言 | 线性有界自动机 |
| 0 型 | 无限制 | 递归可枚举语言 | 图灵机 |
层级关系:3 型 ⊂ 2 型 ⊂ 1 型 ⊂ 0 型。越宽的文法生成越复杂的语言,需要越强的机器识别。
图 1-2 Chomsky 层级与自动机
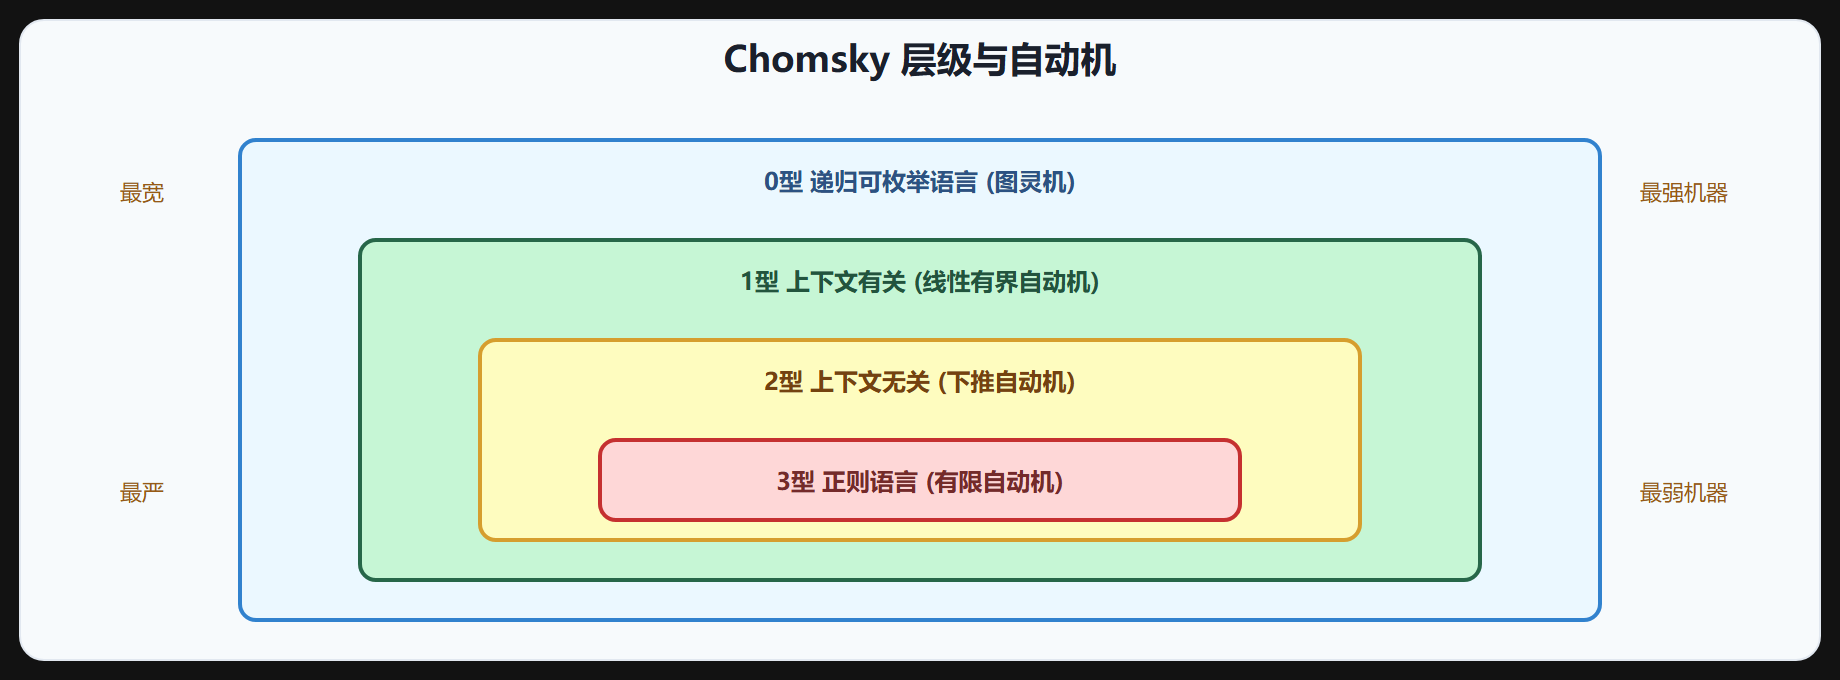
层级意义:每层语言能用对应机器识别,但不能用更弱的机器。正则语言有限自动机就够,上下文无关要下推自动机(加栈),到图灵机最通用。
四、有限自动机(FA)
最简单的自动机,只有有限状态,读输入串按转移函数切换状态,读完判断是否在接受状态。
DFA(确定性有限自动机):每个状态每个输入有唯一转移。
NFA(非确定性有限自动机):一个状态一个输入可有多个转移,或"猜测"走哪条。
DFA 和 NFA 识别能力相同(NFA 可转 DFA,状态数可能指数膨胀),都识别正则语言。
正则语言能表达什么?模式匹配、简单词法。如"所有以 ab 开头的串""所有偶数个 0 的串"。正则表达式就是正则语言的紧凑描述,grep、词法分析器用这个。
正则语言不能表达什么?需要计数的,如 aⁿbⁿ(n 个 a 后 n 个 b)不是正则语言——有限状态记不住数了多少个 a。这要用下推自动机。
五、下推自动机(PDA)
在 FA 上加一个栈,能记数。识别上下文无关语言。
aⁿbⁿ 怎么识别?读 a 时压栈,读 b 时弹栈,读完栈空则接受。栈让 PDA 能记 a 的数量,匹配 b。
上下文无关语言能表达嵌套结构,如括号匹配、算术表达式语法。编程语言的语法多数是上下文无关的,编译器的语法分析用这个。
上下文无关不能表达什么?需要上下文的,如 aⁿbⁿcⁿ(n 个 a、b、c)不是上下文无关——一个栈记 a 和 b 的关系,没法再记 c。这要用上下文有关语言。
六、线性有界自动机(LBA)
图灵机但带子长度受限(线性于输入长度)。识别上下文有关语言。
aⁿbⁿcⁿ 怎么识别?LBA 在有限带子上能来回扫描,标记和计数,能处理这种需要多个计数器的语言。
上下文有关语言是"可判定的"——LBA 总能停机(带子有限,状态有限,不会无限循环)。这是它和最宽的 0 型语言(递归可枚举)的区别。
七、图灵机
最通用的自动机,无限带子,可读写可来回移动。识别递归可枚举语言(0 型)。
图灵机是计算的"标准模型"——丘奇-图灵论题说,任何"能直观计算"的函数都能被图灵机计算。这个论题不是定理("直观计算"无法严格定义),但所有提出的计算模型(λ 演算、递归函数、图灵机)都等价,强烈支持这个论题。
图灵机能识别所有 0 型语言,但不保证停机——递归可枚举语言包括"图灵机接受则属于,不停机则不属于"的语言。要保证停机的叫"递归语言"(可判定),是递归可枚举的子集。
这个区别是可计算性理论的核心——存在递归可枚举但非递归的语言(停机问题),即"能被图灵机识别但不能被图灵机判定"的问题,这就是不可判定性。
八、从自动机到可计算性
形式语言和自动机把"计算"具体化:
- 计算就是机器识别语言的过程。
- 不同机器识别不同复杂度的语言。
- 图灵机是最强机器,识别最宽的语言(递归可枚举)。
- 但图灵机不保证停机,引出可判定/不可判定的区分。
下一章就深入图灵机和可计算性——既然图灵机是计算极限,那图灵机不能算什么?答案是不可判定问题,由对角线论证证明。
九、为什么图灵机是标准模型
为什么不用其他模型当计算标准?因为所有"合理"的计算模型都和图灵机等价:
- λ 演算(丘奇):函数式计算,和图灵机等价。
- 递归函数(哥德尔):数学式定义,和图灵机等价。
- 寄存器机、马尔可夫算法、甚至现代编程语言:都和图灵机等价。
这种"普适性"让图灵机成为标准——任何能被任何合理模型计算的,都能被图灵机计算。所以"图灵机可计算"="可计算",这就是丘奇-图灵论题。
⚠️ 常见误区:以为"图灵机是计算的唯一模型"。图灵机只是众多等价模型之一,但因为它最接近"机器"直觉且最通用,被选作标准。丘奇-图灵论题说所有合理模型等价,不是定理是经验性论题。
💡 关键直觉:Chomsky 把语言按复杂度分四级,对应四种自动机——有限(正则)、下推(上下文无关)、线性有界(上下文有关)、图灵(递归可枚举)。图灵机最通用但不停机,引出可判定/不可判定区分。所有合理计算模型等价(丘奇-图灵论题),图灵机是标准。
核心回顾
- 形式语言:字母表上字符串的集合,计算就是机器识别语言的过程。
- 文法:规则系统生成语言,不同限制生成不同复杂度语言。
- Chomsky 层级:3型正则(FA)⊂ 2型上下文无关(PDA)⊂ 1型上下文有关(LBA)⊂ 0型递归可枚举(图灵机)。
- 有限自动机:有限状态,识别正则语言(模式匹配),不能计数。
- 下推自动机:FA+栈,识别上下文无关语言(嵌套结构、语法),能计数一个量。
- 线性有界自动机:受限图灵机,识别上下文有关语言,保证停机。
- 图灵机:无限带子,最通用,识别递归可枚举,但不保证停机,引出不可判定性。
- 丘奇-图灵论题:所有合理计算模型等价,图灵机可计算=可计算,是标准定义。