2.2 判定性与可识别性
2.2 判定性与可识别性
本节摘要:不是所有图灵机能识别的问题都能被图灵机判定——这是可计算性理论的关键区分。本节讲清楚判定器(保证停机)和识别器(可能不停机)的区别、递归语言和递归可枚举语言的关系、以及为什么这个区分重要。读完你能理解"能识别"和"能判定"的微妙差别。
一、判定器 vs 识别器
图灵机对一个问题(语言)有两种"处理"方式:
判定器(Decider):对所有输入,图灵机保证停机,给出"是"或"否"。这种图灵机叫判定器,对应的语言叫可判定语言(或递归语言)。
识别器(Recognizer):对属于语言的输入,图灵机停机接受;对不属于的,图灵机可能停机拒绝,也可能永远不停机。这种图灵机叫识别器,对应的语言叫可识别语言(或递归可枚举语言)。
关键区别:判定器保证停机,识别器不保证。一个问题可判定,意味着存在判定器总能给出答案;可识别但不可判定,意味着只能识别"是"的情况,"否"的情况可能永远等不到答案。
二、递归语言与递归可枚举语言
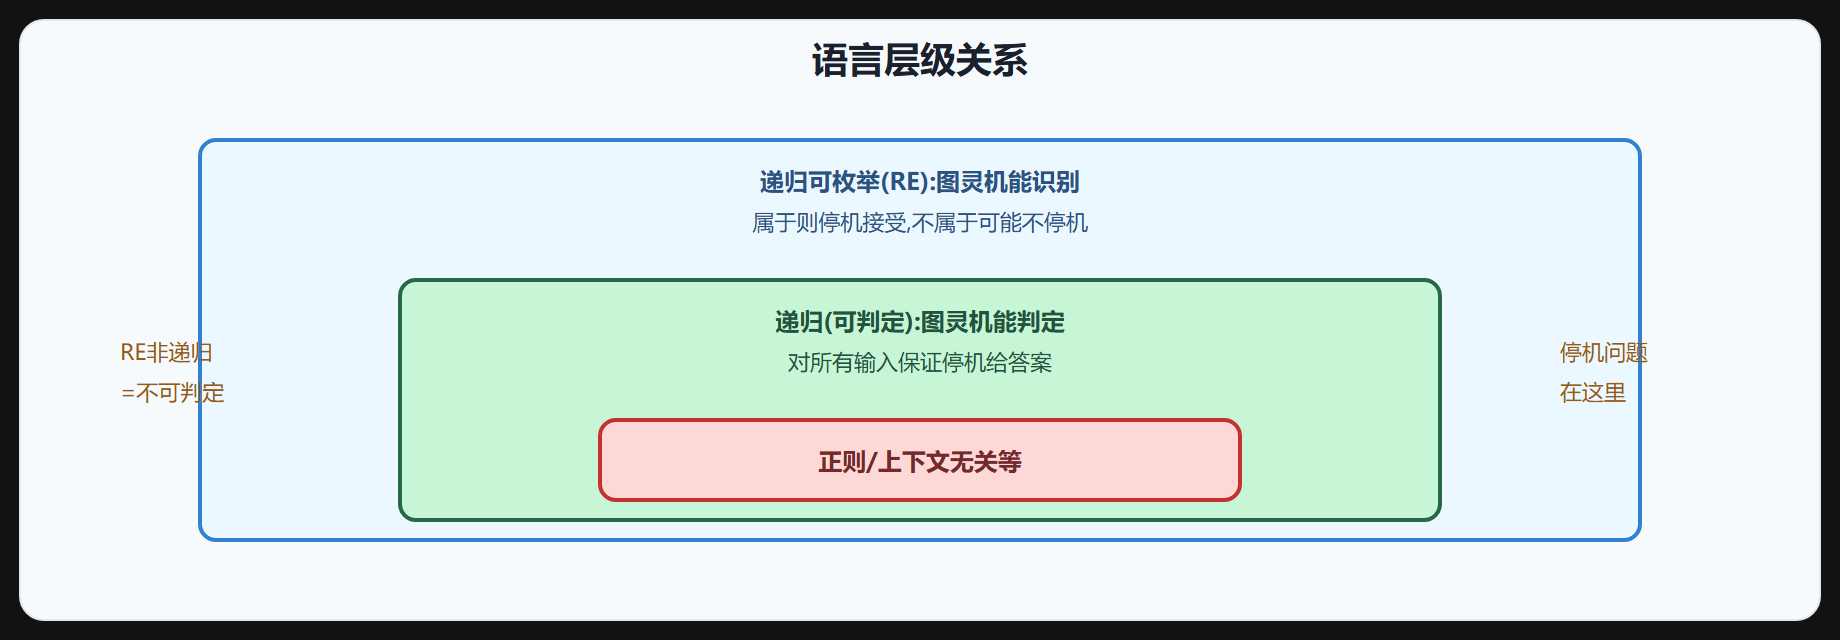
递归语言(Decidable/Recursive):存在判定器,对所有输入停机给答案。
递归可枚举语言(Recognizable/RE):存在识别器,属于则停机接受,不属于则可能不停机。
关系:递归 ⊂ 递归可枚举。所有递归语言都是递归可枚举的(判定器也是识别器),但存在递归可枚举但非递归的语言——这就是不可判定问题。
图 2-2 语言层级
三、为什么识别器不保证停机
识别器对"不属于"的输入可能不停机,这是设计使然。
举例:语言 L = {⟨M⟩ : M 是接受至少一个串的图灵机}。识别器怎么工作?枚举所有串 w1, w2, ...,模拟 M 在每个 wi 上运行。如果 M 接受某 wi,则 ⟨M⟩ ∈ L,识别器接受。如果 M 不接受任何串,识别器会一直枚举模拟,永远不停。
这个识别器对"属于"的情况会停机(找到接受的串就停),对"不属于"的情况永远不停。所以 L 是递归可枚举但不是递归——没法判定 ⟨M⟩ 是否属于 L(因为要确定"不接受任何串"得检查无穷多串)。
四、补语言性质
一个重要定理:L 是递归的,当且仅当 L 和它的补 L̄ 都是递归可枚举的。
直觉:如果 L 可判定,判定器对 L̄ 也判定(翻转答案)。如果 L 和 L̄ 都可识别,要判定 x ∈ L,同时跑 L 和 L̄ 的识别器——x 必属于一个,对应的识别器会停机,另一个不停也无所谓。所以能判定。
这个定理的推论:存在递归可枚举语言 L,其补 L̄ 不是递归可枚举的——这种 L 不可判定,且"不属于"的情况连识别都做不到(不是"可能不停机",是"根本没法识别")。停机问题的补就是这种。
五、可判定问题的例子
多数我们熟悉的问题是可判定的:
- 算术问题:判断一个数是否质数、加法、乘法,都可判定(有算法保证停机)。
- 图论问题:判断图是否连通、是否有环、是否二分图,都可判定(遍历算法)。
- 字符串问题:判断串是否匹配正则表达式、是否属于某上下文无关文法,都可判定。
- 线性代数:判断矩阵是否可逆、方程组是否有解,都可判定(高斯消元等)。
这些问题的共同点:存在明确算法,对所有输入都能在有限步内给出答案。
六、可识别但不可判定的例子
递归可枚举但非递归的语言存在,由对角线论证证明(下一节详述)。这里先给直觉:
语言 L = {⟨M, w⟩ : M 在 w 上停机}。这是停机问题对应的语言。它是递归可枚举的——识别器模拟 M 在 w 上运行,M 停机则识别器停机接受。但它不是递归的——没法判定 M 是否在 w 上停机,因为要确定"不停机"得等无穷长时间。
这种"能识别是的情况,不能判定否的情况"的问题,就是可识别但不可判定。下一节证明停机问题不可判定,就是证明它属于这类。
七、为什么这个区分重要
判定性和可识别性的区分,是可计算性理论的精髓:
- 可判定意味着问题"可解"——存在算法总能给答案。
- 可识别但不可判定意味着问题"半可解"——能确认是的情况,否的情况永远等不到。
- 不可识别意味着问题"完全不可解"——连是的情况都识别不了。
这个区分告诉我们:不是所有"能算一点"的问题都"能算到底"。存在大量半可解问题,它们能识别但不能判定,这是计算的内在局限。
八、实际意义
这个理论区分有实际后果:
- 程序分析:判断程序是否满足某性质(如不死循环、不违反内存安全),多数是可识别但不可判定——能验证满足的例子,不能判定不满足(要检查所有可能输入)。
- 类型检查:依赖类型系统(如 Coq、Agda)的类型检查可能不停机,因为类型级计算可能任意复杂。
- AI 验证:验证 AI 系统是否满足某规范,多数不可判定——能找反例证明不满足,不能证明满足。
所以理论不是空谈——它告诉你哪些问题注定没法自动判定,必须用近似、启发式、或人工。
⚠️ 常见混淆:可识别不等于可判定。可识别只保证"属于"时停机,"不属于"可能永远不停。可判定保证所有输入停机。停机问题可识别(模拟运行,停机则接受)但不可判定(没法确定不停机)。
💡 关键直觉:判定器保证停机(递归/可判定),识别器可能不停机(递归可枚举/可识别)。递归⊂递归可枚举,存在 RE 非递归语言(不可判定)。L 可判定 iff L 和补都可识别。停机问题可识别但不可判定——能确认停机,不能确认不停机。
本章回顾
- 判定器:对所有输入保证停机给答案,对应递归语言(可判定)。
- 识别器:属于则停机接受,不属于可能不停机,对应递归可枚举语言(可识别)。
- 关系:递归 ⊂ 递归可枚举,存在 RE 非递归(不可判定)。
- 补语言定理:L 递归 iff L 和补都递归可枚举;存在 RE 语言补不 RE(停机问题补)。
- 可判定例子:算术、图论、字符串、线性代数,有明确算法保证停机。
- 可识别不可判定例子:停机问题,能识别停机不能判定不停机。
- 区分意义:可判定=可解,可识别不可判定=半可解,不可识别=完全不可解。
- 实际后果:程序分析、类型检查、AI 验证多数不可判定,必须用近似/启发式/人工。