3.1 资源度量与复杂性类
3.1 资源度量与复杂性类
本节摘要:复杂性理论的核心工具是"按资源分类问题"。本节讲清楚时间/空间复杂度怎么度量、渐近分析(大 O)、复杂性类怎么定义、以及为什么用多项式作为"高效"的分界。读完你能理解复杂性类的语言和分类逻辑。
一、资源度量
复杂性理论度量算法消耗的资源,主要是时间和空间。
时间复杂度:算法在最坏情况下运行的步数,作为输入大小 n 的函数。如排序算法 O(n log n),矩阵乘法 O(n³)。
空间复杂度:算法在最坏情况下使用的额外空间,作为 n 的函数。如归并排序 O(n),原地排序 O(1)。
注意度量的是"最坏情况"——对最难输入的资源消耗。也有平均情况分析,但最坏情况更通用(不依赖输入分布假设)。
二、渐近分析:大 O
复杂度用渐近记号描述,忽略常数和低阶项,关注增长趋势:
- O(g(n)):上界,f(n) ≤ c·g(n) 对某常数 c 和大 n。
- Ω(g(n)):下界,f(n) ≥ c·g(n)。
- Θ(g(n)):紧界,同时 O 和 Ω。
举例:3n² + 5n + 7 = Θ(n²)。常数 3、5、7 和低阶项 5n 在 n 大时被 n² 主导,渐近看就是 n²。
为什么忽略常数?因为渐近分析关注"输入变大时增长趋势",常数在 n 足够大时被淹没。n² 算法在 n=1000 时比 n log n 慢,无论常数多大。
但常数不是无关紧要——实际工程中常数大的算法可能在小输入时慢。所以渐近分析是理论工具,工程要结合常数和实际输入大小。
三、多项式作为"高效"分界
复杂性理论把"多项式时间"(O(n^k),k 是常数)作为"高效可解"的分界。为什么?
1. 多项式增长温和:n²、n³ 在 n 增大时增长可控,而 2ⁿ、n! 增长爆炸。n=100 时 n²=10000,2ⁿ=天文数字。
2. 多项式对模型变化稳健:不同计算机模型(单带/多带图灵机、RAM 模型)间多项式模拟。一个模型多项式可解,另一个模型也多项式可解(可能指数不同但都是多项式)。这让"多项式可解"不依赖具体模型。
3. 多项式组合性好:多项式算法可以组合——多项式算法调用多项式算法,总时间还是多项式。这让 P 类有好的封闭性。
4. 实践对应:多数实际高效算法是多项式(线性、平方、立方),指数算法在中等输入就跑不动。
所以 P 类(多项式时间可解)被当作"高效可解"的理论对应。注意这不是绝对——n¹⁰⁰ 理论上是 P 但实践跑不动,2ⁿ⁰·⁰¹ 理论上非 P 但小输入可能可行。但作为分界,多项式是合理且实用的选择。
四、复杂性类定义
复杂性类是按资源约束分类的问题集合。
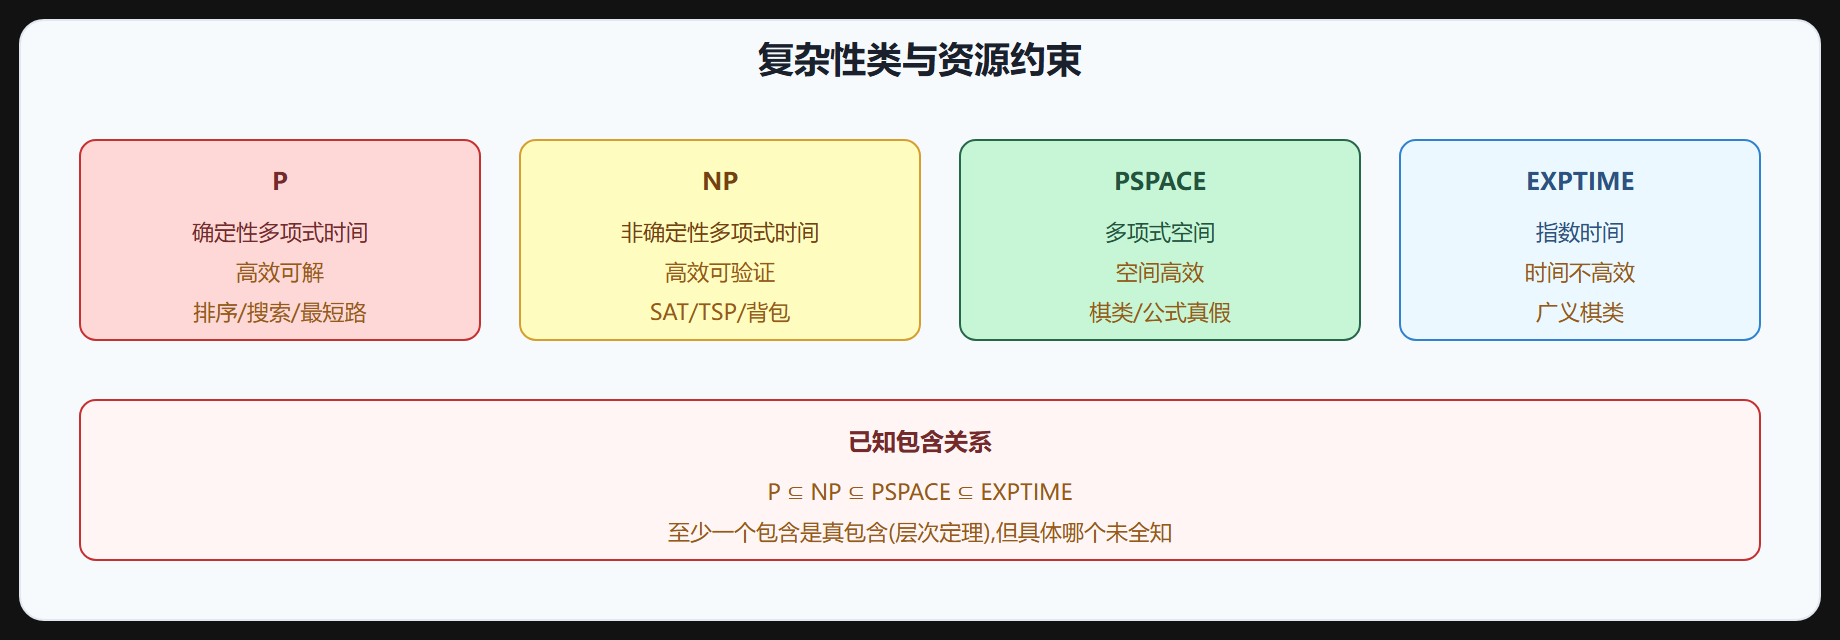
P:确定性图灵机多项式时间可解的问题。
NP:非确定性图灵机多项式时间可解的问题(等价:多项式时间可验证答案的问题)。
PSPACE:多项式空间可解的问题。
EXPTIME:指数时间可解的问题。
每个类对应一种资源约束。P 关注高效时间,NP 关注高效验证,PSPACE 关注高效空间,EXPTIME 是更宽的时间。
图 3-1 复杂性类与资源
五、确定性 vs 非确定性
复杂性理论区分确定性和非确定性计算:
确定性图灵机:每步唯一转移,"正常"的机器。现代计算机是确定性的。
非确定性图灵机:每步可能多个转移,"猜测"走哪条。它接受输入 iff 存在某条转移序列导致接受。
非确定性是理论工具——现实没有非确定性计算机。但它定义了 NP 类,对应"高效可验证":一个问题在 NP,iff 给定答案能多项式时间验证对错。非确定性机"猜"答案(走对的分支),然后多项式验证。
举例:SAT 问题(判断布尔公式是否有满足赋值)。确定性解法要枚举所有赋值(指数)。但给定一个赋值,多项式时间能验证是否满足——代入公式算真假。所以 SAT 在 NP。
六、时间层次定理
时间层次定理:更多时间能解更多问题。具体:DTIME(f(n)) ⊊ DTIME(g(n)) 当 g(n) 比 f(n) 增长快足够(如 g(n) log g(n) = ω(f(n)))。
直觉:给更多时间,能解严格更多的问题。这意味着 P ⊊ EXPTIME——指数时间能解 P 解不了的问题。
类似有空间层次定理:更多空间能解更多问题,PSPACE ⊊ EXPSPACE。
但 P vs NP 至今未解——我们不知道非确定性多项式时间是否真比确定性多项式时间强。多数相信 P ≠ NP(NP 严格大于 P),但没证明。
七、复杂度的实际意义
复杂度不只是理论——它直接决定算法可行性:
| 复杂度 | n=10 | n=100 | n=1000 | 可行性 |
|---|---|---|---|---|
| O(n) | 10 | 100 | 1000 | 总可行 |
| O(n²) | 100 | 10000 | 10⁶ | 多数可行 |
| O(n³) | 1000 | 10⁶ | 10⁹ | 中等可行 |
| O(2ⁿ) | 1024 | 10³⁰ | 10³⁰⁰ | n>30 不可行 |
| O(n!) | 10⁶ | 10¹⁵⁸ | 天文 | n>20 不可行 |
这就是为什么 P 是"高效"分界——多项式算法在合理大输入可行,指数算法在中等输入就跑不动。知道一个问题是 NP 完全(可能指数),你就不会去求精确解,转而求近似或启发式。
八、复杂度度量的一些反直觉细节
最坏情况假设并不总是最合理的。很多实际算法(如快速排序、单纯形法)的最坏情况表现很差,但平均情况极好,实践中照样大规模使用。复杂性理论默认最坏情况,是因为它不依赖输入分布假设;而平均情况分析需要明确"平均"的定义,不同定义得到不同结论,容易混乱。这个取舍值得记住:理论给的是保证,工程要的是期望。
另一个细节是"输入大小"的定义。对整数输入,习惯按二进制位数计大小,否则加法都能"多项式作弊";对图输入,按顶点数和边数计。同一个问题,换个输入编码,复杂性类的归属可能改变——比如"给定数 N 判断是否质数",若按 N 的值计大小,AKS 算法只是伪多项式而非多项式,只有按位数计才是多项式。这类编码问题在定义复杂性类时是必须说清楚的边界。
还有一点:多项式时间不意味着"实践中快",而是"资源随规模增长可控"。n 的一百次方是多项式,2 的 n 的零点零一次方不是多项式,但真实输入规模下前者几乎永远跑不动,后者可能轻松跑完。理论分界是分类工具,不是性能预测器——这是初学者最容易踩的坑,也是下一节 P 与 NP 定义里反复强调的前提。
⚠️ 常见误读:以为"多项式一定高效"。n¹⁰⁰ 也是多项式但实际跑不动。多项式是理论分界,实际还要看指数和常数。但作为分类工具,多项式 vs 指数的区分实用且稳健。
💡 关键直觉:复杂度用渐近分析(大 O)度量,多项式作为"高效"分界(增长温和、模型稳健、组合性好、实践对应)。复杂性类按资源分类:P(确定性多项式时间)、NP(非确定性多项式时间=高效验证)、PSPACE(多项式空间)、EXPTIME(指数时间)。层次定理保证更多资源解更多问题,但 P vs NP 未解。
要点速记
- 资源度量:时间复杂度(步数)、空间复杂度(额外空间),最坏情况分析。
- 渐近分析:大 O(上界)、Ω(下界)、Θ(紧界),忽略常数和低阶项关注增长趋势。
- 多项式分界:增长温和、模型稳健、组合性好、实践对应,作为"高效可解"理论分界。
- 复杂性类:P(确定性多项式时间)、NP(非确定性多项式时间=高效验证)、PSPACE(多项式空间)、EXPTIME(指数时间)。
- 确定性 vs 非确定性:非确定性"猜测"走对分支,定义 NP,对应"给定答案多项式验证"。
- 层次定理:更多时间/空间解严格更多问题,P ⊊ EXPTIME,PSPACE ⊊ EXPSPACE。
- P vs NP:至今未解,多数相信 P ≠ NP 但无证明。
- 实际意义:复杂度决定可行性,多项式在合理输入可行,指数在中等输入跑不动,NP 完全转近似/启发式。