1.1 相关不等于因果:三个层次的知识之梯
1.1 相关不等于因果:三个层次的知识之梯
本节摘要:相关不等于因果——因果推断为这句话给出了完整的数学表述。Pearl 的因果之梯(关联、干预、反事实)把"我们能回答的问题"分成三层,每层回答的问题类型不同、需要的数据与假设也不同。本节建立这套分层语言,它是全册的概念坐标系。
一、为什么"看到"回答不了"做到"
先看一个真实结构的数据现象。某电商平台的年度报表显示:使用会员制的用户年均消费额是不使用者的两倍以上,相关系数显著。运营团队据此提议加大会员补贴。但这里藏着一个没有被数据回答的问题:如果让一批本来不办会员的用户办了会员,他们的消费会涨吗?
这两类问题在 Pearl 的框架里属于不同的层级。第一类是关联(association):在观测到的数据里,会员身份与消费额如何共同变化。第二类是干预(intervention):如果我主动改变会员身份,消费额会怎样变化。观测数据无论多大,都只直接覆盖第一层;第二层需要一个额外的成分——因果假设或随机化实验。把这两层混为一谈,就是把"看到"当成了"做到"。
为什么数据量救不了这个问题?因为联合分布——统计学描述世界的全部词汇——对"会员→消费"和"消费倾向→会员"这两种相反的因果方向给出完全相同的拟合。拟合优度、交叉验证、更深的神经网络,都只能逼近联合分布本身,而因果方向的信息根本不在联合分布里。这就是为什么因果推断必须引入联合分布之外的假设。
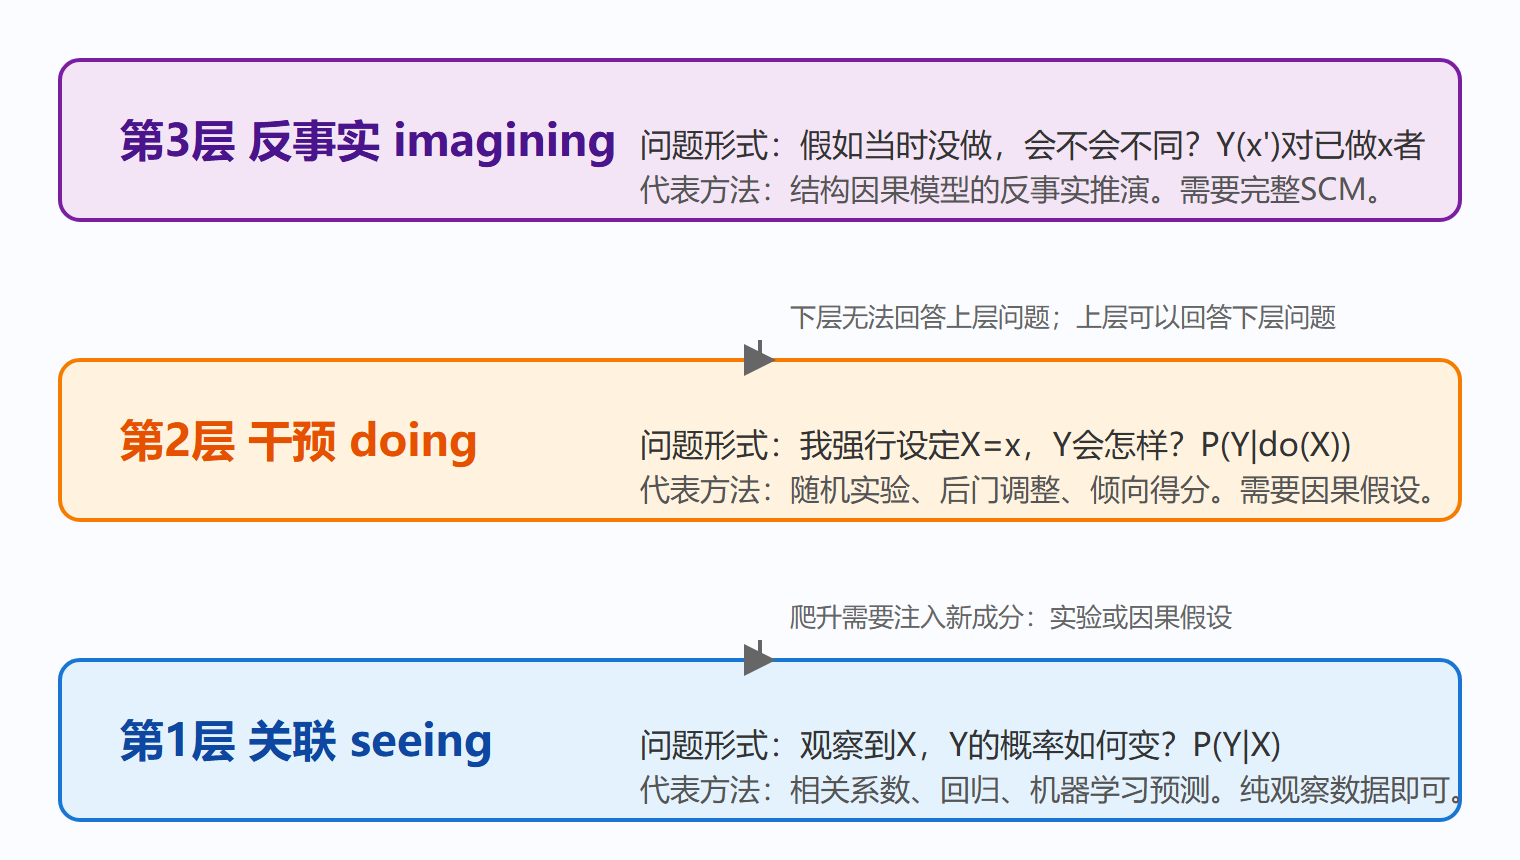
图:因果之梯三层结构
二、三层之梯各自回答什么
第 1 层,关联。 典型问题是"买了尿布的人还买什么"。注意这一层的语言全部是条件概率与相关:给定 X 的取值,Y 的分布如何。当前所有监督学习模型都生活在这层。这层的知识在推荐、风控里很有用,但一旦问题换成"把推荐位换掉会不会提升留存",就越界了。
第 2 层,干预。 典型问题是"如果我做 X,Y 会怎样"。它与第 1 层的差别可以用一个经典例子压紧:气压计读数与暴雨强相关(第 1 层成立),但把气压计指针拨到晴天刻度,暴雨照下(第 2 层不成立)。干预分布 P(Y|do(X)) 与条件分布 P(Y|X) 只有在 X 不受任何共同原因干扰时才相等——随机实验的全部意义,就是用物理随机制造这个条件。
第 3 层,反事实。 典型问题是"如果我当初没吃那片药,现在还会头疼吗"。它针对的是已经发生的单个事实去想象另一版本的世界,因此不仅要知道干预后的总体规律,还要能追溯这个个体的取值来源。反事实归因(这起事故是不是由这个操作造成的)只能在这层回答。
三、发展脉络:三个源头汇成一条河
因果之梯不是一夜立起来的。1920 年代,Fisher 在农业试验站提出随机化设计,等于用工程手段直接跳到第 2 层,却绕开了"观察数据怎么办"。1974 年前后,Rubin 提出潜在结果框架,用 Y(1)、Y(0) 把"因果效应"定义成不可直接观测但可定义的量,为观察性研究给出严格语言。1980 到 1995 年,Pearl 提出结构因果模型、因果图与 do 演算,证明三类问题构成严格层级:第 1 层数据再多也推不出第 2 层结论,而第 3 层需要第 2 层给不出的额外结构信息。三条线索——实验设计、潜在结果、结构模型——今天被视为同一学科的三种方言,本册会轮流使用它们,因为各自都有最顺手的场合。
四、常见误读与自查
⚠️ 误区一:把"控制变量后系数还在"当成因果证据。回归里放入协变量后系数稳定,只说明被控制的变量没有吸收这部分关联,不说明混杂已除尽——缺了哪个变量、多了哪个变量,要用第 2 章的因果图判断,不能用系数显著性判断。
⚠️ 误区二:把预测准等同于因果方向对。第 1 层模型完全可以用"消费额预测会员身份",方向颠倒不影响拟合。预测精度是第 1 层货币,买不到第 2 层的任何东西。
自查三问,之后每次看到"X 影响 Y"的结论都可以套用:结论处在因果之梯的第几层?它用的是什么数据(观察还是随机化)?从数据层爬到结论层,注入了哪个假设?
常见疑问与延伸辨析
问:预测模型在业务里够用了,为什么还要爬到第二层? 因为业务动作本身就是干预。模型预测"高价值用户会留存",运营据此发放权益——这个动作改变了用户环境,训练数据里的关联前提随之失效。只有第二层的知识才能回答"动作之后会怎样",这是策略类业务与预测类业务的分水岭。
问:A/B 测试不就是干预吗,为什么还要理论? 实验确实直接落在第二层,但实验答不了所有问题:伦理禁区(不能随机让人失业)、成本禁区(大规模改价实验影响营收)、长周期终点(留存以年计)。识别理论的价值是告诉你哪些问题可以不做实验、哪些必须做——它管的是实验的边界,不是替代实验。
问:反事实和干预有什么实质差别? 干预问总体规律(把 X 设为 1,Y 的分布),反事实问个体历史(这个人当时若没服药,现在如何)。前者只需要因果图加数据,后者还需要把该个体的噪声取值追溯回去,即完整的结构方程。这也是法律归因("若非该行为,损害不会发生")只能用第三层语言表述的原因。
学习自检:把三个陈述归层
把下面三句归入因果之梯的层级,可以检验本节是否真正内化:其一,"库存量与销量同向波动"(第一层,纯关联);其二,"把库存量下调一成,销量期望如何变化"(第二层,干预);其三,"上月那波促销如果没做,销量会是多少"(第三层,反事实)。归层之后追问一句"回答它需要什么数据",三层答案的差别就一目了然。
延伸:三层之梯与机器学习任务的对应
把三层语言对到日常任务上,能快速判断工具是否错配。推荐系统、风控评分、需求预测——第 1 层任务,联合分布刻画得越准越好,深度学习的主场。策略评估与实验分析——第 2 层任务,需要识别假设或随机化,DML 与因果工具的主场。归因解释与个体责任判定——第 3 层任务,需要结构方程与反事实推演,目前仍高度依赖领域建模。错配的典型症状:用第 1 层的模型直接回答第 2 层的问题(拿预测模型指导策略),或用第 2 层的平均效应回答第 3 层的个体归因。分层对应表放在团队 wiki 首页,能挡掉大半的方法论争论。
本节要点回顾
- 因果之梯:关联、干预、反事实三层,下层回答不了上层的问题,爬升必须注入实验或因果假设。
- 联合分布的盲区:因果方向的信息不在联合分布中,任何纯预测模型都无法恢复它。
- 气压计例子:P(Y|X) 与 P(Y|do(X)) 的差别是第 1、2 层的分界线。
- 三大源头:Fisher 的随机化、Rubin 的潜在结果、Pearl 的结构模型,构成现代因果推断的三种互补语言。
- 本节位置:立起全册的分层坐标系;下一节进入 Rubin 方言,给出因果效应的严格定义。