1.3 挑战与悖论:辛普森悖论与混杂初现
1.3 挑战与悖论:辛普森悖论与混杂初现
本节摘要:辛普森悖论指总体上的关联方向与各分层内的关联方向相反。本节用一份完整可复算的数字表拆解它,说明它不是统计把戏,而是权重结构的产物;并进一步指出,单靠数据无法判定该信总体结论还是分层结论——这正是引入因果图的动机。
一个能整除的辛普森数据
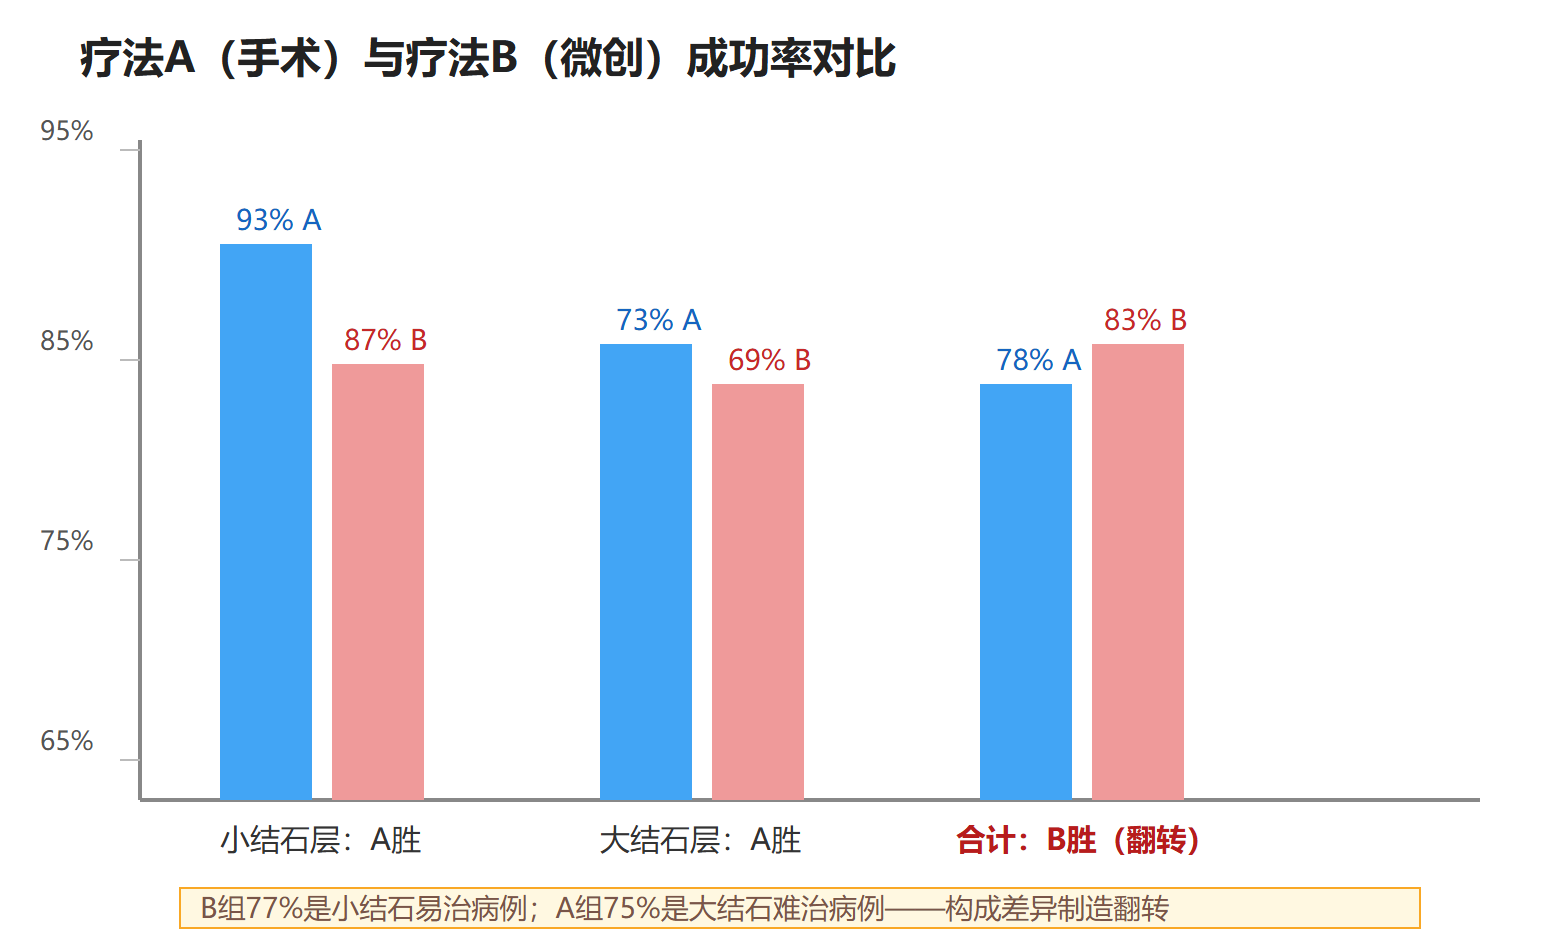
某院两种肾结石疗法,追踪 700 名患者。疗法 B(微创)在"小结石"和"大结石"两个病人组内成功率都更高,但汇总后反而更低。数字如下,每格都可手工复算。
| 分层 | 疗法 A(手术) | 疗法 B(微创) |
|---|---|---|
| 小结石 | 81/87 = 93% | 234/270 = 87% |
| 大结石 | 192/263 = 73% | 55/80 = 69% |
| 合计 | 273/350 = 78% | 289/350 = 83% |
分层内 A 赢两层,合计 B 赢。方向翻转的机制完全透明:医生倾向把病情轻(小结石、好治)的病人分给 B,把难治的大结石病人推给 A。B 组里塞满了"本来就容易好"的小结石患者,于是总成功率被抬高;A 组被难病例拖累。两组内的"病人构成权重"差异,大到盖过了真实的疗效差。
图:辛普森悖论数字结构与权重翻转
数据之外:该信哪一张表
真正的问题现在才出现:作为决策者,该给病人推荐哪种疗法?数据本身给不出答案,因为"信分层还是信总体"取决于结石大小是不是混杂因子,而"混杂因子"的判定需要因果知识:
- 若结石大小影响疗法选择、且本身影响成功率(医学上确实如此),它是混杂因子,应信分层结论:A 更好。
- 构造另一个场景:按"术后第几周出院"分层,两疗法在各层内 A 均更高,但这时分层变量本身是结果的一部分(恢复快才早出院),总体结论反而才是对的。同样形状的数据,正确的读法相反。
同一个统计结构,两种相反的决策——这是本节最想留下的印象。辛普森悖论不是要你"永远分层看",而是逼你承认:没有因果假设,连聚合方式都无法选择。数据不是中立的,聚合就是一次隐含的因果表态。
三个著名变体
伯克利录取率(1973)。 整体上男性录取率 44% 高于女性 30%,看似歧视女性;按院系分层后,多数院系内女性录取率不低于男性。翻转原因:女性更多申请竞争激烈、录取率低的院系。这里"申请的院系"扮演了结石大小的角色。事后结构分析表明分层结论更接近因果故事,但争议本身恰好说明因果判断必须来自数据之外的机制知识。
航空准点率。 某航空公司在自己主基地机场准点率更高,对手在同样机场更低,但在"全部机场"汇总后排名反转——对手飞的多是小机场(天然准点率高)。同一个机制换了个行业皮。
辛普森反转的代数条件。 用权重语言概括:设两个层内差 Δ1、Δ2 同号,但两组在各层的样本占比 p1、p2 差异悬殊,加权后总体差 = Σ w·Δ + 权重错位项。只要"层内优势小的那层占了对方样本大头",翻转就会发生。它不需要小概率巧合,只需要分配机制与分层变量相关——这正是观察性研究里无处不在的选择性。
混杂因子的三个候选定义及其漏洞
辛普森悖论把我们推到"什么是混杂因子"这个定义面前。历史上流行过三个版本,各有漏洞:
| 候选定义 | 内容 | 漏洞 |
|---|---|---|
| 关联论 | 与处理和结果都相关即是 | 对撞因子也满足,控制它反而制造偏倚 |
| 比较论 | 使粗效应与分层效应不同即是 | 只能事后发现,且对称性差 |
| 结构论 | 处理与结果的共同原因(在图中) | 需要因果图,但无歧义、可操作 |
前两个定义只依赖数据,注定兜不住对撞结构这种"数据长得像混杂、实则一控制就坏"的角色。结构论胜在无歧义,代价是必须先画出因果图。这正是下一章的全部内容:把"共同原因、对撞、中介"这些角色精确化为图上的局部形状。
⚠️ 实务提醒:看到分层反转,第一反应不该是"数据有问题",而应是"谁决定了层内构成"。在 A/B 实验里按事后变量(如是否转化)分层,几乎必然制造人为的辛普森结构——分层变量必须是处理前就确定的量。
自测与变式练习
变式一:构造一个自己的辛普森数据。 取两组各 100 人:层一处理组成功率 90%、控制组 80%;层二处理组 60%、控制组 50%。让处理组 90% 落在层二(难治层)、控制组 90% 落在层一。算总体:处理组 ≈ 0.1×0.9+0.9×0.6 = 0.63;控制组 ≈ 0.9×0.8+0.1×0.5 = 0.77。层内处理恒优 10 个点,总体反转。手工构造一遍,权重机制的印象比读十遍都深。
变式二:判断该控不该控。 电商数据中"会员身份与消费额"的关联,怀疑混杂变量候选有:注册时长、浏览活跃度、收入水平。三者都是处理前变量且同时影响入会与消费——都该进调整集候选。反之"是否使用会员专享券"是入会的后代,控制它会吸收掉部分待估效应——不该控。用第 2.2 节四问流程逐个过一遍,正好衔接下一章。
边界提醒: 辛普森悖论与"辛普森反转"并非只在分层数据出现,回归中加入与处理相关的协变量、加权样本 survey 权重变动时,系数方向都可能翻转,机制同源——权重结构变了,而权重背后是选择机制。
与辛普森机制同族的两个现象
其一伯克森悖论:只看入选样本(医院病人、录用员工、上架商品)时,两个独立变量会呈现负相关——选择条件本身就是对撞点。它与辛普森共享"条件化改变关联结构"的内核,只是一个发生在分层维度、一个发生在样本筛选维度。其二可压缩性悖论:某个分层变量使层内与总体结论一致,但换一个聚合权重(如按人头而非按院系汇总)结论仍会翻转——说明"聚合方式"本身就是未声明的分析决策。两者共同的教学意义:报告任何关联结论时,样本从哪来、按什么权重聚合,都必须和系数一起交代。
本节要点回顾
- 悖论机制:层内关联方向一致、总体反转,根源是两组在各层的构成权重错位,不是小概率事件。
- 数据无中立聚合:信总体还是分层取决于该变量是否混杂因子,而这是因果判断,数据自身无法回答。
- 变体同构:录取率、准点率等案例共享"分配机制与分层变量相关"这一骨架。
- 混杂定义之辨:关联论会被对撞因子欺骗,结构论(共同原因)才是无歧义版本——通向第 2 章的因果图。