3.1 可识别性与后门准则
3.1 可识别性与后门准则
本节摘要:识别问的是干预分布能否被观测分布唯一决定。后门准则给出最常用的图形判据:找一组节点阻断所有 X 与 Y 之间的后门路径、且不含 X 的后代,则干预分布等于对该组调整的加权和。本节给出可识别性的定义、后门准则的判定步骤清单与数值算例。
什么是"可识别"
在第 2.1 节的截断分解里我们已经见过识别的雏形:干预量被写成只含观测分布的表达式。一般化地说,因果量 Q(比如 P(Y|do(X)))在给定 DAG G 下可识别,当且仅当所有与 G 相容的 SCM 对 Q 给出相同取值——也就是说,Q 的取值只由图结构与观测分布锁定,不再依赖函数形式、噪声分布这些不可见细节。反过来,若存在两个与 G 相容的 SCM,观测分布完全相同而 Q 不同,则 Q 不可识别:再多数据也无济于事,因为数据无法区分这两个世界。
判断可识别性有通用算法(第 3.2 节的 do 演算已被证明完备),但日常九成的场景用不上全套机器——后门准则覆盖了绝大多数实际问题。
后门准则:条件与公式
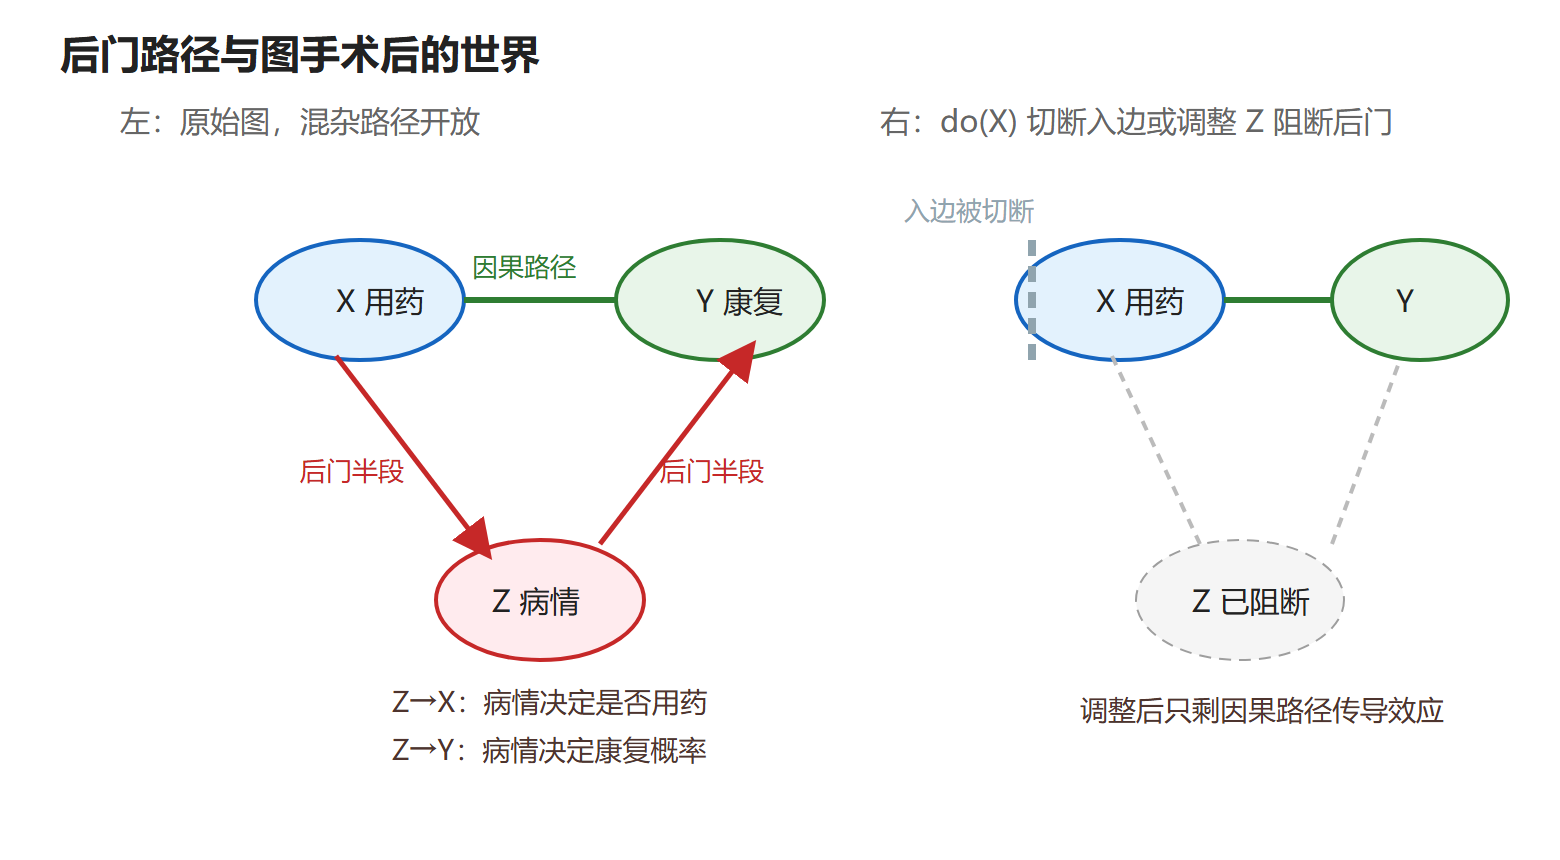
后门路径的定义:任何以指向 X 的箭头结尾的 X 到 Y 路径(X 的入边方向的路)。这类路径正是混杂的载体:它绕过因果方向、经共同原因把 X 与 Y 连起来。后门准则说:若存在变量集 Z 满足两条——(1) Z 中没有 X 的后代;(2) Z 阻断每一条 X 与 Y 间的后门路径——则干预分布可识别,且:
P(Y | do(X=x)) = Σ_z P(Y | X=x, Z=z) · P(Z=z)
这就是调整公式:按 Z 分层算组内条件期望,再用 Z 的边际分布加权。对照第 1.2 节的识别式骨架,它就是条件可交换性的图语言版本。适用要点:估 ATT 时把权重换成 P(Z|X=1)(只按处理组的构成加权);Z 不必是最小集,但多控无益——每多一个变量就多一条打开对撞的风险。
图:后门调整——阻断绕行路径
判定步骤清单
对一张给定的 DAG,按以下步骤找调整集(建议照抄进自己的工作笔记):
- 删掉因果路径:暂时忽略所有从 X 出发沿箭头方向到达 Y 的路径——后门准则管的是别的路径。
- 枚举后门路径:列出所有以箭头进入 X 的方式开头的 X—Y 路径(不管箭头方向的中途段)。
- 逐条找阻断点:对每条后门路径,找链中点、分叉中点(控制它们可断)与对撞中点(默认已断,记下哪些操作会打开它)。
- 拼最小集:选一组节点覆盖所有后门路径;检查它不含 X 的后代;检查不与任何对撞中点冲突。
- 写公式选权重:ATE 用 P(Z) 加权,ATT 用 P(Z|X=1) 加权,代入调整公式。
一个进阶例子走一遍流程。设图:X→Y,X→M→Y,U→X,U→M(U 未测),M→Y。U 是 X 与 M 的共同原因。第一步忽略 X→M→Y。后门路径有:X←U→M→Y。阻断点候选:U(未测,不可用)或 M。控制 M 行不行?M 在这条路径上是分叉中点(U 的两个结果),控制 M 可阻断。但 M 是 X 的后代——违反条件(1)吗?后门准则要求 Z 无 X 的后代,M 是后代,故严格的后门调整失败。此图其实经 do 演算仍可识别(需要更精细的分解),这正是下一节 do 演算的用武之地。这个例子同时说明:"控制中介 M"直觉上想帮 X←U→M→Y 断路,实际引入了 X 的后代作为条件,两股效应纠缠,简单分层说不清。
数值算例
接第 1.3 节肾结石数据。把分层当调整集 Z(小/大结石),调整公式给 ATE 估计:
P(康复 | do(A)) = 0.5×0.93 + 0.5×0.73 = 0.83;P(康复 | do(B)) = 0.5×0.87 + 0.5×0.69 = 0.78
这里 0.5 是因为两层各 350 人。结论 A 优 5 个百分点,与分层结论一致、与"天真总体对比"相反。注意权重的来源:调整公式的权重是 Z 在总体中的分布,而观察数据中"总体"的构成本身可能被选择过程扭曲——这就是为什么调整公式用的是目标总体的 Z 分布,而不是研究样本的。实务中目标总体与样本不一致时,还要叠加加权(第 4.2 节)。
FAQ:调整集选择的实务争议
问题:调整集选"所有处理前变量"安全吗?
不全安全。"宁多勿漏"能覆盖混杂,但每加一个变量都在赌它不是某个对撞点的后代、也不是纯预测变量(放进只增大方差)。稳妥流程:先由图推导最小充分调整集(可能不止一个),再在候选集之间按测量质量与支撑域表现挑选。图的推导在前、数据的表现在后,顺序不能反。
问题:调整公式估出来的是哪个总体的效应?
公式里的 P(Z) 决定目标总体。用研究样本的 Z 分布,估的是"与研究样本同构的人群";要推广到全国人群,把权重换成全国 Z 分布——同一个识别表达式,换权重即换总体,这是调整公式相对"回归系数"的一个被低估的优势。
问题:后门准则失败还有救吗?
有,三条路:前门(第 3.3 节)、工具变量(第 4.5 节)、或证明该图经 do 演算虽无后门形可识别(第 3.2 节末尾的例子)。全都不适用时,效应在此假设下不可识别,出路只剩改假设(并做敏感性分析)或改设计。
调整集大小的权衡速查
| 调整集选择 | 风险 | 适用 |
|---|---|---|
| 最小充分集 | 依赖图的正确性 | 图经过领域确认 |
| 全部处理前变量 | 可能引入对撞后代、方差增大 | 图不确定时的保守选项 |
| 只放强预后变量 | 残留混杂 | 数据维度高、样本小 |
| 加入处理后果 | 吸收效应或引对撞 | 仅限中介分析 |
速查表的使用方式:先由图推出最小集作为基线,再用"全部处理前变量"版本做敏感性对照,两个估计的差本身就是对"图错了多敏感"的一种诊断。若两者差距大,优先怀疑图里漏了共同原因,而不是立刻相信小的那个。
本节要点回顾
- 可识别:Q 被所有相容 SCM 赋予同一取值;不可识别时估计无从谈起。
- 后门准则两条件:Z 不含 X 后代、阻断所有后门路径;调整公式按 P(Z)(或 ATT 用 P(Z|X=1))加权。
- 五步判定清单:忽略因果路径、枚举后门、逐条找阻断点、拼最小集、写公式选权重。
- 权重语义:调整公式的权重是目标总体的 Z 分布,不是样本分布。
- 下一节:后门走不通的图(如上例),用 do 演算三规则做一般判定。