3.2 do-Calculus三规则
3.2 do-Calculus 三规则
本节摘要:do 演算由三条改写规则组成,允许在干预分布之间安全地插入、删除观测与交换干预。它是完备的:任何可识别的干预分布都能被这三条规则推出来,任何不可识别的都不能。本节给出三条规则的准确表述、使用直觉与一个完整的推导示例。
为什么需要它
后门准则好用但只覆盖一部分图形状。上一节末尾那个例子(X→M→Y 加不可观测 U→X、U→M)后门失败,直觉上却又"感觉能算"。需要一个不依赖特定图形模式的通用引擎。Pearl 在 1995 年给出 do 演算三条规则,并 conjecture 其完备;Shpitser 与 Huang 在 2006 年前后分别证明完备性。这三条规则的输入是:一张 DAG G、一个含 do 的表达式。符号记法上,G 上划线(记 G_X̄)表示删掉所有进入 X 的边,G 下划线(记 G_Z̲)表示删掉所有从 Z 出发的边。三条规则如下:
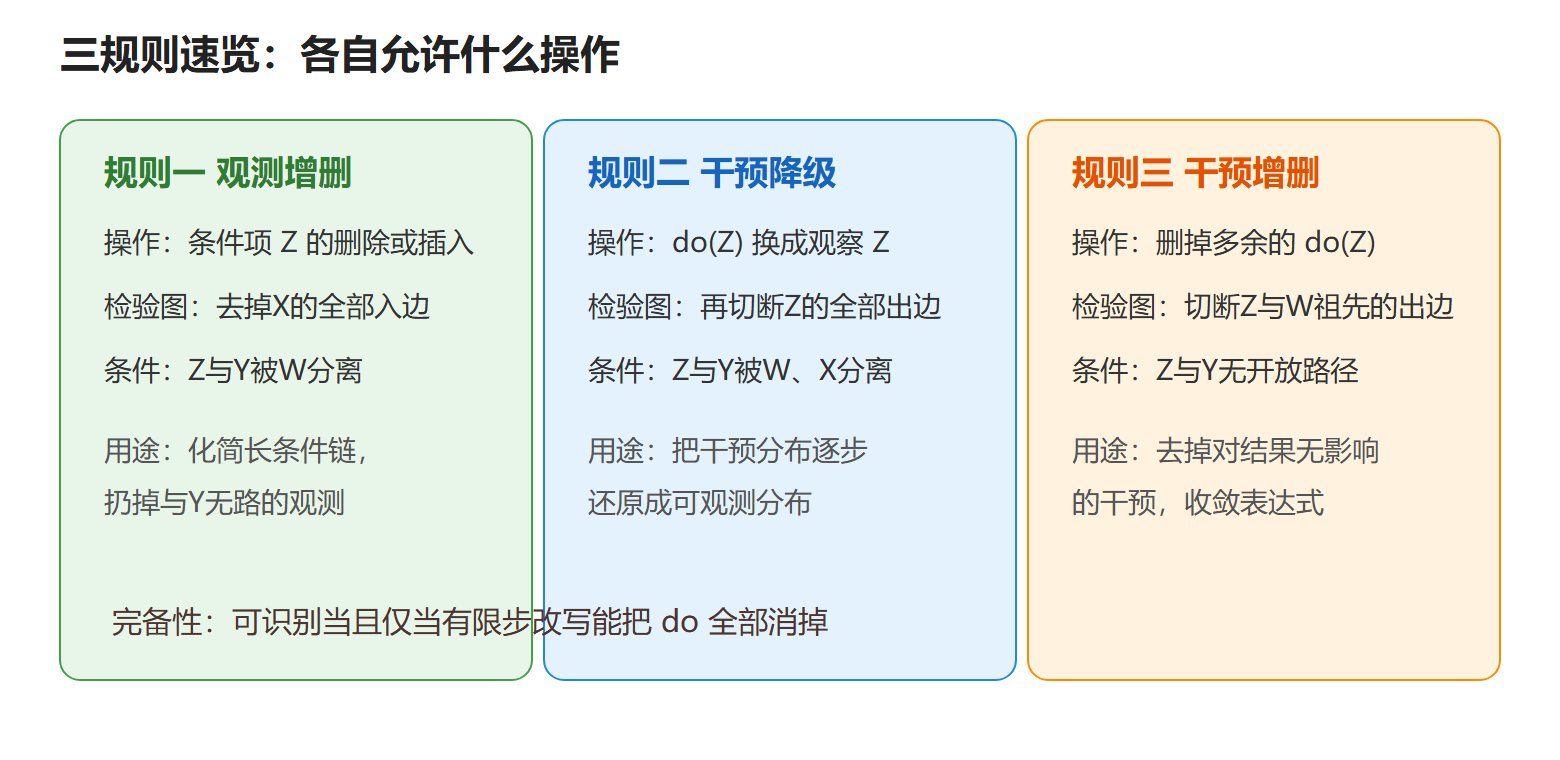
规则一(插入/删除观测):P(Y | do(X), Z, W) = P(Y | do(X), W),当且仅当在 G_X̄ 中,Z 与 Y 被 W d 分离。直觉:在切断了 X 入边的世界里,如果 Z 与 Y 本来就没有开放路径,观察 Z 不改变 Y 的分布——条件可以删。
规则二(交换观测与干预):P(Y | do(X), do(Z), W) = P(Y | do(X), Z, W),当且仅当在 G_X̄Z̲ 中,Z 与 Y 被 W 与 X d 分离。直觉:若在已干预 X、切断 Z 出边的图里 Z 与 Y 无开放路径,则"看 Z 是多少"与"把 Z 设为多少"等价——干预降级为观察。
规则三(插入/删除干预):P(Y | do(X), do(Z), W) = P(Y | do(X), W),当且仅当在 G_X̄Z(W)̲ 中,Z 与 Y 被无交集集合 d 分离,其中 Z(W) 指 W 中祖先在 Z 里的部分。直觉:如果干预 Z 不会沿任何路径影响 Y,那这个干预是空操作,可以删。
图:do演算三规则的适用要点
一个完整推导:后门准则从规则里"长出来"
后门调整公式不是独立公理,它可以用规则二与规则一推出来。以图 Z→X、Z→Y、X→Y 为例,目标 P(Y | do(X)):
第一步用规则二,把 do(X) 与表达式外的 Z 结成对。形式上引入全概率公式 P(Y|do(X)) = Σ_z P(Y | do(X), Z=z) P(Z=z | do(X))。对第二因子用规则三:在 G_X̄ 中切断 X 出边后,Z→X 已断,干预 X 不影响 Z,故 P(Z|do(X)) = P(Z)。对第一因子用规则二:在 G_X̄ 中 Z 与 Y 的路径 Z→Y 仍在(Z 出边未断),需先对 Z 干预化观察——在图 Z→X→Y、Z→Y 中,G_X̄Z̲ 切断 Z 出边后 Z 与 Y 无路径,故 P(Y | do(X), Z) = P(Y | X, Z)。合起来:
P(Y | do(X)) = Σ_z P(Y | X, Z=z) P(Z=z)
这正是后门调整公式。也就是说,后门准则是 do 演算在此类图上的最短推导路径。理解这层关系后,你可以把后门准则当"缓存":命中图形模式直接套,不命中再上通用引擎。
工程视角:识别算法的自动化
三条规则的搜索空间是指数级的,手推大图不现实。工程上用完备的多项式算法替代:ID 算法(Shpitser 2006)把图递归拆分成可识别构件,输出的不只是"能识别"的布尔值,而是一个符号表达式(可直接交给估计器)。DoWhy 的 identify_effect 内部就是这类算法;它还支持把图里允许的变体枚举出来(backdoor、frontdoor、iv 各种可识别策略),供后续估计步骤挑选。使用建议:图超过十几个节点就交给算法,人力只负责两件事——画对图(假设质量决定一切)与审阅算法输出的调整集是否符合领域直觉(不符往往是图画错了的信号)。
使用中的三个提醒
⚠️ 规则的"当且仅当"是严格的双向条件,不满足时不能"近似使用"。常见错误是在 Z 与 Y 之间只隔着一条"弱"路径时就强行套规则二——图语言没有弱边,路径要么开要么断。
💡 心法:do 演算的每一步都在问同一个问题的变体——"在动过手术的图里,信息还能从哪里流到哪里"。把 d 分离判读练到条件反射(第 2.2 节通断表),三规则就只剩排版问题。
第三个提醒关于表达式的边界:三规则只处理干预分布(第 2 层),含嵌套反事实的量(第 3 层,如自然直接效应)需要额外的公理系统,不在本章范围。
两个补充示例
示例一:对撞混杂的不可识别。 图 X←U→Y(U 未测)。目标 P(Y|do(X))。三规则走一遍:规则二要求在 G_X̄ 中切断 X 出边后 U 与 Y 分离——U→Y 仍通,不可降级;规则一无条件可删;规则三无干预可删。do 无法消去,判定不可识别。数学上的死路对应直觉:未测的共同原因之下,任何观察分布都同时兼容正、零、负的效应。这就是"识别先于估计"的终极案例——没有估计器能绕过它。
示例二:工具图的识别。 图 Z→X→Y 且 U→X、U→Y(Z 工具)。目标 P(Y|do(X)) 在无 U 时可识别;有 U 时干预分布仍不可识别(效应依 U 分布而定),但第 4.5 节将说明在效应齐性假设下比值 Cov(Z,Y)/Cov(Z,X) 可识别——额外的参数假设替代了图形可识别性。识别理论里"图不可识别 + 假设可识别"是常见组合,报告时必须把兜底假设显式写出。
用不可识别案例建立"死路感"
识别理论的另一半教育来自不可识别的图。三个最小案例值得记熟:其一,X←U→Y(U 未测)——裸混杂,do 消不去;其二,X→Y 且 U→X、U→Y,但 U 同时是 Y 的另一决定因素且分布未知——效应数值依赖 U 分布,图形上只能识别到"存在效应",数值上要参数假设兜底;其三,X→M→Y 且 U→M、U→Y(U 未测)——M 是 X 后代,后门失败,但 do 演算仍可识别(用 M 分解),这提示"死路与活路的边界比后门准则划的更靠里"。三例合起来的元教训:判定必须走完备程序(三规则或 ID 算法),肉眼直觉在边界案例上不可靠。
本节要点回顾
- 三规则分工:规则一删观测、规则二降干预为观测、规则三删无效干预;每条的合法性都由"手术图上的 d 分离"判据决定。
- 完备性:有限步改写能把 do 消光 ⟺ 可识别;不可识别的图(如裸对撞混杂 X←U→Y 且 U 未测)任何方法都无解。
- 后门是缓存:后门调整公式可由规则二、三推出,图形命中时直接套用。
- 自动化:ID 算法与 DoWhy 的识别器把搜索交给机器,人力负责画对图与审阅调整集。
- 下一节:前门准则——后门被未测混杂堵死时,最著名的绕行识别。