3.3 前门准则与标准识别策略
3.3 前门准则与标准识别策略
本节摘要:前门准则处理"混杂不可观测但中介可观测"的情形:X 的全部因果效应都流经中介 M,且 M 与 Y 之间没有混杂,则效应可识别。本节推导前门公式并配数字算例,随后盘点标准识别策略清单与选择次序,作为识别部分的收束。
前门准则:条件与公式
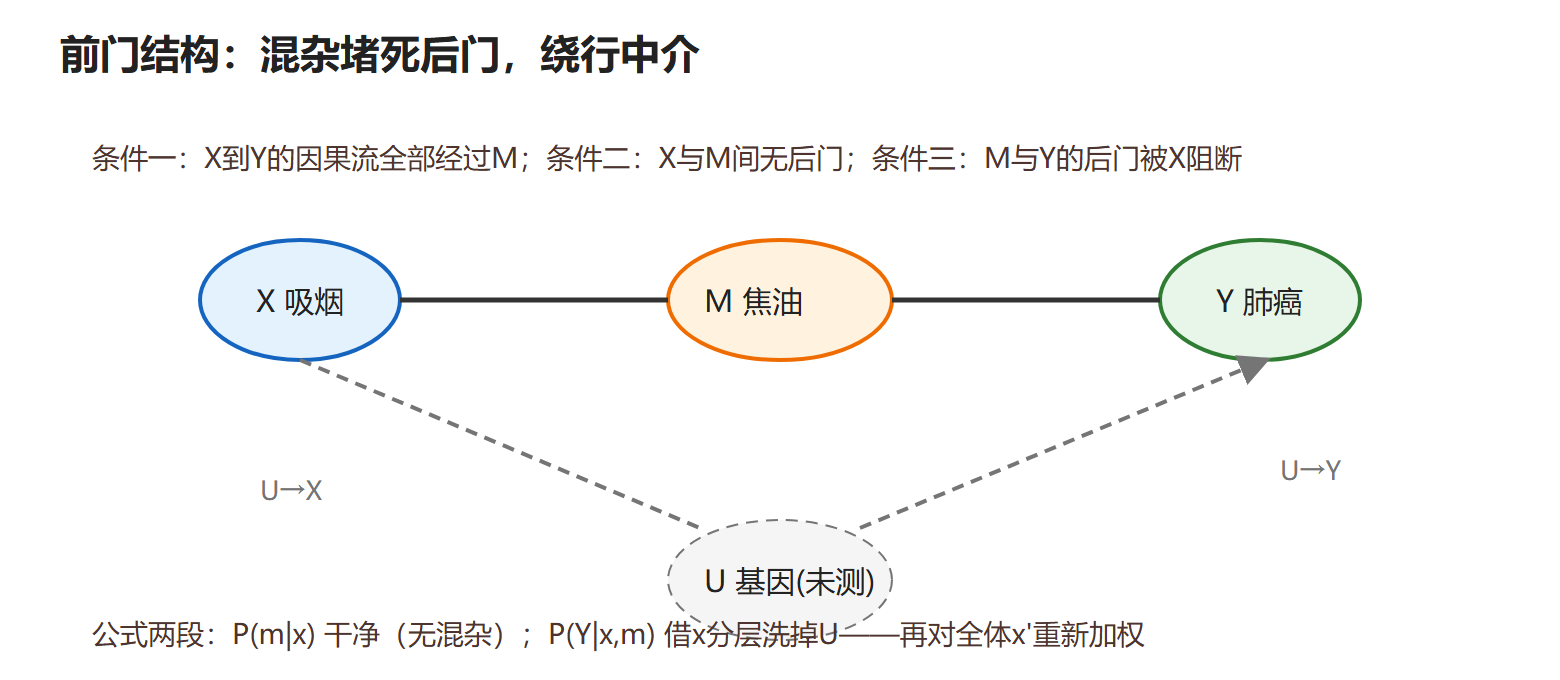
设想经典场景:吸烟(X)→肺癌(Y),不可观测的基因(U)同时影响吸烟倾向与肺癌。后门路径 X←U→Y 无法阻断(U 测不到)。但如果存在可观测的中介——比如"焦油沉积"(M):吸烟唯一影响肺癌的途径是先造成焦油沉积,且焦油沉积与肺癌之间没有未被吸烟解释的混杂——那么效应依然可识别。
前门准则的条件:(1) Z(中介集)阻断所有从 X 到 Y 的有向路径;(2) X 与 Z 之间没有未阻断的后门路径;(3) Z 与 Y 之间的后门路径都被 X 阻断。满足时:
P(Y | do(X=x)) = Σ_m P(m | x) · Σ_x' P(Y | x', m) · P(x')
图:前门准则的图形状与两段阻断
为什么公式长这样
逐段拆开前门公式的三个因子,每一项都对应一条图形论证:
第一段 P(m | x):X 与 M 之间的效应。条件二保证这条小边没有混杂,所以观察到的条件分布就是干预分布——P(M=m | do(X=x)) = P(M=m | X=x)。这段是"干净"的。
第二段 Σ_x' P(Y | x', m) P(x'):M 对 Y 的效应。M 与 Y 之间有后门 M←X←U→Y,直接观察 P(Y|m) 被污染。但这条后门全部流经 X,按 X 分层即可洗掉:P(Y | do(M=m)) = Σ_x' P(Y | x', m) P(x')。注意权重用全体 x' 的边际分布——相当于把"X 的天然分布"重新灌回去。
合成:do(X) 先改变 M 的分布(第一段),M 再以无混杂方式作用于 Y(第二段),两者相乘并对 m 求和。整个过程 U 始终在场,但它的两条通道被分段处理各自缴械。
数字算例
给一份小数据验证可复算性。设吸烟 X 为二值,焦油 M 为二值,肺癌 Y 记为发生概率。观察统计:P(M=1|X=1)=0.8,P(M=1|X=0)=0.1;P(Y=1|X=1,M=1)=0.30,P(Y=1|X=0,M=1)=0.26,P(Y=1|X=1,M=0)=0.12,P(Y=1|X=0,M=0)=0.10;P(X=1)=0.4。
先算 P(Y=1 | do(X=1)) = Σ_m P(m|1)·[Σ_x' P(Y|1... 换成代入:m=1 时 Σ_x' P(Y|x',1)P(x') = 0.30×0.4 + 0.26×0.6 = 0.276;m=0 时 0.12×0.4 + 0.10×0.6 = 0.108。合成 0.8×0.276 + 0.2×0.108 = 0.242。同理 do(X=0):m=1 概率 0.1,0.1×0.276 + 0.9×0.108 = 0.125。前门效应 = 0.242 − 0.125 ≈ 0.117。
对比观察差 P(Y|X=1) − P(Y|X=0):0.8×0.30+0.2×0.12 = 0.264 对 0.1×0.26+0.9×0.10 = 0.116,差 0.148。基因混杂把观察差抬高了约三个百分点,前门公式把它剥离。数字全可手工复算,建议自己过一遍——前门公式的"加权再回灌"结构只有算过一次才真正内化。
前门的现实约束也要说透:条件一要求"全部因果流经过 M",任何旁路(吸烟直接通过其他机制致癌)都会破坏识别——而这是不可检验的生物学断言。这正是前门准则在教科书里辉煌、在实践中罕见的原因:找得到完全中介机制的领域不多。
标准识别策略清单与选择次序
识别部分至此收束。把常用策略按"假设从弱到强"排一个次序,实际项目从上往下试:
| 次序 | 策略 | 需要的图形条件 | 典型场景 |
|---|---|---|---|
| 1 | 随机化 | do 物理实现 | 可做实验(第 4.1 节) |
| 2 | 后门调整 | 存在可测调整集 | 协变量齐全的观察数据 |
| 3 | 前门调整 | 完全可测中介且无旁路 | 中介机制清晰的领域 |
| 4 | 工具变量 | 存在强工具(第 4.5 节) | 有外生变动源 |
| 5 | 断点回归 | 处理由断点规则决定(第 4.4 节) | 政策门槛场景 |
| 6 | do 演算/ID 算法 | 任意图的一般判定 | 复杂图兜底 |
不可识别时的出路只有三类:加假设(代理变量、敏感性分析定量其影响)、改设计(找工具变量或断点)、做实验。识别理论的价值正在于它把"还能不能算"变成可在图上检查的确定性问题,而不是统计显著性的玄学争论。
FAQ:前门的使用边界
问题:中介测量有误差,前门会怎样?
系统性地衰减。P(m|x) 的测量误差使第一段因子失真,且偏倚不随样本量消失。中介分析对测量质量的敏感度高于后门调整——这是前门在问卷类数据上罕见的第二个原因(第一个是完全中介假设)。
问题:前门和工具变量像在哪、差在哪?
两者都用一个"干净通道"绕开混杂:前门用中介(处理的原因侧通道),IV 用外生工具(处理的决定侧通道)。差别:前门识别的是总效应(经中介的全部效应),IV 识别的是 LATE(受工具推动者的效应);前门要求中介完备,IV 要求排他性。图上看,两者恰是镜像结构——把前门图的中介箭头反向就得到 IV 图的骨架。
问题:同一张图既满足前门又有可测后门,用哪个?
优先后门:假设更弱(不要求完全中介)、估计更直接。前门是无路时的备选,不是并列首选——识别策略表(本节末)的次序正是这个逻辑。
前门公式的记忆挂钩
公式容易忘,挂钩记三步:第一步问"X 怎么动 M"——P(m|x),这一段天然干净;第二步问"M 怎么动 Y"——被 X 污染,所以借 X 分层洗一遍再回灌 X 的真实分布 Σ_x' P(Y|x',m)P(x');第三步串起来按 m 加权求和。三问对应三因子,方向感比死记符号可靠。同理后门公式记两步:先分层洗(P(Y|x,z)),再回灌目标总体的权重(P(z))。两个公式的共同骨架——"洗掉污染、回灌分布"——其实是所有识别策略共享的语法,连第 4.5 节的 IV 比值估计也可以读成"用 Z 洗、按 Z 的变异灌"。
本节要点回顾
- 前门三条件:中介阻断全部因果流、X 与 M 无混杂、M 与 Y 的后门被 X 阻断;公式两段各洗掉一半污染。
- 算例结构:0.117 的前门效应与 0.148 的观察差对照,混杂剥离量可复算。
- 实践稀有性:条件一是不可检验的领域断言,限制前门的适用面。
- 策略次序表:随机化→后门→前门→工具变量→断点→ID 算法,从上往下试;不可识别时改设计而非改估计器。
- 下一章:识别公式到手,进入估计——从随机实验的金标准开始。