4.1 随机化实验与ATE
4.1 随机化实验与 ATE
本节摘要:随机化通过物理随机切断处理分配与一切潜在结果的关联,使组间差成为 ATE 的无偏估计。本节讲清随机化在图与潜在结果两种语言下的机制、标准误与检验、不依从与减员两大现实破坏因素,以及 ATE 估计量的直接实现。
随机化到底买到了什么
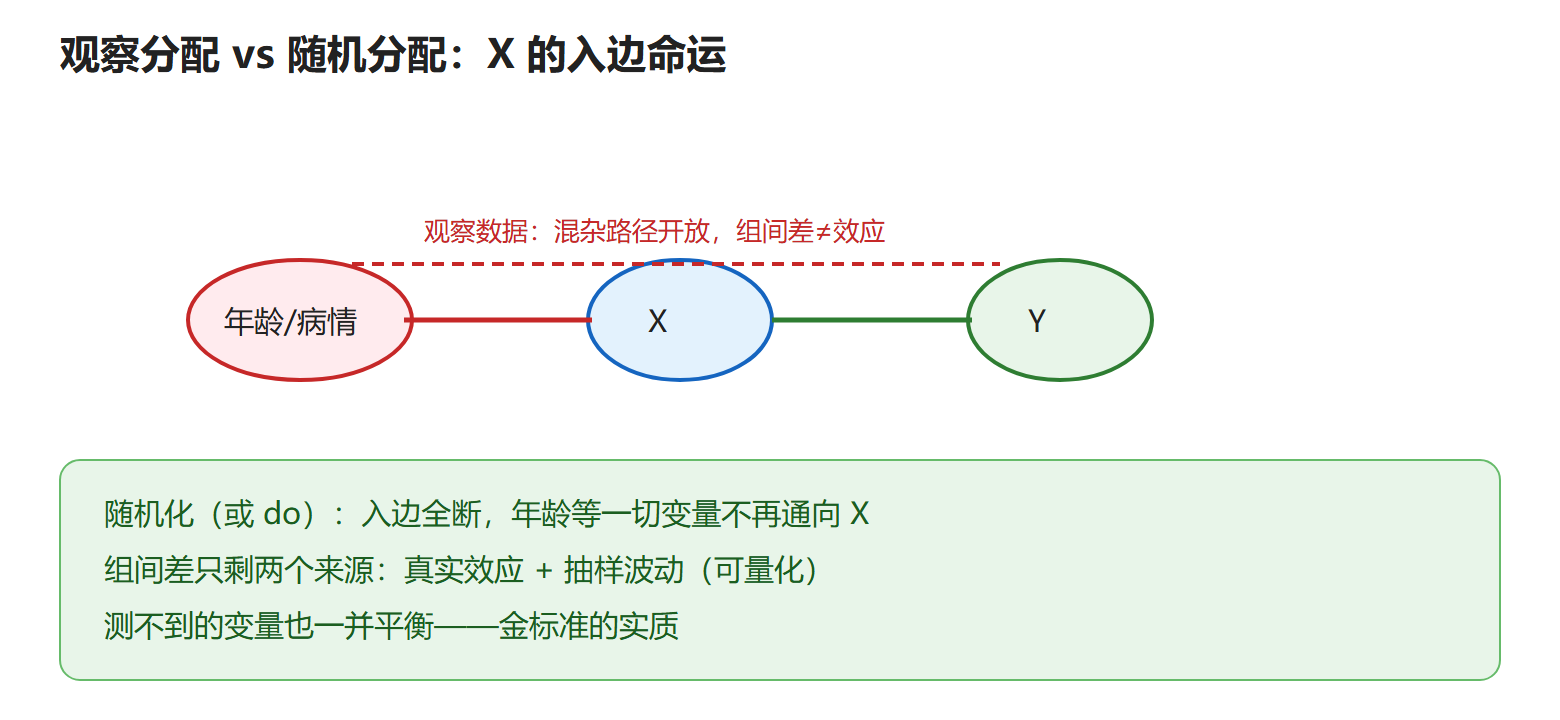
回到第 1.2 节的可交换性假设 (Y(1),Y(0)) ⊥ X。观察数据里它几乎从不成立——决定"谁接受处理"的因素几乎总是也与结果相关。随机化做的事情只有一件:把 X 的决定权从人交给随机数发生器。在因果图上,这意味着 X 的所有入边被物理切断,任何变量都无法通过"影响谁进处理组"来与 X 建立关联路径;在潜在结果语言里,分配机制与潜在结果独立,可交换性由构造成立。
于是处理组均值减控制组均值:
τ̂ = Ȳ₁ − Ȳ₀
就是 ATE 的无偏估计。无偏的含义值得钉死:不是每个样本都给对答案,而是估计误差只来自抽样波动、不来自系统偏倚。抽样波动多大由标准误刻画:SE(τ̂) = √(s₁²/n₁ + s₀²/n₀)。这个量随样本量按平方根速度收缩——想要把置信区间砍半,样本要翻四倍。这是实验设计中预算谈判的核心数学。
随机化的三件赠品也值得列全:无混杂(上面说的)、可用大样本理论做精确推断、协变量在两组间自动平衡(不但测得到的平衡,测不到的也平衡——这是观察性方法永远给不了的)。最后一条正是"金标准"称号的真正来源。
图:随机化的图手术解释
估计与推断的完整流程
用一个可复现的概念实现走全流程。设真实 ATE = 2.0,样本 400,模拟一个 RCT:
import numpy as np rng = np.random.default_rng(11) n = 400 age = rng.normal(50, 10, n) # 协变量,与分配无关 X = rng.integers(0, 2, n) # 随机分配 Y = 2.0 * X + 0.05 * age + rng.normal(0, 3, n) t1, t0 = Y[X==1], Y[X==0] tau = t1.mean() - t0.mean() se = np.sqrt(t1.var(ddof=1)/len(t1) + t0.var(ddof=1)/len(t0)) print(round(tau,3), round(se,3)) # 典型输出约 tau≈2.1, se≈0.31 → 95%CI 约 [1.5, 2.7],覆盖真值 2.0
推断的常规武器:大样本下 τ̂/SE 近似标准正态,给置信区间与 p 值;小样本或偏态结果改用置换检验(不断重洗分配标签,看观察差在随机分布中的位置——它不依赖正态假设,且直接模拟了"随机化"这个数据生成动作本身)。功效计算是设计的另一半:给定最小可检测效应 δ 与显著性水平 α,所需每组样本量近似 n ≈ 2(z_{α/2}+z_{β})²σ²/δ²。σ 通常来自历史数据;δ 应由业务意义而非"上次的效应量"决定。
金标准的裂缝
不依从(noncompliance)。 分配了处理却没吃药。直接按实际服药分组会重新引入自选择(谁不依从与预后相关),退回观察研究。规范做法是按分配分组(意向处理分析 ITT),估的是"分配的效应"而非"服药的效应";后者需结合依从率做工具变量修正(第 4.5 节的 IV 天然适用于"分配"这个随机工具)。ITT 与 per-protocol 的选择不是口味:政策推广类问题报 ITT,临床疗效问题两者都报并说明差距。
减员(attrition)与缺失。 随机化保证的是"入组时"可比,如果处理后两组流失机制不同(副作用大的退出多),可比性被破坏。这本质是"对结果的选择",处理与分析前先比较流失率的组间差异,必要时用边界分析或逆概率加权补。
随机化的边界情形。 有些变量物理上无法随机(性别、种族、国籍),有些随机化不合伦理(已知有害的暴露),有些单位过大无法随机(城市级政策)——分别是工具变量、断点回归、整群随机与双重差分的入场券。第 4 章后续各节正是沿着这些"随机化做不到"的裂缝展开的。
一个容易忽略的设计细节:分层随机化
完全简单随机在小样本里可能碰上"处理组恰好年龄偏大"。分层随机化先按关键预后因素分层、层内再随机,保证重要协变量严格平衡。注意统计推断要反映分层设计(用分层模型或至少把分层变量放进回归),否则标准误会被高估。在线实验里对应的做法是按用户分桶与按地域分层,原理相同。
FAQ 与设计速查
问题:为什么随机化后还要做协变量调整回归?
两个原因:一是降低方差——把强预后变量放进回归吸收掉部分结果变异,标准误缩小(协变量调整RCT是标准做法,即使组间本已平衡);二是修正小样本下的偶然不平衡。注意调整的是精度不是偏倚,这与观察研究的调整有本质区别。
问题:整群随机的代价怎么算?
设计效应 DEFF ≈ 1 + (m−1)ρ(m 为群均规模,ρ 为群内相关)。班级干预 m=30、ρ=0.05 时 DEFF ≈ 2.45——有效样本量缩水到四成,预算必须提前按此放大。忽略 ρ 的教育类实验显著性与否完全两说。
问题:如何快速评估一个 A/B 实验的功效?
三条信息:基线转化率 p、最小关注提升 δ、日流量。近似公式每组样本 n ≈ 16·p(1−p)/δ²(对应 80% 功效、5% 水平的速算)。基线 5%、想检出 1 个绝对点提升:n ≈ 16×0.0475/0.0001 ≈ 7600 每组。流量不够就得延长期限、提指标灵敏度或换更大杠杆的变体。
实验预注册的最低字段
工程团队跑实验前应固定的字段清单:假设句(改变什么、期望什么、为什么);核心指标(唯一)与护栏指标(若干,如延迟、投诉);最小可检测效应与功效计算;分组单元与随机方式(含分层变量);实验时长(覆盖完整周期波动,至少一个业务周期);停止规则(何时提前叫停);分析模型(含协变量调整与否)。清单的价值不在于文档本身,而在于把"事后挑好看的指标"这条路堵死——多重比较与选择性报告对可信度的伤害,比样本量不足更隐蔽。
本节要点回顾
- 机制:随机化切断 X 的全部入边,可交换性由构造成立,组间差无偏估计 ATE。
- 精度:SE = √(s₁²/n₁ + s₀²/n₀),误差按平方根收缩;功效公式决定样本预算。
- 赠品:测不到的协变量也平衡,这是金标准的实质。
- 裂缝:不依从用 ITT,减员破坏入组可比性,伦理与单位限制催生自然实验家族。
- 下一节:不能随机时第一步——匹配与倾向得分。