4.2 匹配与倾向得分:PSM与IPTW
4.2 匹配与倾向得分:PSM 与 IPTW
本节摘要:倾向得分 e(Z)=P(X=1|Z) 把多维协变量压缩成一个标量,条件于它即可实现"伪随机化"。本节给出 PSM 的完整参数流程(估计、共同支撑、匹配算法、卡钳、平衡诊断)与 IPW 的加权公式、Hájek 修正与极端权重的处理,并说明两者与回归调整的适用边界。
一维化的洞察
后门调整要求按 Z 分层,Z 有 20 个协变量时层内样本瞬间耗尽。Rosenbaum 与 Rubin 在 1983 年证明的关键定理化解了维度灾难:如果给定 Z 可交换,那么给定倾向得分 e(Z) 也可交换。直觉是:决定"谁进处理组"的全部信息已经被 e(Z) 压缩完毕,两个 e 值相同的人,进入处理组的概率相同,相当于各自经历了抛硬币。于是调整只需按一个标量分层/匹配/加权。
倾向得分本身用任何分类器估计(logistic 回归最常见,梯度提升在非线性强时更准),但要注意估计的目的:不是预测分配越准越好,而是让匹配后协变量平衡。预测精度与平衡诊断可能背道而驰——这被称为预测赢平衡输的悖论,所以模型选择以平衡为准绳(见后文诊断)。
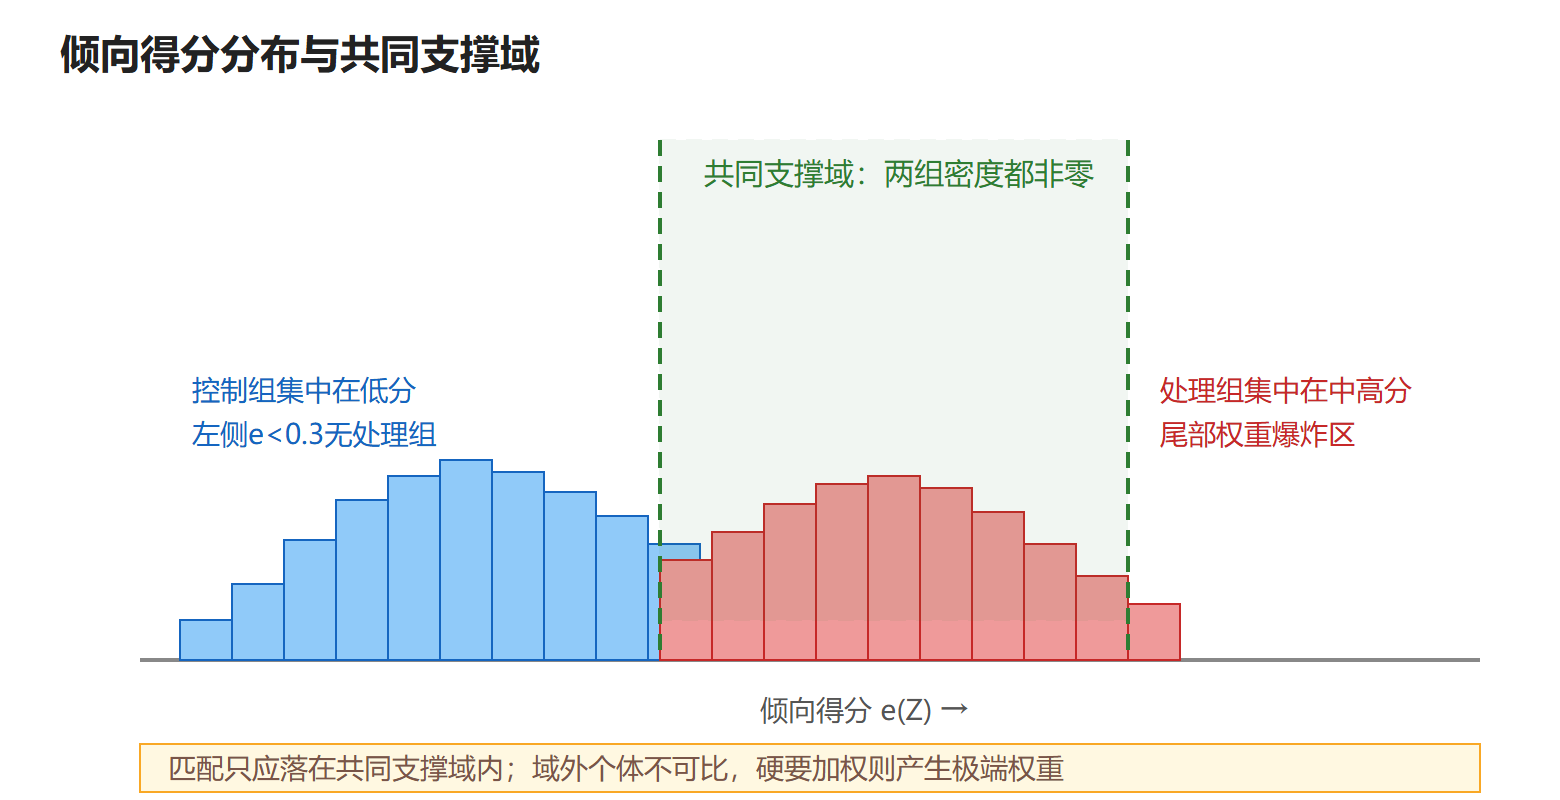
图:共同支撑域与匹配示意
PSM 完整参数流程
第一步:估计倾向得分。 logistic 回归 e(Z) = 1/(1+exp(−Zβ)),协变量选入的原则是"影响处理分配或结果的变量都放",只影响分配不影响结果的可放可不放(放了不省方差)。
第二步:检查共同支撑域。 画出两组得分的重叠直方图。左端只有控制组、右端只有处理组的区域是不可比的——要么截断样本(估 ATT 时天然只剩处理组的支撑域),要么承认目标总体变化并明确声明。
第三步:选择匹配算法与参数。 近邻匹配:1:1 或 1:k;有放回(bias 小、依赖复杂度)或无放回;卡钳(caliper):两个得分的 logit 差不超过 0.2 倍标准差是常用经验值,超出的丢弃。半径匹配与核匹配是近邻的平滑版。
第四步:平衡诊断(比模型调参更重要)。 匹配后逐协变量比较标准化均值差 SMD = (x̄₁−x̄₀)/√((s₁²+s₀²)/2),经验线 |SMD| < 0.1 视为平衡;达不到就回到第一步改模型(加交互项、换算法),而不是换更宽的卡钳硬凑。
第五步:估效应与推断。 匹配样本上算组间差;标准误需考虑匹配的不确定性(自助法或按匹配对聚类)。
IPW:加权而不是丢弃
逆概率加权走另一条路:不配对,直接给每个人赋权——处理组权重 1/e(Z),控制组权重 1/(1−e(Z))。加权后的伪总体里,处理分配与协变量独立。ATE 估计量 τ̂ = Σ X·Y/(n·ê) − Σ (1−X)·Y/(n·(1−ê))。极端权重(ê 靠近 0 或 1)会让方差爆炸,两道保险:Hájek 修正(权重自归一化,分母用权重和)与权重收缩(winsorize 或 overlap 权重,后者给两组权重都限制在有界区间,同时把目标量变为重叠区上的效应)。
PSM 与 IPW 的取舍可总结成三句话:PSM 丢掉支撑域外样本、估计更"局部"(近 ATT),诊断直观;IPW 用全部样本、效率高,但极端权重是常态风险;两者结论应当交叉验证——分歧大通常意味着支撑域问题或模型错设。与回归调整的关系:回归是"在模型内插值",支撑域外的外推由函数形式兜底;加权是"在数据范围内重新堆质量"。实践里叠加使用(加权回归、增广 IPW——见下节 AIPW)是稳健性的免费午餐。
概念代码:从得分到诊断
# 概念流程:估计 → 加权 → 平衡检查(示意,省略数据准备) from sklearn.linear_model import LogisticRegression import numpy as np e = LogisticRegression().fit(Z, X).predict_proba(Z)[:, 1] # 倾向得分 w = np.where(X == 1, 1.0/e, 1.0/(1.0-e)) # 逆概率权重 w = w / w.mean() # Hájek 型归一 tau_ipw = np.average(Y[X==1], weights=w[X==1]) - np.average(Y[X==0], weights=w[X==0]) # 诊断:加权后逐协变量 SMD 应全部落到 ±0.1 内 for j in range(Z.shape[1]): z1w = np.average(Z[X==1, j], weights=w[X==1]); z0w = np.average(Z[X==0, j], weights=w[X==0]) v1 = np.average((Z[X==1, j]-z1w)**2, weights=w[X==1]); v0 = np.average((Z[X==0, j]-z0w)**2, weights=w[X==0]) smd = (z1w - z0w) / np.sqrt((v1 + v0) / 2) print(f"协变量{j} SMD={smd:+.3f}")
⚠️ 两个高频翻车点:其一,倾向得分模型追求预测 AUC,把只影响结果的强预后变量排除在外,导致平衡失败——入模标准看因果角色,不看预测增益。其二,匹配后样本量骤降却不重新声明目标总体,把 ATT 悄悄当 ATE 汇报。
FAQ:PSM 常见质疑的回应
问题:倾向得分匹配被计量学界批评过,还能用吗?
能,但要清楚批评的靶点。King 与 Nielsen 的批评聚焦"匹配后继续用倾向得分做平衡诊断与后续分析"的做法(得分上平衡不等于协变量上平衡,且匹配在得分维度上做可能放大模型依赖)。正确姿势:得分只用于配对,配对成功后丢开得分,逐协变量查 SMD、逐协变量做结果分析。丢弃与保留也要报告(King 版的cem 粗化精确匹配是替代方案)。
问题:1:1 匹配丢了大量控制组,浪费吗?
不一定。多匹配(1:k,k=2~4)能降方差,但每个匹配对的质量下降;卡钳收紧同理。经验:k 取 2-4 之间试几档,报告效应对 k 的敏感性。若控制组比处理组大数十倍且支撑良好,全样本的 IPW 通常比 1:1 匹配更有效率。
本节要点回顾
- 核心定理:条件于倾向得分即可条件可交换,多维调整一维化。
- PSM 五步:估计得分、查支撑域、选匹配参数(卡钳 0.2 倍 logit 标准差)、平衡诊断(SMD<0.1)、效应与推断。
- IPW 要点:ATE 权重 1/e 与 1/(1−e),Hájek 修正与 overlap 权重控方差。
- 取舍:PSM 局部直观、IPW 全样本高效,结论交叉验证;叠加使用更稳健。
- 下一节:高维协变量下把倾向得分与结果模型都交给机器学习——双重机器学习。