4.6 敏感性分析与稳健推断
4.6 敏感性分析与稳健推断
本节摘要:敏感性分析回答"未测混杂要强到什么程度才能推翻当前结论",把不可检验的无混杂假设转化为可量化的稳健性陈述。本节讲 E-value 的定义与计算、Rosenbaum 敏感性框架在匹配设计上的用法、负控与安慰剂检验两类稳健性证据,以及推断中的多重比较与聚类问题。
把"怕混杂"变成一个数
前几节的方法都建立在某条不可检验假设上(无未测混杂、工具排他性、断点连续性)。传统做法是论文结尾一句"残余混杂可能存在"——这句话信息量为零。敏感性分析的立场相反:假设不一定对,那就问它得多不对才翻案。
E-value(VanderWeele 与 Ding,2017)针对"处理与结果的风险比 RR"类估计。定义:能把观察到的 RR 压缩到无效线(或可信区间边界)所需的未测混杂与处理、与结果之间风险比的最小几何均值:
E-value = RR + √(RR·(RR−1)) (RR>1 时;RR<1 先取倒数)
含义直白:存在一个未测混杂 U,它与处理的风险比、与结果的风险比同时达到 E-value 这个水平且方向相反,才能把效应完全解释掉。E-value 越大,结论越抗打。
图:E-value 曲线与结论稳健性
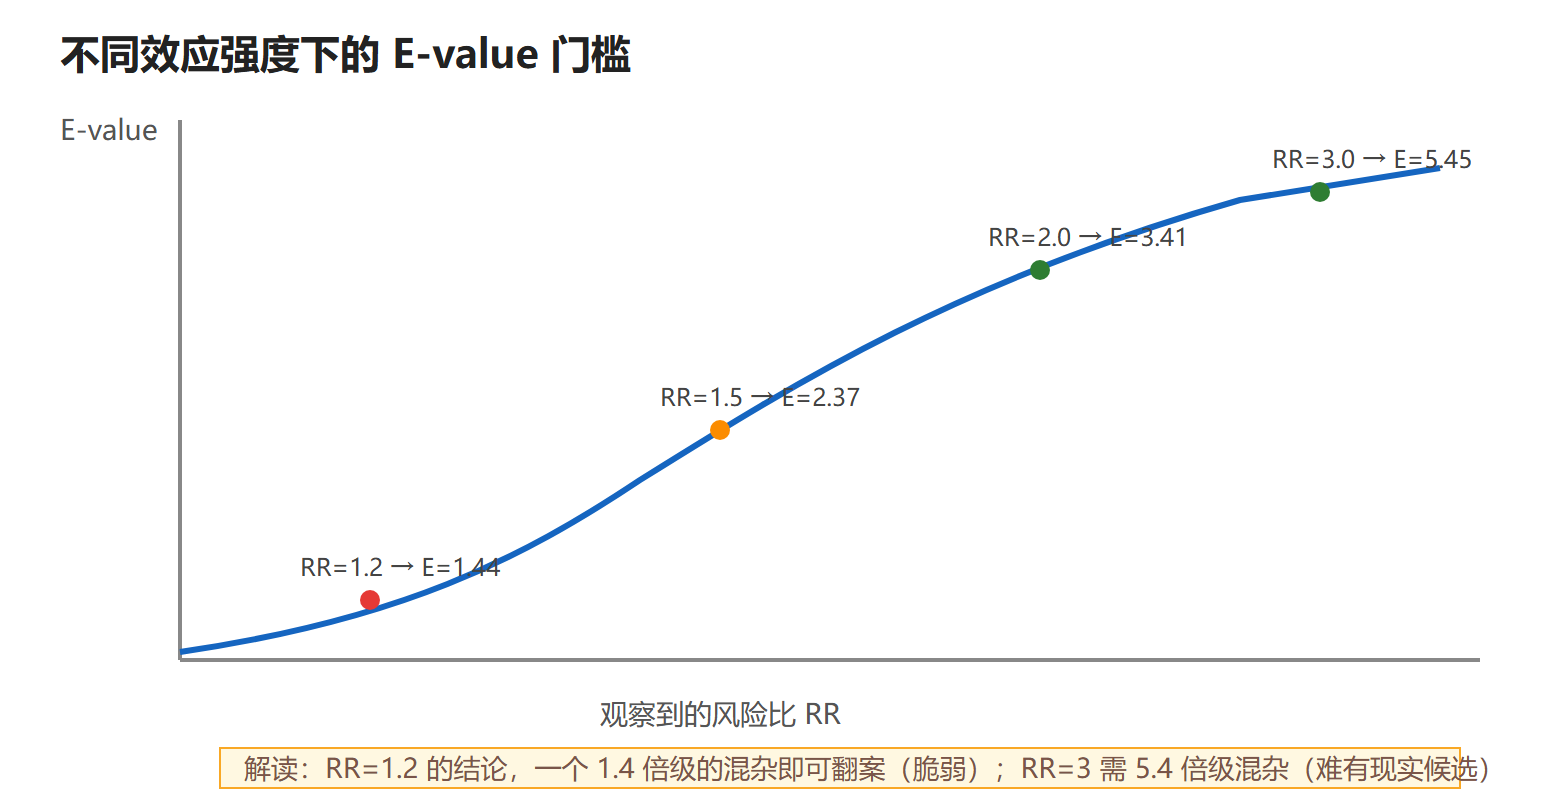
计算示例压一遍:某观察研究报告咖啡与肝癌 RR = 0.8(保护)。取倒数 1.25,E-value = 1.25 + √(1.25×0.25) ≈ 1.81。解读:需要一个未测混杂,与饮咖啡的风险比、与肝癌的风险比都达到约 1.8 且方向恰好,才能抹掉这个保护效应。已知混杂里找得到这种量级的候选吗?——比如重度饮酒/肝炎感染与肝癌的关联确实能达到,而它们与咖啡饮用也存在社会性关联。于是结论被标注为"中等脆弱"。这就是敏感性分析的正确用法:不判死刑,标出翻案所需的"价码",再用领域知识评估这个价码是否现实。
Rosenbaum 框架:匹配设计的 Γ 检验
配对研究中,Rosenbaum 敏感性分析引入参数 Γ:设未测混杂使匹配对内个体接受处理的几率比最多偏离 Γ 倍。Γ=1 即无混杂;逐步放大 Γ,观察结论的显著性在哪个 Γ 值上失守。若 Γ=1.3 就失守,结论极脆弱;撑到 Γ=2 仍然显著的结论相当稳固。这个框架与 Wilcoxon 符号秩检验结合,输出每个 Γ 下的 p 值区间上限,是医学配对研究的标配报告项。
稳健性证据的另两类来源
负控(negative control)。负控结局:一个不受处理影响但共享混杂路径的结果(如"开药处方"对"下周车祸发生率")。若主分析显示处理降低车祸率,几乎必是混杂(适应症混淆的通道同样会污染主结果)。负控暴露:一个不可能因果影响结果、但与可疑混杂相关的暴露,同样用于暴露混杂通道。负控的发现价值在于:它把"有没有混杂"这个不可检验问题,转换成"混杂通道在这个可测位置有没有显形"的检验。
安慰剂检验。随机化实验中的安慰剂组自不必说;观察性研究里对应的做法是"假处理检验":把处理时间点前移(处理发生前不应有效应)、或对已知不受影响的子群重复分析(RDD 里对前测协变量做断点估计应得零跳跃)。DoWhy 的 refute_estimations 接口把这些做成了可自动化的流水线(第 8.2 节)。
推断层面的稳健性
敏感性之外,稳健推断还有两个常规工事。多重比较:亚组分析或多个结局指标同时检验时,假阳性膨胀;预注册主结局、亚组仅作探索性报告、或用 Bonferroni/BH 校正。聚类结构:个体结果在同一学校/医院/平台账户内相关时,个体级标准误低估不确定性,必须按聚类稳健标准误或分层模型处理——忽略聚类是应用文献里最常见的"显著性幻觉"来源。这两个问题与因果识别正交,但同样能把结论毁掉,放在本节一并交代。
FAQ 与操作模板
问题:E-value 报告哪个版本?
报两个:对点估计的 E-value 与对置信区间下界的 E-value。后者回答"多强的混杂能把统计显著性也抹掉",通常比前者小很多,两者并列才完整。效应 RR=1.5 时点估计 E=2.37,若置信区间下界 1.1,其 E 值约 1.25——显著性层面的稳健性远弱于点估计层面。
问题:敏感性分析与负控结论冲突怎么解读?
负控显形(假处理显著)说明混杂通道确实在工作,此时主效应必须打折并指出方向;若 E-value 又很大(翻案需要不现实的混杂强度),两证据矛盾提示负控通道可能有自己的特殊机制(负控结局与混杂的关联强于主结局)。矛盾本身是信息:逐项排查两个工具各自的假设,比简单二选一诚实。
问题:给非技术决策者怎么讲敏感性?**用"翻案价码"的比喻框架:结论像一桩案子,敏感性分析给出"推翻它需要多大的新证据"。价码低(E-value 1.3)的结论只能当线索;价码高(3 以上)的可以当证据。决策者不需要懂几何均值,但懂"价码"。
敏感性分析的报告模板
一段可直接套用的报告格式:"主效应估计为 RR=0.72(95%CI 0.61-0.85)。点估计的 E-value 为 2.05,置信区间下界对应 1.42。即需要一个未测混杂,其与暴露、与结局的风险比都至少达到 2.05 且方向相反,才能完全解释观察到的保护效应;把显著性抹掉所需的强度为 1.42。已知候选混杂中,吸烟与结局的风险比约 1.8、与暴露的关联约 1.3,几何均值 1.53,低于点估计 E-value 但高于显著性 E-value——结论对'中等强度未测混杂'稳健,对'吸烟级别强混杂'部分敏感。另附安慰剂检验(假处理 p=0.41)与子集重估(效应区间 0.68-0.76)。"这段模板把数字、对照候选、稳健性分级写全,可直接放进任何报告的敏感性小节。
本节要点回顾
- 敏感性分析的立场:不假设无混杂为真,而量化推翻结论所需的混杂强度。
- E-value:RR+√(RR(RR−1));值越大越抗打;解读要接领域知识评估候选混杂的量级。
- Rosenbaum Γ:匹配设计里逐级放大混杂,报告结论失守的 Γ 门槛。
- 负控与安慰剂:把不可检验的混杂问题换到可测位置显形;处理前移、假子群是廉价标配。
- 推断工事:多重比较校正与聚类稳健标准误,与识别问题正交但同样致命。