4.5 工具变量:识别、强度与弱工具检验
4.5 工具变量:识别、强度与弱工具检验
本节摘要:工具变量(IV)通过一个只通过处理影响结果、且独立于混杂的外生变动源,识别未测混杂下的因果效应。本节给出 IV 三条件(相关性、排他性、外生性)、两阶段最小二乘的实现、第一阶段 F 统计量大于 10 的弱工具经验线及其由来、过度识别检验,以及 LATE 解释范围。
三条件:一个好工具的画像
当混杂 U 测不到、后门与前门都走不通时,还有最后一条路:找一个只影响"是否接受处理"、本身与结果无直接关系的变动源 Z。IV 的三条件用因果图语言写清楚:
相关性(relevance):Z 与 X 相关,图上 Z→X。可检验——看第一阶段回归。
排他性(exclusion):Z 只通过 X 影响 Y,图上不存在绕过 X 的 Z→Y 路径。不可检验,靠设计论证。
外生性(independence/exogeneity):Z 与混杂 U(从而与潜在结果)独立。不可检验,靠设计论证。
图:工具变量的图形状
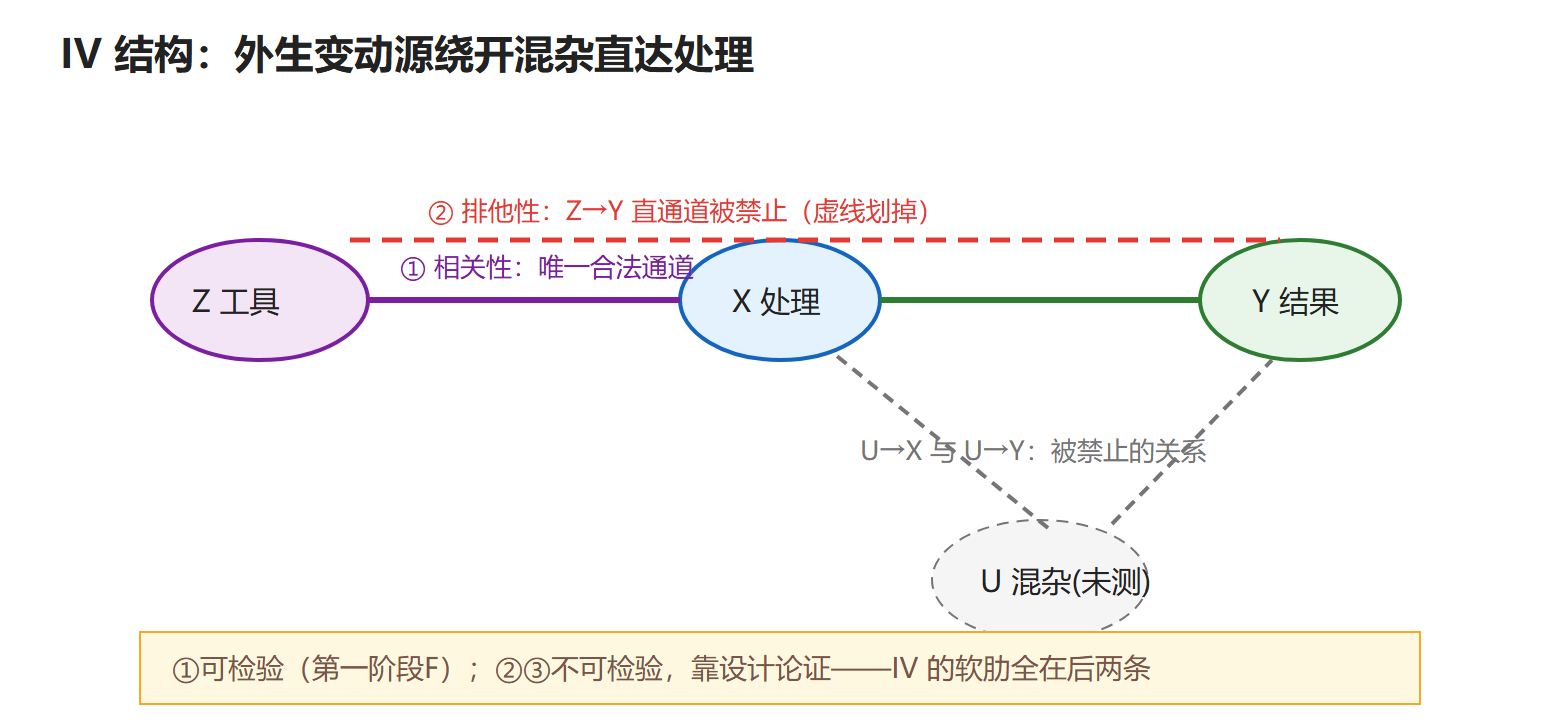
经典工具的三个来源值得记熟,因为它们是三条件的现成模板:天然随机(抽签参军、彩票中签、出生季度影响受教育年限);制度规则(录取分数线、距离造成的医院差异);外部冲击(降雨量影响水稻收成进而影响经济指标)。注意每个来源的排他性论证各有一个著名争论(参军影响退伍后收入的不只是教育;距离同时关联医院质量),IV 的可信度几乎完全押在设计论证的质量上。
两阶段最小二乘与 LATE
标准实现是两阶段最小二乘(2SLS):第一阶段 X 对 Z 回归拿到拟合值 X̂(只保留 X 中由 Z 驱动的那部分变异——恰好是被混杂 U 污染最少的部分);第二阶段 Y 对 X̂ 回归,系数即 IV 估计。一元内生、一元工具时等价于比值估计 β̂_IV = Cov(Z,Y)/Cov(Z,X),直觉是"Z 引起的 Y 变化 ÷ Z 引起的 X 变化"。
解释范围上,在效应异质且个体按自身收益选择性接受处理时(Monotonicity 假设:工具只会把人往一个方向推),IV 估计的是局部平均处理效应 LATE——只针对"会因 Z 而改变行为的那群人"(compliers)。抽签参军的例子:LATE 只讲"因为抽中签而入伍的人",不涉及"无论如何都入伍"与"打死不入伍"的人。汇报 IV 结果时写清"效应属于谁",比报出一个精确数字更重要。
弱工具:F > 10 经验线
三条件里只有相关性可检验,而它的失效模式——弱工具——后果远比想象严重。当 Z 与 X 仅微弱相关时,第一阶段拟合值 X̂ 几乎全是噪音,2SLS 偏倚朝着 OLS 偏倚的方向塌缩,且工具越弱塌缩越彻底;更糟的是常规标准误严重低估,置信区间覆盖率崩塌。经验诊断线来自 Stock 与 Yogo 的研究:第一阶段 F 统计量大于 10,弱工具偏倚大致控制在可容忍范围;F 在 10 附近时即便达标也应报告对弱工具稳健的推断(Anderson-Rubin 检验),F 明显小于 10 的结果宁可不做解释。
数字直觉压一下"偏倚塌缩":设 OLS 偏倚为 B、工具与混杂相关为 ρ。2SLS 的渐近偏倚近似 ρ·B / (Corr(Z,X) 的平方根因子)。Corr(Z,X)=0.3 时偏倚保留约三成 OLS 偏倚乘上相关项;Corr(Z,X)=0.05 时几乎完整继承 OLS 偏倚还叠加巨大方差。弱工具不是"精度低一点",是结论整体失效。
过度识别检验(Sargan/Hansen J)在工具多于内生变量时可用:若所有工具都排他,用不同工具得到的估计应一致,J 统计量检验这种一致性。它只能发现"至少一个工具有问题",不能指出是哪个,且工具全错在同方向时检验失效。
概念实现
# 概念流程:2SLS + 第一阶段诊断(示意) import numpy as np rng = np.random.default_rng(3) n = 3000 U = rng.normal(0, 1, n) # 未测混杂 Z = rng.normal(0, 1, n) # 工具:与 U 独立 X = 0.6 * Z + 0.4 * U + rng.normal(0, 1, n) # 处理:受工具与混杂共同影响 Y = 2.0 * X + 1.5 * U + rng.normal(0, 1, n) # 真实效应 2.0 # 第一阶段:F 检验(这里约等于 t 的平方,远大于 10) beta1 = np.cov(X, Z)[0, 1] / np.var(Z, ddof=1) resid = X - beta1 * Z se1 = np.sqrt(np.var(resid, ddof=1) / (np.var(Z, ddof=1) * n)) F = (beta1 / se1) ** 2 print("第一阶段F =", round(F, 1)) # 典型值 1000+,强工具 # 比值估计 beta_iv = np.cov(Z, Y)[0, 1] / np.cov(Z, X)[0, 1] print("IV估计 =", round(beta_iv, 3), "(对照OLS:", round(np.polyfit(X, Y, 1)[0], 3), ")") # 典型输出:IV≈2.0 贴真值;OLS≈2.2+ 被混杂抬高
FAQ:工具变量的实务质疑
问题:F 统计量刚过 10 就够了吗?
不够放心。F=10 对应的偏倚上限约为 OLS 偏倚的一成,但那是渐近上界;样本中等时用对弱工具稳健的推断(Anderson-Rubin CI)替代 2SLS 的常规标准误更稳妥。近年文献甚至建议把经验线提到 F>104(有效F的更严标准)再放心用常规推断——工具弱时宁可报 AR 区间也别报 2SLS 星号。
问题:多个候选工具,先做过度识别检验再挑?
危险操作。先看检验再挑工具等于用数据选假设(specification searching),J 检验的显著性水平失效。正确顺序:设计与理论先定工具集,检验只作为整体诊断;若 J 拒绝,逐个分析哪个工具有独立通道,删除理由要写成设计论证而非数据驱动。
问题:工具是"随机"的就万事大吉?
随机性只保证外生性,排他性是另一条。抽签随机,但若中签本身改变行为(通知本人"你被选中"产生霍桑效应),排他性已被破坏。每一个 IV 论文的核心段落都应当是对排他性的机制性论证,这句话值得抄进模板。
本节要点回顾
- 三条件:相关性可检验、排他性与外生性只能靠设计论证;工具来源三模板(随机、规则、冲击)。
- 2SLS 机制:拟合值只保留外生变异;一元情形等价比值估计。
- 弱工具纪律:第一阶段 F > 10 经验线;弱工具偏倚向 OLS 塌缩且标准误失真,F 附近补 Anderson-Rubin。
- LATE 解释:效应只属于 compliers,汇报时写明人群。
- 下一节:所有方法共享的软肋——未测混杂,用敏感性分析把它量化。