6.1 约束型方法:PC算法
6.1 约束型方法:PC 算法
本节摘要:约束型因果发现把 DAG 蕴含的条件独立(d 分离)当作约束,用统计检验逐条验证,反推与数据相容的图等价类。本节走 PC 算法的三阶段(骨架、定向、输出 CPDAG)、五节点手工推演、马尔可夫等价类与忠实性假设的含义,以及条件独立检验的选择与误差累积问题。
从 d 分离到约束求解
第 2.2 节的通断表在因果发现里变成发动机:给定 DAG,d 分离给出一批条件独立声明(因果马尔可夫假设保证这些声明成立);反过来,给定数据估计出的条件独立集,问哪些 DAG 与之相容。约束型方法的算法骨架因此朴素得惊人:检验所有变量对的条件独立,把"独立"记为"无边",再从骨架的局部结构推断方向。
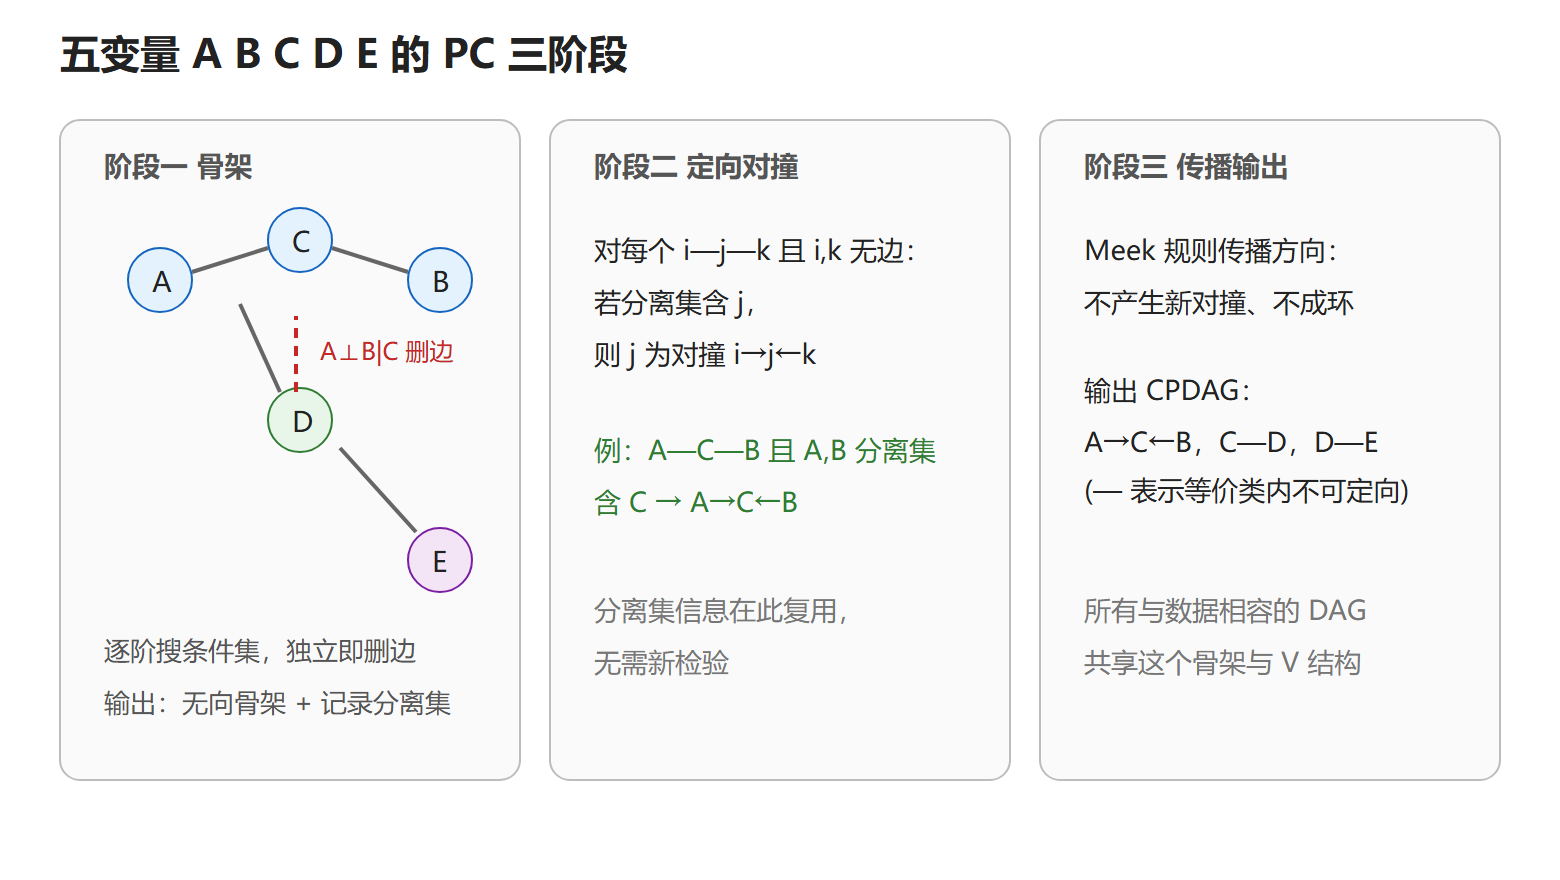
PC 算法三阶段:第一阶段从完全无向完全图出发,按条件集阶数从零开始,对每条边 (i,j) 搜条件集 S 使 i ⊥ j | S,找到即删边并记录 S;第二阶段对每个" i—j—k 形且 i、k 无边"的三元组,用记录的 S 判断 j 是不是对撞点(S 含 j 则是),定向为 i→j←k;第三阶段应用方向传播规则(避免新对撞、避免环)把能定的一律定下,输出 CPDAG——带向边与无向边(等价类内不可辨识的方向)的混合图。
图:PC算法三阶段流程(五节点示例)
等价类:为什么方向常常定不下来
上例输出里 C—D、D—E 保持无向,这是数学事实而非算法偷懒。马尔可夫等价类:两个 DAG 若共享骨架与 V 结构(对撞三元组),则蕴含完全相同的条件独立集——任何观察数据都无法区分它们。这是第 1.1 节"联合分布不含因果方向"在图上的精确表述。想要更多方向信息只有三条路:加非高斯/非线性等分布假设(第 6.3 节的 LiNGAM)、加干预数据(哪怕一次实验)、或加时间次序约束(滞后变量不能当后代)。
忠实性(faithfulness)假设也必须声明:真实分布不巧到"存在被路径抵消的独立"。若图里恰有正负两条路径精确抵消,数据呈现的独立在图上并不成立,约束型方法会被系统性误导。忠实性不可检验,它换取的是"分布的独立性结构忠实地反映图的拓扑"这一推理许可。
检验与误差的工程现实
条件独立检验的选择按数据类型:连续近高斯用偏相关(Fisher z 检验),离散用卡方或 G 检验,混合或非线性用基于核/最近邻的广义检验。显著性水平 α 是最敏感的旋钮:过松(α 大)删边过度、骨架残缺;过紧(α 小)留边过多、方向信息被噪声淹没。PC 的误差还有级联特性——第一阶段删错一条边,第二阶段的分离集与对撞判断跟着错。缓解手段:稳定性选择(对样本重抽样跑多次,只保留高频率出现的边,输出 PAG 或带置信度的边)、以及把领域知识作为先验约束(禁边、强制边)喂给算法。样本量的经验参考:五节点图要稳定的骨架,数百样本起步;节点数十个时,条件集阶数通常要限制在 2-3 以内控制检验次数。
手工推演与输出解读
五节点例子跑通后的读图。 假设阶段一删掉 A—B(分离集 {C})后骨架为 A—C—B、C—D、D—E;阶段二发现 A、B 的分离集含 C,定向 A→C←B;阶段三 Meek 规则尝试传播:C→D 还是 D→C?骨架上 D—E 与 C—D 无 V 结构约束,两个方向与已知定向都相容——CPDAG 保留 C—D、D—E 无向。输出图读作:"存在一批与数据同样相容的 DAG,它们的共同点是骨架与 A→C←B 这个 V 结构;C 与 D、D 与 E 的方向在这批图内部自由"。给下游识别用时,无向边要当作"两种可能都做敏感性分析"处理。
检验次数的规模感。 n 个变量、条件集限阶 q 时,逐对检验量级为 n²·C(n,q)。20 个变量、q=2 约 6.8 万次检验;q=3 直接破 68 万。多重检验的假阳性控制(如 α 随阶数校正)与阶数限制不是优化项,是能不能跑完的问题。这也是因果发现前先做变量筛选(领域知识压变量数)的实际原因。
PC 的实现参数速查
| 参数 | 常用值 | 说明 |
|---|---|---|
| max 条件集阶数 | 2-3 | 高维时必设,控制检验次数 |
| 显著性水平 α | 0.01-0.05 | 较严留边更稳 |
| 检验类型 | 高斯偏相关/卡方/核 | 按数据类型选 |
| 稳定性选择 | 重抽样 50-100 次 | 只保留高频边 |
| 先验约束 | 禁边/强制边/时间序 | 命中率远高于纯数据 |
时间次序先验值得一提:若有"X 不可能是 Y 的原因"的领域知识(滞后变量、暴露先于结局),作为禁边喂入能显著缩小等价类——这是最便宜的领域知识注入方式,实践中优先级应高于调 α。
从 CPDAG 到可用的因果假设
PC 输出怎样进入下游工作?三步转换:第一步,把 CPDAG 里的无向边逐一枚举两种定向,得到等价类内(通常少量)代表 DAG;第二步,对每个代表 DAG 跑第 3 章的识别判定,效应可识别的图给"识别可行"票,全部不可识别的边对标记为"数据无法回答";第三步,结合领域知识在代表图之间做敏感性分析——结论在所有代表图上一致则可信,分歧则回到数据或实验。这套流程把"发现"与"推断"串成闭环,也是因果发现论文与下游应用之间最常缺的一环。
补充:条件独立检验的实操细节
偏相关检验在高维连续数据上有两个易踩的坑。其一,条件集阶数升高时偏相关的估计方差膨胀,样本不足两百时三阶条件检验基本是噪声,此时应主动降阶并接受等价类变宽;其二,变量强偏态时先做秩变换或对数变换再检验,否则线性偏相关漏掉非线性独立,骨架出现假边。此外,显著性阈值随阶数分层设定(低阶严、高阶松)是常见改良,等价于对多重比较做部分校正。这些细节不会出现在论文正文,但决定复现者能否跑出同样的图——可复现性清单里应包含检验类型、变换与阈值三行。
本节要点回顾
- 三阶段:逐阶条件独立检验删边成骨架;用分离集定向 V 结构;Meek 规则传播,输出 CPDAG。
- 等价类:同骨架同 V 结构的 DAG 观察上不可分,方向恢复需额外假设或干预数据。
- 忠实性:独立性必须忠实反映拓扑;不可检验,是约束型方法的许可代价。
- 工程要点:检验按数据类型选,α 是敏感旋钮,误差级联靠稳定性选择与先验约束兜底。
- 下一节:不逐条检验独立、而是给整张图打分搜索的分数型路线。