4.1 查询编译与优化
4.1 查询编译与优化
本节摘要:查询编译与优化是查询引擎的"前半场",它把一句声明式 SQL 翻译成可执行的物理计划。整个过程分五步:先做词法、语法分析把文本变成抽象语法树,再绑定表名、列名消除歧义;然后进入逻辑优化,用谓词下推、投影裁剪等规则做等价改写;接着基于统计信息做代价估计;最后在众多物理算子里挑出最省资源的一种。它不直接读磁盘,却决定了要读多少页、算多少次比较——优化的质量,往往比硬件快慢更影响一条查询的最终耗时。
读前必看
阅读完本节,你应当能够:
- 说清 SQL 从文本到物理计划要经过解析、绑定、逻辑优化、代价优化、物理选择五个阶段。
- 解释谓词下推和投影裁剪为什么能削减中间结果、降低 I/O。
- 说明优化器靠什么统计信息估计基数,以及统计信息失真会导致什么后果。
- 区分基于规则的优化和基于代价的优化各自的适用边界。
- 读懂执行计划里哈希连接、嵌套循环连接等物理算子分别在什么场景被选中。
一、问题与直觉:同一句 SQL,一千条等价路径
先从一条真实查询说起。假设我们要查"最近一年下单金额超过一万元的客户",SQL 大概是:从客户表连接订单表,过滤掉一年前的单子,按客户分组,再筛出累计金额过万的组。这句查询要拿到结果,其实有无数种走法:可以先过滤订单再连接客户,也可以先连接再过滤;连接时可以用哈希连接、嵌套循环连接,也可以先排序再归并;聚合可以先做、后做,甚至把一部分聚合提前压到订单表。这些走法最终返回一模一样的结果,但耗时可能相差几个数量级——有的方案要读几十亿行,有的只读几百万行。
数据库面对的,从来不是"能不能算出来",而是"在这么多等价路径里,怎么挑出最省的那一条"。这个挑选动作,就是查询编译与优化要干的活。我们可以把它理解成一条翻译加装配的流水线:先把人类写的 SQL 翻译成机器能理解的结构,再在这个结构上做等价改写,最后根据数据分布给每条候选路径估个价,挑最便宜的装配成最终方案。翻译负责"听懂",装配负责"选材",两者缺一不可。
这里有个容易被忽略的点:优化器本身也是要花时间的。一条几毫秒就能跑完的简单查询,如果优化器磨蹭半秒去反复比价,反而得不偿失。所以真正的工程系统必须在"优化的开销"和"执行节省下来的开销"之间找平衡。这也解释了为什么后面会看到规则优化和代价优化是分层、分阶段进行的——先做便宜的确定性改写,再对真正值钱的候选做代价搜索。这条主线会贯穿本节始终。
二、从文本到结构:解析与绑定
SQL 进到数据库,最先遇到的是一串字符。数据库不信任未经校验的字符串,它要先把这串字符变成带语义的结构,才谈得上优化。
词法分析负责把字符切成有意义的词块,也就是 token。WHERE amount > 100 会被切成关键字 WHERE、标识符 amount、大于号、数字 100 四个 token。这一步是纯机械的,但要处理一堆细节:区分字符串里的引号、跳过注释、识别小数和负数、判断大于等于号是一个 token 而不是两个。任何一个细节漏了,后面的语法分析就会在错误的位置上栽跟头。
语法分析拿到 token 流后,依据 SQL 的文法规则把它组合成一棵抽象语法树,常简称为 AST。这棵树记录了语句的结构:SELECT 子句里有哪些列、FROM 子句里有哪些表、WHERE 里是哪些条件、它们之间是什么嵌套关系。如果语法有问题——括号不匹配、关键字写错、GROUP BY 位置不对——解析器就在这一步报错,把查询挡在门外。现代系统对解析器有两种做法:一种用工具从文法自动生成,另一种手写递归下降解析器。手写的优势是报错信息更友好、执行更快,代价是维护成本高。这个选择本身就是一个工程取舍,不涉及对错。
语法正确不等于语义清楚。FROM t JOIN s 里的 t 到底是表、视图,还是前面定义的公共表达式?x 是列名、函数名,还是别名?绑定这一步负责回答。绑定器拿着语法树,去查系统的元数据目录,把每个名字解析成唯一确定的对象,同时做类型检查——比如 WHERE id = 'abc' 里,如果 id 是整数,这个比较就需要隐式类型转换,绑定器要判断能不能转、往哪边转。
绑定的重要性常被低估。没有它,后面所有优化都是空中楼阁:你连 o.user_id 是哪张表的哪个列都没搞清楚,凭什么把它下推到数据源?绑定完成后,我们得到一棵"已绑定 AST",每个节点都带上了类型、所属关系等信息,这才具备进入优化的资格。
图注:解析与绑定把无结构的字符串,一步步变成带类型和归属信息的逻辑计划入口。绑定不是优化的前置步骤那么简单,它是优化能够安全进行的必要前提。
三、逻辑优化:不花代价的等价改写
已绑定的 AST 会转成逻辑计划——一棵由关系代数算子组成的树,比如扫描、过滤、连接、聚合、投影。这个阶段还没决定具体算法,只说"要做什么",不说"怎么做"。
逻辑优化的核心是规则改写,业内常叫 RBO。它应用一批"语义保持"的代数变换,把计划改写成更省的形态。这些规则不查数据、不算代价,只认关系代数的恒等式,所以执行起来很快,结果也确定。你可以把它当成一位恪守公理的装配工:不问行情,只按代数定律把零件往省料的方向重新摆。
谓词下推是最重要的一条。它把 WHERE 里的过滤条件尽量往下压,压到离数据源最近的地方。原计划可能是"先连接订单和客户,再过滤掉去年的单子",谓词下推后变成"先在订单表过滤掉去年的单子,再和客户连接"。中间结果小了,后面的哈希构建、网络传输、内存占用全跟着降。这是一条几乎百利无害的规则,所以几乎所有优化器都把它当成默认动作。
投影裁剪是第二条。查询最终只要客户名和订单金额,那订单表里那些没用的列——地址、备注、状态——在连接之前就该丢掉。少搬一列,就能少读很多页、少占很多缓存,这是纯赚的买卖。
除了这两条,常见的规则还有:常量折叠,把 1 + 2 这种表达式在编译期直接算成 3;连接交换与结合律,调整连接顺序,为代价优化铺路;聚合下推,在条件允许时把部分聚合提前。这些规则共同点是"确定正确、且通常更省",所以可以放心地反复应用,直到没有新规则能触发为止。
但规则优化有它的天花板:它不关心数据到底长什么样。WHERE created_at > 去年 在十亿行表上到底该不该走索引、过滤完还剩多少行,这些数据敏感的问题,规则回答不了。它解决的是"能不能改得更优",不是"值不值得"。这就是下一步代价优化登场的原因。
| 逻辑优化规则 | 作用 | 典型收益 | 是否有风险 |
|---|---|---|---|
| 谓词下推 | 把过滤条件压向数据源 | 大幅减少中间结果与 I/O | 几乎无 |
| 投影裁剪 | 去掉下游不用的列 | 减少搬运的字节数 | 几乎无 |
| 常量折叠 | 编译期算掉常量表达式 | 减少运行时计算 | 无 |
| 连接重排 | 调整表连接顺序 | 可能带来数量级优化 | 改变中间基数,需配合代价 |
| 聚合下推 | 提前做部分聚合 | 减少连接输入 | 语义上需谨慎,可能出错 |
四、代价优化:给每条候选路径估个价
规则优化把计划改得"语法上更优"之后,真正的难点来了:同样的逻辑,物理上有一堆实现方式,哪条最省?这就是基于代价的优化,业内常叫 CBO。
CBO 的核心是一个代价模型,它把一条计划的成本拆成几块:I/O 代价,要读多少页;CPU 代价,要做多少次比较、哈希、排序;内存代价,要不要外排、溢写磁盘;网络代价,分布式下要搬多少数据。模型把这些加总成一个数,优化器就拿这个数给候选计划排序。谁的数字小,谁胜出。
代价模型准不准,全看统计信息。数据库平时会收集并维护每张表、每列的数据画像:总行数、值的分布直方图、不同值的个数、有没有空值。有了这些,优化器才能估算"这个谓词能过滤掉多少行",这个估算叫基数估计。比如它知道订单表的创建时间大致分布在三百六十五天里,就能估出"过去一年"大约占多少比例,从而推算过滤后剩多少行。
基数估计是优化器最容易翻车的地方。它普遍依赖一个简化假设:各列的过滤条件相互独立,选择率可以直接相乘。真实数据里这个假设经常不成立——"下单金额高"和"是老客户"往往强相关。一旦假设错了,估计可能偏差几个数量级,优化器就会据此挑出一个看似便宜、实际很贵的计划。这也是为什么很多数据库提供多列统计、采样等手段来修正独立假设,甚至引入自适应优化,在查询跑起来后发现估计偏差就动态调整后续计划。
有了代价模型,还要解决"搜哪条"的问题。连接的表一多,候选计划的数量是组合爆炸的——n 张表的连接顺序是双阶乘级别。穷举不现实,所以工程上分档处理:表少的时候用动态规划精确搜索,保证最优;表多了就退回贪心,每次挑当前最省的合并;再多就用遗传算法之类的近似手段碰运气。这又是一处"精确与速度"的取舍。
图注:代价优化把统计信息喂给代价模型,对候选计划打分,再依据表数量分档搜索。表少求精确,表多求近似,这是"最优"与"耗时"之间的现实妥协。
五、物理计划:把逻辑落到具体算法
逻辑计划经过代价优化,最后要映射成物理计划——每个逻辑算子都指定一种具体的实现算法。这一步才是编译优化向执行引擎交货的地方。
拿连接来说,同一个"连接"逻辑,至少有三种物理实现。嵌套循环连接适合小表驱动大表、且内表有索引的场景;哈希连接适合内存放得下、基数中等的场景,它先构建哈希表再探测,平均复杂度接近线性;排序归并连接适合两边输入本来就按连接键排好序、或者磁盘随机读很慢的场景。选哪个,取决于优化器对两边基数的估计、可用内存大小、数据是否已排序,甚至硬件的缓存特性。
聚合同样有多个版本。哈希聚合适合分组键分散、内存充足;流式聚合适合输入已按分组键排好序,只维护当前组的状态,内存占用近乎常数;内存放不下就退化到外部聚合,溢写磁盘再归并。
| 逻辑操作 | 物理实现 | 适用场景 | 关键约束 |
|---|---|---|---|
| 连接 | 嵌套循环连接 | 小表驱动大表且有索引 | 内表要有索引才划算 |
| 连接 | 哈希连接 | 基数中等、内存放得下哈希表 | 内存不足会频繁溢写 |
| 连接 | 排序归并连接 | 输入已排序或随机读很慢 | 要先付排序的成本 |
| 聚合 | 哈希聚合 | 分组键分散、内存充足 | 内存敏感 |
| 聚合 | 流式聚合 | 输入按分组键排好序 | 依赖输入有序 |
| 聚合 | 外部聚合 | 内存放不下 | 溢写磁盘再归并 |
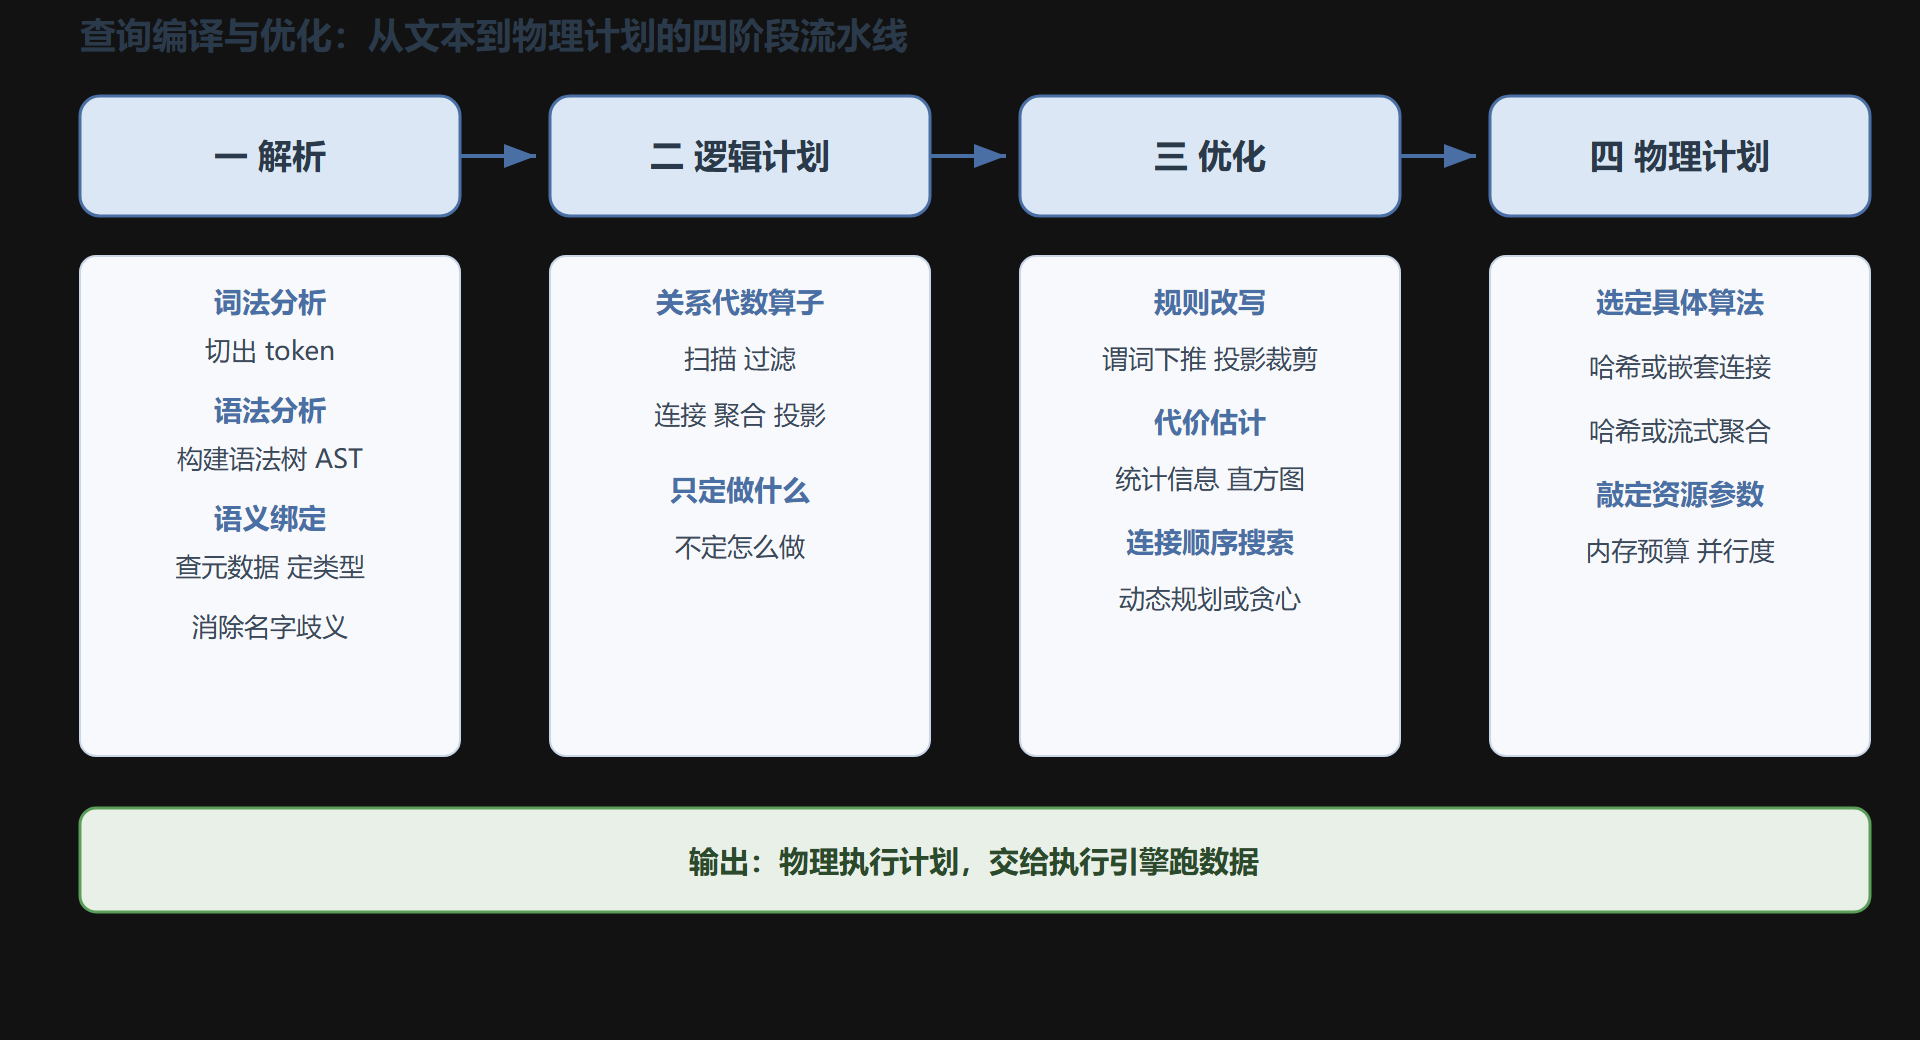
物理算子选择和内存预算强耦合。比如哈希连接的内存参数设小了,哈希表放不下就会频繁溢写,性能断崖式下跌;设大了又可能挤占其他算子的空间。这正是为什么同一个查询,在不同负载下跑出来的计划可能不一样——优化器在实时权衡资源。到这里,编译优化的流水线走完了:文本变成结构,结构被等价改写,改写后的候选被代价打分,最优者落地成物理计划,交给执行引擎。
图:查询优化的四阶段流水线
⚠️ 常见坑:很多人一看慢查询就急着加索引,其实问题常常出在优化器选错了计划。先看执行计划里"估计行数"和"实际行数"差多少——差得离谱,多半是统计信息过期了,重新收集统计信息比盲目加索引更对症。
💡 关键直觉:优化器的本质是"用统计信息预测未来,再挑最便宜的方案"。它聪明与否,一半在算法,一半在它手里那张数据分布的地图准不准。地图旧了,再聪明的导航也会带你绕远路。
核心回顾
- 五阶段流水线:解析、绑定、逻辑优化、代价优化、物理选择,层层把 SQL 从文本逼成可执行计划。
- 绑定是前提:没把表名列名解析清楚,后面所有优化都无从谈起,甚至会出错。
- 谓词下推是头号功臣:把过滤压到数据源附近,是削减 I/O 和中间结果最稳的一招。
- 规则优化快而确定,代价优化贵而聪明:两者分层配合,先做便宜的等价改写,再做昂贵的代价搜索。
- 代价模型依赖统计信息:基数估计的独立假设最容易失真,失真的代价就是选错计划。
- 物理算子是对同一逻辑的不同算法实现:哈希、嵌套循环、排序归并各有适用场景,靠基数和内存预算决定。
- 优化本身有成本:简单查询不值得深度搜索,所以系统分档使用动态规划、贪心和近似算法。
下一节我们把视角从"做计划"转到"执行计划":这份物理计划真正跑起来时,数据以什么粒度、什么方式流过 CPU,火山、向量化、编译执行三种模型各有怎样的代价。