4.2 查询执行模型
4.2 查询执行模型
本节摘要:执行模型回答的是优化器交付物理计划之后的问题——数据以什么粒度、什么控制方式流过 CPU。本节对比三种主流模型:火山模型把每个算子做成迭代器,一次拉一行,结构清晰但函数调用和分支预测开销大;向量化执行改成一次处理一批列式数据,配合 SIMD 指令把 CPU 利用率提上去;编译执行则干脆把整条算子链即时编译成一段机器码,把解释开销压到最低。三种模型不是替代关系,而是针对不同负载和硬件的分工,现代引擎普遍混用。
学习目标
阅读完本节,你应当能够:
- 说清火山模型"一次一行、拉取式"的工作方式及其主要开销来源。
- 解释向量化执行为什么能靠批处理和 SIMD 提升 CPU 利用率。
- 说明编译执行如何用即时编译消除算子间的解释开销,以及它的编译成本。
- 从数据粒度、控制方式、开销来源三个维度对比三种模型。
- 判断一个查询负载适合哪种模型,并理解现代引擎的混合策略。
一、问题与直觉:计划的终点,执行的起点
优化器把物理计划交出来,只是走完了一半。同样一份"哈希连接加过滤加聚合"的计划,执行起来可以一次搬一行,也可以一次搬一卡车。这个"搬运粒度"和"控制方式"的选择,就是执行模型。
问题出在哪?现代 CPU 有个脾气:它喜欢长流水线、大块连续数据、少分支的密集计算。而传统数据库最早那套执行方式,恰恰反着来——一次只处理一个元组,每个元组要穿越一层层算子,每层都是一次函数调用,还带虚函数跳转和状态判断。结果是 CPU 花了大量周期在"调度"上,真正干活的比较、加法只占一小部分。实测里,这种执行方式能有三分之一以上的 CPU 周期耗在开销上,而不是数据计算。
于是就有了两条改进路线。一条保留"逐算子调用"的结构,但把每次处理的数据从一行变成一批,让 CPU 的 SIMD 指令能并行算;另一条更激进,干脆把算子链在运行前编译成一段连续的机器码,消灭调用本身。这两条路线,加上最早的火山模型,构成了查询执行的三种主流模型。理解它们,就是理解数据库怎么跟 CPU 的脾气和解。
二、火山模型:一次一行的拉取式管道
火山模型把每个关系代数算子实现成一个迭代器,对外只暴露三个接口:打开、取下一行、关闭。数据从存储层被上层算子的取下一行调用一层层"拉"上来,像一口倒置的火山——熔岩从地核被压力挤着往上冒,经过一层层岩浆通道,最后喷到地表。
这套设计最大的好处是清晰和可扩展。每个算子只管自己这一层:扫描算子知道怎么从表里读一行,过滤算子知道怎么判断这一行该不该放行,连接算子知道怎么把左右两行配对。要加一个新算子,实现它的取下一行逻辑就行,不用动别的模块。这种"算子即接口"的思路,让数据库内核能像搭积木一样组合出任意复杂查询。
但优雅是有代价的,而且这个代价在数据量一大就变得刺眼。一行数据要穿过一条算子链,每一层都要付出四类开销:函数调用的栈帧进出、虚函数在运行时查表跳转、每个取下一行入口的状态机判断、以及元组对象反复创建销毁带来的内存抖动。这些开销单看都不大,但乘上每秒上百万行,就成了一笔沉重的"调度税"。
更糟的是,这些开销还跟现代 CPU 的优化机制对着干:虚函数跳转打乱指令流水线,状态判断带来分支预测失败,指针间接寻址污染缓存行。所以火山模型虽然奠定了查询执行的正确性框架,但在追求极致吞吐的分析型负载下,它成了被改造的对象。
图注:火山模型的拉取式管道。控制流从客户端一路往下压,数据再从存储层逐行往上返。结构清晰,但每一行都要付出多次调用和判断的代价。
| 开销类型 | 来源 | 后果 | 缓解方向 |
|---|---|---|---|
| 函数调用 | 每层算子的取下一行调用 | 栈帧进出,常数开销 | 批处理,减少调用次数 |
| 虚函数分派 | 面向接口的多态调用 | 运行时查表跳转,打乱流水线 | 静态派发或融合算子 |
| 状态机判断 | 每个入口判断算子状态 | 分支预测失败 | 批内状态恒定 |
| 元组生命周期 | 反复构造拷贝析构对象 | 小内存分配、缓存污染 | 复用缓冲区、列式存储 |
三、向量化执行:一次一批,交给 SIMD
火山模型的病根是"粒度太细"。向量化执行对症下药:把处理单位从一行改成一批,典型是几百到几千行,而且这批数据按列组织成连续的数组。
为什么要按列?因为按列之后,同一列的一批值在内存里是紧挨着的,正好喂给 CPU 的 SIMD 指令。比如判断"订单数量是否大于 25",火山模型要一行行地取字段、和 25 比较;向量化则把这一批数量值装进宽寄存器,一条指令同时比较 8 个、16 个整数,再用一个掩码向量记录哪些通过。函数调用次数从"每行一次"降到"每批一次",虚函数跳转、状态判断、元组构造这些开销几乎全消失了。
向量化的核心收益来自"控制流稳定加上数据流连续"。批处理循环内部状态恒定,CPU 的分支预测器很舒服;列式数据连续,缓存行被充分利用,内存带宽被榨干。这让分析型查询的吞吐能上一个数量级,也是 ClickHouse、DuckDB 这类列存引擎能跑得快的关键之一。
但它不是没有坑。批大小怎么定就是个麻烦:定太大,内存占用高、首行延迟变差;定太小,又退回火山的细粒度。而且数据分布倾斜时——比如一千万行里只有一万行满足条件——过滤完可能产生大量"空批",CPU 在空循环里空转。工程上的对策是自适应批大小和提前终止,根据前几批的过滤率动态调整后续批次,把空转压下去。
向量化还有一层意义:它把执行模型从"控制流驱动"转向"数据流驱动"。算子不再是主动拉数据,而是接收一批列式数据、做纯函数变换、输出新的一批。这种形态天然贴合现代多核和缓存层次,也让数据库和科学计算库在数据表示上第一次对齐了。
图注:向量化执行里,数据以列式批次为单位在算子间流动,每个算子内部用 SIMD 指令批量处理。调用次数和分支开销都被大幅摊薄。
四、编译执行:把计划直接锻造成机器码
向量化解决了粒度问题,但算子之间那层"解释调度"还在:过滤算子调连接算子,连接算子又调扫描算子,这条调用链本身就是开销。编译执行的思路是釜底抽薪——在查询真正跑之前,把整条算子链编译成一段针对这条查询定制的机器码,运行时直接执行,中间不再有函数调用和解释器。
具体做法是借助即时编译框架,LLVM 是代表。物理计划生成后,编译器把每个算子的逻辑——过滤的表达式、聚合的函数、连接的条件——翻译成中间表示,然后做激进优化:常量折叠、死代码消除、循环展开、把算子调用全部内联。最终得到一段扁平的代码,扫描、过滤、连接、聚合被融合成一个函数。
效果很震撼:在复杂嵌套查询上,编译执行能把端到端延迟降低数倍,CPU 的有效指令密度大幅提高,因为处理器几乎每个周期都在干实事,而不是处理分支失败或缓存未命中。你可以把它想象成把一条盘山公路凿成一条直通隧道——路还是那段路,但少绕了很多弯。
代价同样摆在明面上。编译本身要花时间,把计划变成机器码可能几十毫秒起步,这对一个几毫秒就该返回的短查询是毁灭性的。而且编译框架本身吃内存。所以没人会傻到对所有查询都上编译执行,实际都是混合策略:耗时长、值得投入编译成本的查询才编译;短查询继续走解释或向量化;还能做增量编译,只编译计划里变化的那部分子树,把平均编译开销压到几毫秒。
五、三种模型的取舍与混合
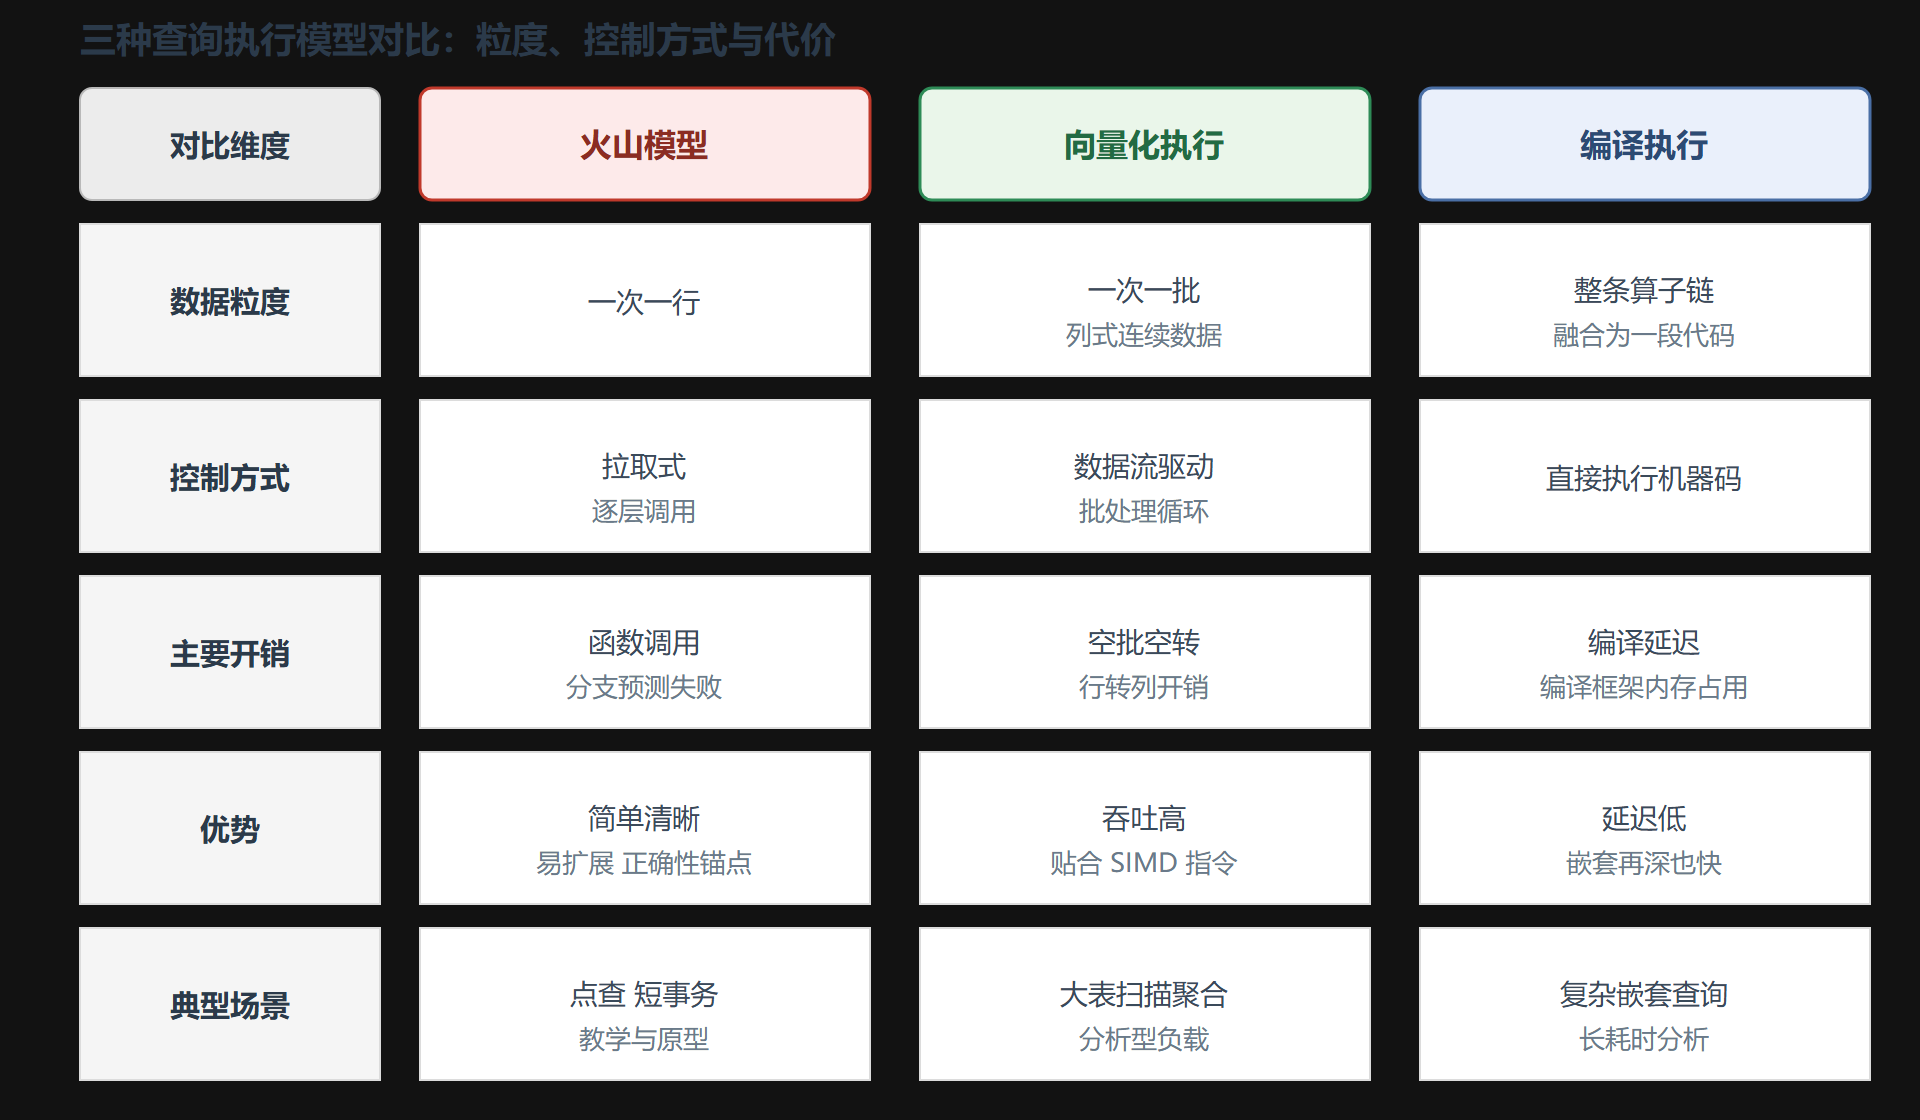
把这三种模型摆在一起,会看到它们并不是谁淘汰谁,而是各守一段。火山模型胜在简单正确,是语义的锚点,新算子、教学、以及那些本来就很快的简单查询都用得上;向量化执行是吞吐的主力,靠批处理和 SIMD 榨 CPU;编译执行是压榨最后一点延迟的杀手锏,专治算子链长、嵌套深的复杂查询。
选择哪个,本质是在回答两个问题:这个查询是吞吐型还是延迟敏感型?数据是行式还是列式?点查、短事务,火山模型足够;大表扫描聚合,向量化碾压;几十个表嵌套的复杂分析,编译执行能把延迟打下来。
现实里的顶级引擎几乎都是混用的:DuckDB 在同一查询里自动在向量化解释和编译执行之间切换,ClickHouse 把向量化和轻量即时编译揉在一起。这不是摇摆,而是承认一个事实——没有一种模型能在所有负载、所有硬件上通吃。
图:三种查询执行模型对比
⚠️ 常见坑:把"上了向量化或编译执行"当成性能银弹。如果数据本身是行式存储、或者查询以点查为主,向量化的列式批处理反而要先付出行转列的开销,得不偿失。先看清负载形态,再选执行模型,顺序不能反。
💡 关键直觉:执行模型的演进,说到底是在跟 CPU 的脾气和解——把细碎的、跳来跳去的计算,改造成连续的、可预测的大块计算。谁更贴合硬件,谁就跑得更快。
本节速览
- 火山模型是正确性锚点:一次一行、拉取式、算子即迭代器,清晰可扩展,但调度开销大。
- 四大开销:函数调用、虚函数分派、状态机判断、元组生命周期,占了火山模型相当比例的 CPU 周期。
- 向量化靠批处理换吞吐:按列成批、SIMD 并行,把调用次数和分支开销降到极低。
- 编译执行靠即时编译换延迟:算子链融合成机器码,消灭解释开销,但编译本身有成本。
- 三种模型各守一段:火山管简单正确,向量化管吞吐,编译执行管复杂查询的低延迟。
- 负载决定选择:行式点查别硬上向量化,短查询别硬上编译,选型要先看数据和查询形态。
- 混合是常态:现代引擎按查询特点动态切换模型,而不是一选定终身。
到这一节,单机数据库的查询引擎就闭环了:从 SQL 文本,到计划,再到执行。下一章我们把视角从单机拉远,看分布式系统怎么在多个节点之间做同样的事。