5.2 数据分布与复制
5.2 数据分布与复制
本节摘要:数据分布回答"数据放在哪",数据复制回答"数据怎么不丢"。前者靠分片,把键空间切成范围或哈希桶,分到不同节点上做水平扩展;后者靠副本,把同一份数据抄成多份,用主从、多主或无主三种模型提供容错。两者的分界线是:分片决定扩展的粒度,复制决定容错的深度。选错分片键会制造热点,选错复制参数会要么丢数据、要么读旧数据,这一节把这两件事一次讲透。
阅读收获
阅读完本节,你应当能够:
- 说清为什么单机放不下时,分片是比堆硬件更根本的解法。
- 比较范围分片、哈希分片、一致性哈希三者的优缺点和适用场景。
- 描述主从、多主、无主三种复制模型的差异。
- 用读写法定人数解释副本数与一致性、可用性之间的权衡。
- 识别分片键选择不当带来的热点问题,并说出缓解思路。
一、从"放不下"和"怕坏掉"说起
分布式改造的动机,上一节已经点到,这里再具体一点。数据规模到了一定程度,会同时撞上两堵墙:一堵是容量墙,单机磁盘装不下;另一堵是吞吐墙,单机 CPU 和网卡扛不住每秒的请求。要翻过这两堵墙,只有一个办法——把数据切开,分到多台机器上,让每台机器只负责一小块。这就是分片,也叫数据分布。
但切开之后又冒出一个新问题:机器是会坏的。数据分到了十台机器上,任何一台宕机,那一小块数据就没了。于是我们需要给每一份数据抄几份副本,放到不同的机器上。机器坏了一台,另外的副本顶上,业务不中断。这就是复制。
这两个动作,一个解决"放不下、扛不住",一个解决"怕坏掉",看起来是两码事,实际却绞在一起。因为它们都绕不开同一个核心问题:这一小份数据,到底该由谁来持有、谁来写、谁来读?这个"数据主权的空间治理"问题,就是本节的主线。
先立一个类比。分片像把一座城市划分成几个邮区,每个邮区只投递自己辖区内的信件,投递员不用跑遍全城;复制像是给每个邮区配了好几个投递员,一个请病假了,别人顶上去。邮区怎么划,决定了单个投递员的负载;投递员配几个,决定了这个邮区容不容易瘫痪。二者不冲突,但要一起设计。
二、分片:把键空间切成几块
分片的第一步,是给"数据放在哪"定一条规则。这条规则的核心,是设计一个从键到分片的映射函数。常见的有三种,各有各的脾气。
范围分片:把键空间按字典序切成连续区间,比如键在字母 a 到 m 之间的进一号分片,m 到 z 之间的进二号分片。它的最大好处是天然支持范围扫描——查"订单创建时间在某个月"这类查询,能精准落在少数几个分片上,不用全集群广播。但它的软肋是热点倾斜。如果新数据总是集中在键空间的尾部(比如按时间递增的 ID),尾部分片就会持续过载,头部分片闲得发慌。更糟的是,某些"明星键"对应的分片会被挤爆,比如某个头部主播的粉丝列表,全堆在一个分片上。
哈希分片:对键做一次哈希,再用哈希值对分片数取模,落到对应分片。哈希把键"打散"了,负载天然均匀,几乎不会出现范围分片那种结构性倾斜。但代价是丢了范围查询能力——一次范围扫描,得广播到所有分片,再把结果拼起来。还有个大坑在扩容上:分片数一变,取模的底数就变,绝大多数键的映射位置都变了,触发海量数据迁移。
一致性哈希:为了缓解哈希分片扩容时的迁移风暴,一致性哈希把节点和键都映射到一个环上,键沿着环找到它之后的第一个节点。这样加一台机器,只需要迁移环上相邻的一小段数据,而不是全量重排。但它引入了虚拟节点、环上负载均衡这些新复杂度,管理成本更高。
真正的工业系统很少只押一种。主流做法是"复合分片":主键拆成分区键加排序键,分区键决定进哪个分片,排序键在分片内保持有序。这样既保留了分片内的范围查询,又靠分区键的哈希或范围划分控制负载。
把分片的整个决策链路画出来,就是下面这条从键到节点的流水线:
分片策略对比
| 分片策略 | 负载均衡 | 范围查询 | 扩容迁移成本 | 典型问题 |
|---|---|---|---|---|
| 范围分片 | 差,易倾斜 | 强,天然支持 | 高 | 热点集中在尾部分片 |
| 哈希分片 | 好,均匀 | 无,需广播 | 极高,全量重排 | 扩容触发迁移风暴 |
| 一致性哈希 | 较好 | 无 | 低,局部迁移 | 环管理复杂 |
| 复合分片 | 可控 | 分片内支持 | 中 | 分区键设计难 |
⚠️ 常见坑:选分区键时只想着"均匀",忽略了查询模式。用哈希把用户 ID 打得再均匀,如果所有查询都是"按订单日期统计",你还是得扫全部分片。分片键的正确设计顺序,是先看访问模式,再谈均匀。
💡 关键直觉:分片不是"切割数据",而是"切割数据的访问契约"。你把哪些键放在一起,直接决定了哪些查询能落在本地、哪些查询要跨节点广播。分片键选得好,等于提前替大部分查询安排好了回家的路。
三、复制:把一份数据抄成几份
分片解决了"放哪",复制解决"怎么不丢"。复制模型按"谁能写"分成三种。
主从复制:每个分片有一个主节点负责写,其余是从节点,负责读和备份。主节点把写操作记成日志,异步或同步地发给从节点。它简单、好理解、冲突少,因为写只有一个入口。代价是主节点是单点:主挂了,要选举或手动切换,切换窗口里可能写不进去。读可以分摊到从节点,但异步复制下,从节点可能落后,读到的未必是最新值。
多主复制:每个节点都能写,写操作在节点之间互相同步。它消除了写单点,提升了写入的扩展性,代价是冲突。两个节点同时改了同一条数据,谁算数?这就得靠冲突检测和解决策略,比如"最后写入者胜",或者用向量时钟发现并发,再交给业务规则合并。多主最适合多点部署、离线优先的场景,但冲突处理的复杂度不能低估。
无主复制:干脆不设主节点,写请求发给多个副本,读请求也发给多个副本,靠法定人数保证读新。典型代表是 Dynamo 系。它把"写几个、读几个"交给调用方去调,灵活性最高,但一致性责任也下沉到了客户端,客户端要自己处理"有的副本新、有的副本旧"的分歧。
复制模型对比
| 复制模型 | 写入入口 | 冲突 | 一致性控制 | 适用场景 |
|---|---|---|---|---|
| 主从复制 | 单主 | 少 | 主节点顺序写入 | 读多写少、需强一致 |
| 多主复制 | 多主 | 多,需消解 | 冲突解决策略 | 多点写入、离线优先 |
| 无主复制 | 无主 | 需客户端处理 | 读写法定人数 | 高可用、可调一致性 |
⚠️ 常见坑:把"异步复制"和"高可用"画等号。主节点刚写完就宕机,异步复制的从节点还没收到这条写,切换之后这条写就"凭空消失"了。要保写不丢,主节点得等至少一个从节点落盘确认(同步复制或半同步复制)再返回成功,代价是写延迟变高。
四、分片与复制的协同:两张图叠在一起看
分片和复制不是两个孤立模块,它们要叠起来看。一个常见的布局是:把数据切成若干分片,每个分片内部又是一个复制组,组里有若干副本。这样,水平扩展靠分片数,容错能力靠每组的副本数,两个维度独立可调。
下面的图把这两层画在一起。上半层是哈希分片:键经过哈希落到某个桶,桶再映射到物理节点;下半层是主从复制:一个分片组里有主有从,主负责写,从负责读和备份。
分片与复制:哈希分片叠加主从复制
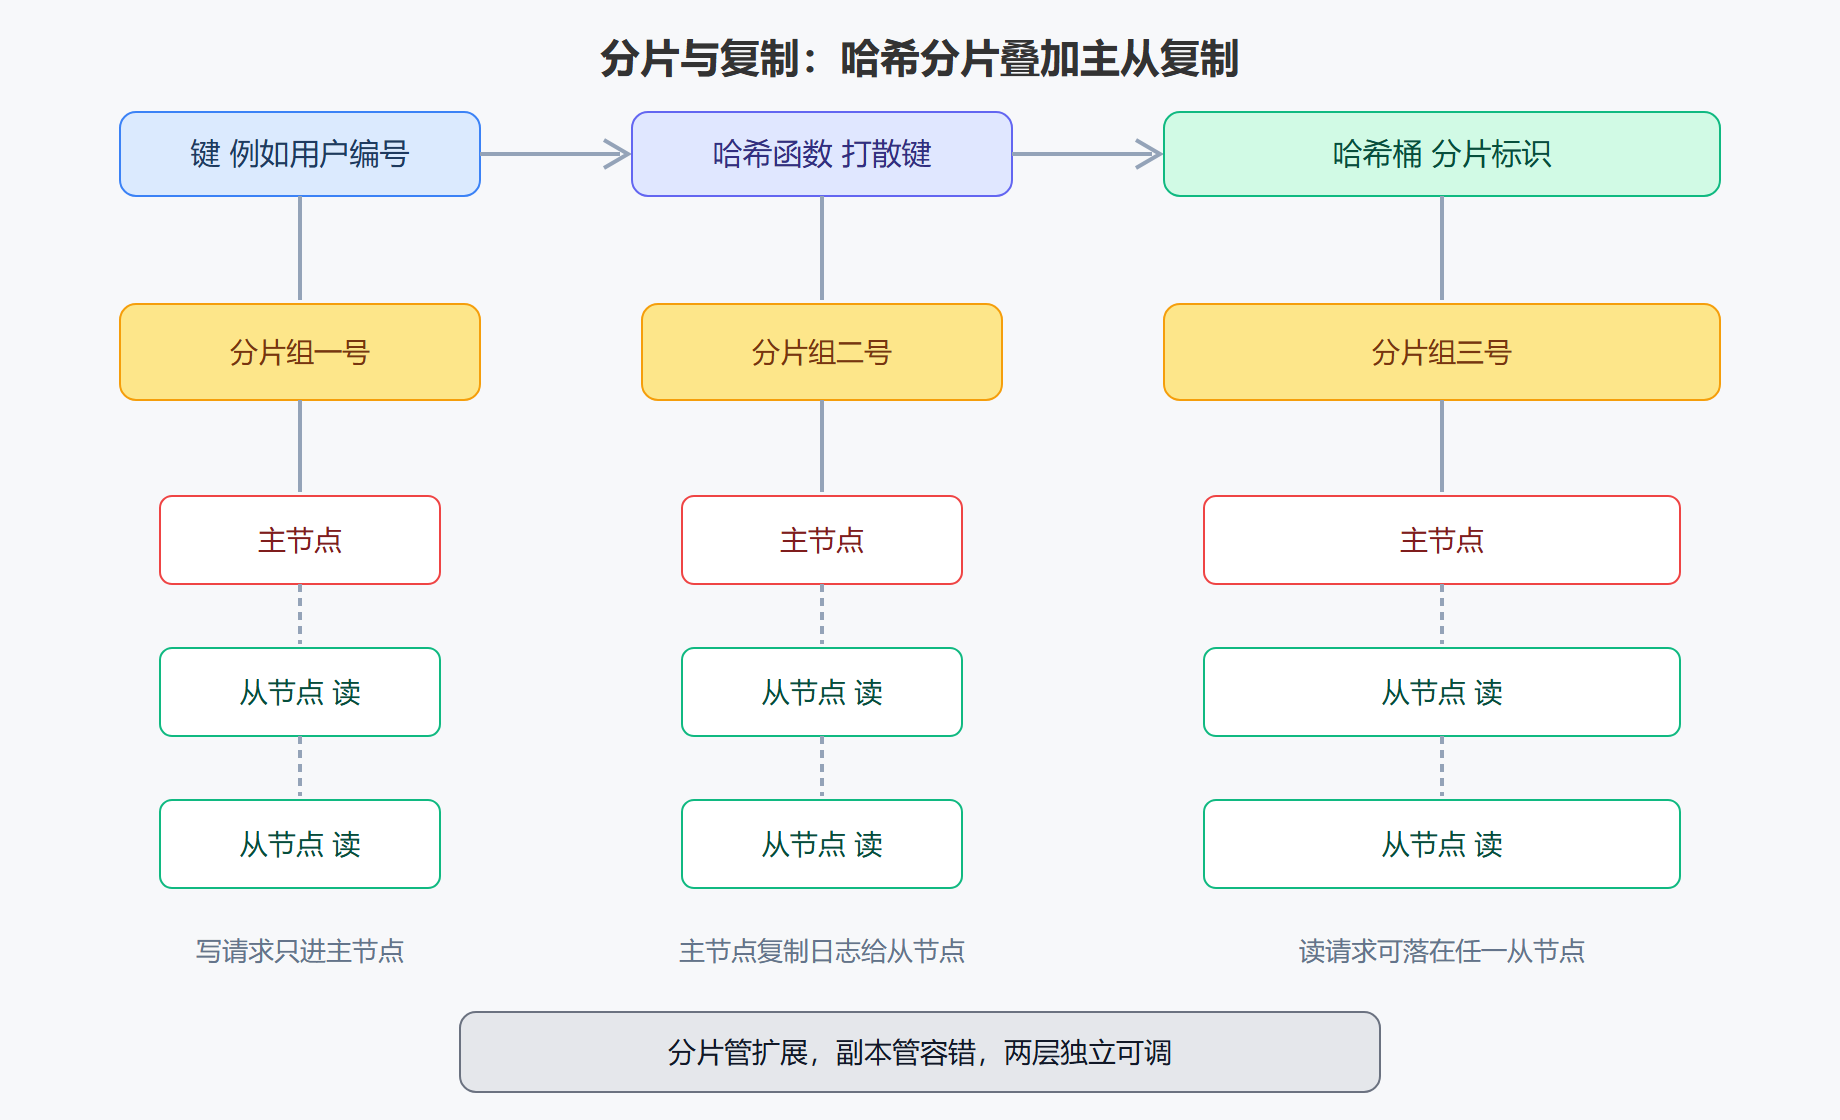
💡 关键直觉:分片和复制是两根独立的旋钮。想要更大的容量,就多切几个分片;想要更强的容错,就给每个分片多加几个副本。别把它们混成一件事——把"一个分片只配一个副本"当成默认,等于把鸡蛋又放回了同一个篮子。
再往细看,这九个副本(三个分片组、每组三个副本)怎么摆到物理机器上,本身就是一道题。如果同一组的三个副本恰好落在同一个机架上,机架断电就三个一起没,复制形同虚设;如果完全打散到不同机架甚至不同机房,网络往返又会拖慢写。所以真正落地的系统,都会在副本摆放上加约束——让同一组的副本尽量跨机架、跨可用区,同时又不至于跨得太远。分片管的是"数据在逻辑上归谁",副本摆放管的是"这些副本在物理上怎么错开",两件事要一起排。
五、工程上的三个取舍
第一,分片键要贴着查询走。分片键决定了哪些查询能落在单个分片、哪些要广播。订单表如果用用户编号做分片键,按用户查订单很快,但按日期统计订单就得扫全部分片。反过来用日期做分片键,统计快了,但单个用户的订单会散落在很多分片里。没有万能键,只有"为最主要的查询优化"。
第二,副本数要按故障模型定。三副本能容忍一台机器坏,五副本能容忍两台。但副本越多,写放大越严重,存储和网络成本也越高。多数系统默认三副本,不是拍脑袋,而是"一台坏还能活,两台同时坏的场景通常可以接受"这个折中。
第三,同步还是异步,看数据能不能丢。异步复制延迟低,但主挂了可能丢最近几条写;同步复制不丢写,但每笔写都要等从节点确认,延迟上升。很多数据库用"半同步"折中:至少等一个从节点落盘,其余异步跟进。这样既保住了绝大多数写,又没把延迟推到最坏情况。
要点串联
- 分片解决放不下,复制解决怕坏掉:一个管水平扩展,一个管容错,是两个维度。
- 范围分片利于范围查询但易倾斜:新数据集中会导致尾部分片过载。
- 哈希分片负载均匀但丢了范围查询:扩容时取模变化还会引发迁移风暴。
- 一致性哈希用环形映射降低迁移成本:代价是引入虚拟节点和环管理复杂度。
- 主从复制写单点、冲突少:主挂了要切换,异步复制下可能丢最近几条写。
- 多主复制消除写单点但带来冲突:两个节点同时写,需要冲突解决策略。
- 无主复制靠读写法定人数控制一致性:灵活性最高,一致性责任下放到客户端。
- 分片键要贴着查询走,副本数要按故障模型定:没有万能键,只有为最主要查询优化。
数据切开了、抄多了,跨节点的写操作就躲不掉了。下一节我们看一次写横跨多个分片时,怎么保证它要么全成、要么全不成——这就是分布式事务与共识。