5.3 分布式事务与协调
5.3 分布式事务与协调
本节摘要:数据切开、抄成多份之后,一次写操作可能同时落在多个节点上,这时"要么全成、要么全不成"的原子性就没那么理所当然了。两阶段提交用一个协调者把所有参与者先问一遍、再统一下令,简单却有个要命的阻塞问题;三阶段提交用预提交缓冲缓解了它,代价是多一轮通信。更底层的 Paxos 与 Raft 用多数派投票和领导人选举,在节点会宕机、网络会分区的前提下让一群节点达成一致。这就是分布式事务与共识。
先说结论
阅读完本节,你应当能够:
- 说明为什么单机的原子性到分布式环境里会失效。
- 画出两阶段提交的准备阶段与提交阶段,并指出它的阻塞问题。
- 说清三阶段提交如何缓解阻塞,以及它付出了什么代价。
- 用选举类比解释 Raft 的领导人选举、日志复制和任期。
- 比较两阶段提交、Saga、TCC 三种事务方案的适用场景。
一、一次转账,怎么就那么难
在单机数据库里,"原子性"几乎不需要想。一条事务里扣 A 账户一百块、加 B 账户一百块,要么都执行,要么都回滚,数据库引擎自己就管好了。可一旦 A 账户在机器一上、B 账户在机器二上,事情就变了:你没法用一个内存里的锁管理两个进程,也没法用一条本地日志同时覆盖两台机器。你要在两台可能随时宕机、中间还隔着一张会丢包网络的机器之间,保证"要么都成,要么都不成"。
更麻烦的是,这两台机器可能分属不同系统:一笔电商下单,库存服务扣库存、订单服务建订单、支付服务冻结金额、物流服务预占运力。四个服务各自独立部署、各自有自己的数据库,它们之间没有共享内存,也没有一个天然的"全局事务管理器"。这时,"事务"这个词的含义已经从数据库内部的一段保护上下文,变成了几个服务之间的一份约定——大家说好,在失败时共同收敛到一个可理解的状态。
这正是分布式事务要解决的元问题:在不确定的节点和网络上,人为构造出一个确定的"全成或全不成"的契约。而这份契约的履行者,是一个叫协调者的角色。
先立类比。协调者像一场多人会议的召集人:他要把议题(写操作)发给每个参会人(参与者),问大家"你能不能签字?",收集所有人的回答,再统一宣布"通过"或"作废"。麻烦在于,召集人自己也可能中途失联——他问了一半,人不见了,剩下的人该签字还是该作废?这个问题,就是整个分布式事务领域的核心难题。
二、两阶段提交:先问后做
两阶段提交,简称 2PC,是这个领域最老也最基础的协议。它把一次原子提交拆成两个阶段。
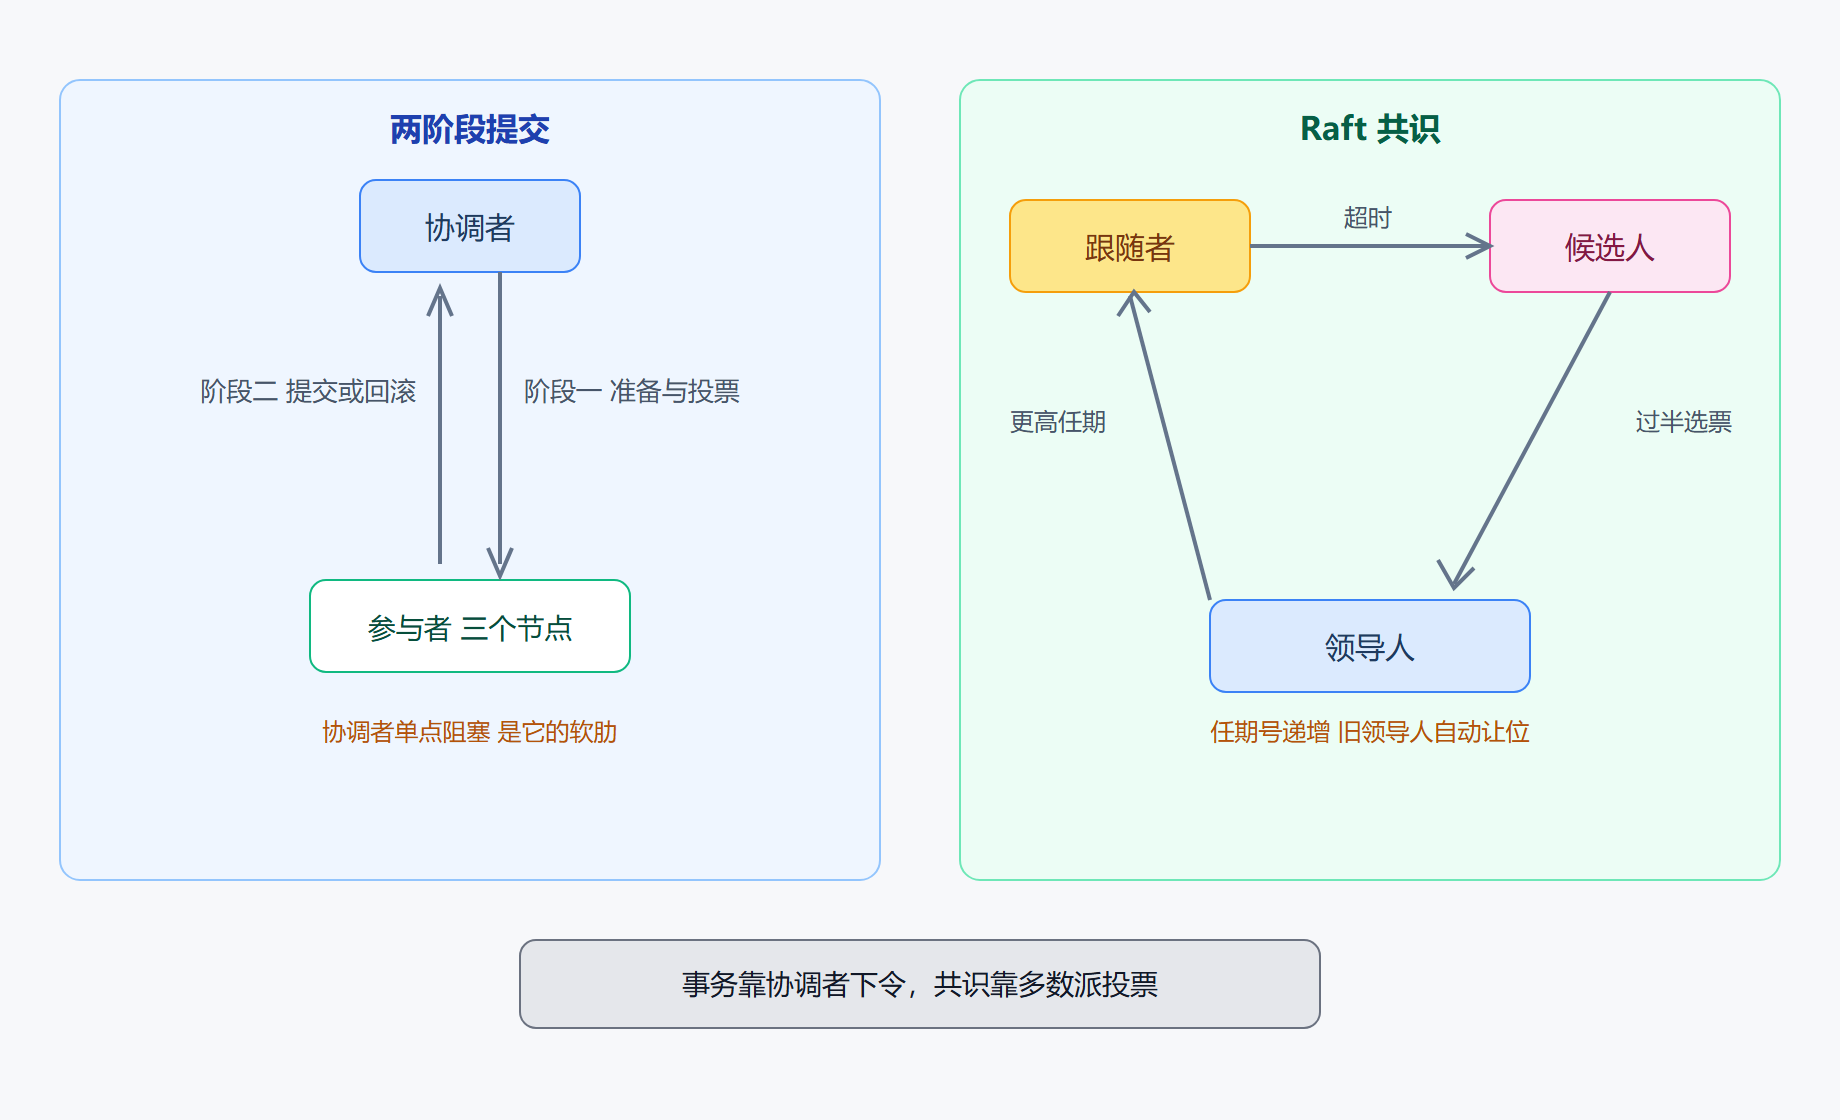
第一阶段叫准备。协调者给所有参与者发"准备提交"的请求。每个参与者收到后,把这次写操作要改的数据先落好盘、拿好锁、写好预写日志,然后回一个确定的答复:能提交,或者不能提交。到这一阶段结束,每个参与者都表了态,但谁都还没真正提交。
第二阶段叫提交。协调者收集所有答复。如果所有人都说"能",它就广播"提交",所有参与者真正把改动生效;只要有一个人说"不能",或者有人没回应,它就广播"回滚",所有人把改动撤销。
这个协议胜在简单、可预测、好审计,所以成了工业界的事实标准,XA 协议就是它的一种落地。但它有个著名的软肋,叫协调者单点阻塞:如果协调者在发出最终决定之前崩溃了,那些已经进入"准备"状态、锁着资源的参与者,就只能干等。它们不知道是提交还是回滚,也不敢擅自决定,于是事务一直挂起,相关数据一直锁着。一个宕机的协调者,能拖死一片业务。
两阶段提交的流程
⚠️ 常见坑:2PC 的"能提交"答复之后,参与者就失去了自主权。协调者一旦失联,参与者既不能单方面提交、也不能单方面回滚,只能锁着资源干等。所以生产环境里,2PC 一定要配超时和人工介入机制,否则一次协调者故障就会变成长时间的业务阻塞。
三阶段提交,简称 3PC,就是冲着这个阻塞问题去的。它在"准备"和"提交"之间插了一个"预提交"阶段:协调者先发"预提交",参与者进入预提交状态后,承诺除非收到明确的中止指令,否则超时后会自动提交。这样即使协调者挂了,参与者也不会无限期阻塞,超时后能自行决定。代价是多一轮网络往返,消息开销更大,而且它依然无法彻底解决脑裂——网络分区时,协调者联系不上部分参与者,剩下的人可能误判全局状态。
三、共识:让一群节点自己选出一个结果
2PC 和 3PC 解决的是"一次事务"的原子性。但分布式系统里还有一类更底层的问题:一群节点,怎么在没有中央权威的情况下,就某个值达成一致?比如哪个节点当主、日志的顺序是什么。这就是分布式共识,Paxos 和 Raft 是它的两个代表。
Paxos 是共识问题的经典解法,正确性完备,但出了名的难懂——论文里充满角色和阶段的定义,读起来像绕迷宫。Raft 则是把它翻译成了人话。Raft 的核心,是把共识拆成三个清晰的部分,并且用一个"选举"的类比贯穿始终。
领导人选举:集群里的节点有三种角色——跟随者、候选人、领导人。系统启动时大家都是跟随者。如果跟随者一段时间没收到领导人的心跳,就认为领导人可能挂了,自己转成候选人,发起一轮选举,请其他节点投票。拿到过半票数的候选人当选新领导人。任期这个概念贯穿全程:每轮选举都有个任期号,任期号更大的总是更权威,这避免了旧领导人和新领导人同时发号施令。
日志复制:选出来的领导人负责接收客户端的写请求,把写操作作为一条日志追加到自己的日志里,再把这条日志复制给所有跟随者。只有当日志被过半节点确认复制了,才算"已提交",领导人才能把它应用到状态机、返回客户端成功。这"过半"很关键——它保证了即使领导人之后挂掉,新选出的领导人手里一定已经握着所有已提交的日志。
安全性:Raft 用一系列约束保证不会出现"已提交的日志被新领导人覆盖"这种事故。比如,只有日志足够新的候选人才能当选领导人;领导人在任期内不会删除或覆盖已提交的条目。这些约束看似琐碎,却是把"多数派"这个模糊概念落到"安全"的实处。
Raft 的三种角色与选举
💡 关键直觉:共识算法的核心技巧,是"过半"。任何两个过半的集合必有交集,所以每一轮多数派的决定,都会被下一轮看到。选主、提交日志、判断提交与否,全都靠这个交集传递记忆。想通了这一点,Raft 和 Paxos 的很多细节就不再神秘。
把两阶段提交和 Raft 并排放在一起,能看清"一次事务的原子性"和"一群节点的共识"这两件事的区别与联系:
共识与协调:两阶段提交与 Raft 流程
四、事务方案的工程光谱
把理论放到工程里,跨节点写操作大致有三种方案,各有各的代价。
两阶段提交,以及它的衍生 XA 事务:强一致、语义清晰,适合对原子性要求极高、且参与方都在可控范围内的场景,比如一个数据库集群内部的跨分片事务。它的代价是阻塞风险和高延迟,跨服务、跨组织的场景里通常不合适,因为没人愿意为一个外部服务的故障锁住自己的资源。
Saga 长事务:把一个大的跨服务事务拆成一系列本地事务,每个本地事务配一个对应的补偿动作。前面的步骤成功了,后面的步骤失败,就按相反顺序执行补偿,把前面已成功的步骤"撤销"掉。它不追求瞬时原子性,而是追求"最终要么全成、要么通过补偿全部还原"。适合订单、差旅这类跨多个独立服务的场景。代价是要自己写好每一步的补偿逻辑,还得保证补偿本身幂等、可重试。
TCC 补偿事务:把每个参与方对事务的参与拆成三个动作——Try 尝试(预留资源)、Confirm 确认(真正执行)、Cancel 取消(释放预留资源)。它比 Saga 更细粒度,能在一开始就预留好资源、避免后期冲突,但要求业务方深度改造接口,侵入性强。
分布式事务方案对比
| 方案 | 原子性 | 性能 | 业务侵入 | 适用场景 |
|---|---|---|---|---|
| 两阶段提交 | 强,瞬时 | 低,阻塞风险 | 低 | 集群内跨分片事务 |
| Saga | 最终,靠补偿 | 高 | 中,写补偿逻辑 | 跨服务长事务、订单流程 |
| TCC | 强,靠预留 | 中 | 高,改接口 | 资金、库存的精细化控制 |
💡 关键直觉:分布式事务的"完美"不存在,只有"在特定故障模型和业务约束下足够好"。你能选择的不该是"用不用事务",而是"这个写操作,是要强一致地瞬间完成,还是可以接受短暂不一致、靠补偿在后台收口"。前者选 2PC 或 TCC,后者选 Saga 或最终一致。
五、怎么选,看两个问题
落到具体决策,我习惯先问两个问题。
第一个问题:这次写操作,读到或看到中间状态会造成什么后果? 如果是转账,中间状态(一边扣了一边没加)绝对不能暴露,那就得往强一致靠,2PC、TCC,或者在分区时干脆拒绝写入。如果是电商下单,库存短暂地多扣或少扣一点点,可以靠对账和补偿兜回来,那 Saga 和最终一致就够用,还能换来更好的吞吐和可用性。
第二个问题:参与方是不是都在你能控制的范围内? 如果都在同一个数据库集群内部,2PC 的阻塞风险可控,代价能接受。如果跨越多个独立团队的服务,甚至跨越公司边界,2PC 的协调者单点和阻塞问题会被放大到不可接受,这时 Saga 或消息驱动的最终一致更现实——因为没人愿意为了别人的慢或故障,把自己的资源长期锁住。
这两个问题问清楚,分布式事务的选型基本就有了答案。剩下的,是把这个答案落到幂等、重试、补偿这些工程细节上。
温故知新
- 原子性在分布式环境里失效:没有共享内存和全局日志,跨节点写要靠协议重新构造。
- 两阶段提交先问后做:准备阶段收集表态,提交阶段统一下令,简单但协调者会单点阻塞。
- 三阶段提交用预提交缓解阻塞:代价是多一轮通信,且仍不能彻底解决脑裂。
- Raft 用选举类比讲共识:跟随者、候选人、领导人三种角色,任期号隔离历史阶段。
- 过半是共识的核心技巧:任意两个过半集合必有交集,靠这个交集传递记忆。
- Saga 靠补偿实现最终原子性:适合跨服务长事务,但每一步的补偿要幂等可重试。
- 选型看两个问题:中间状态能不能暴露,参与方是不是都在可控范围内。
分布式系统的三节到这里就收束了:理论给了语言,分布与复制给了骨架,事务与共识给了动作。带着这套框架,第 6 章我们会看到它如何长出云原生数据库、内存数据库这些具体的形态。