1.1 立案:一次线上延迟事故的取证流程
1.1 立案:一次线上延迟事故的取证流程
性能故障的取证流程是指从告警触发到根因确认的标准动作序列:保全现场、采集证据、建立假设、验证定罪。本节用一个 P99 延迟翻倍的事故案例,走完整个流程并给出每步的具体命令。
从一个告警说起
凌晨两点,监控打来电话:支付服务的 P99 延迟从 120ms 涨到了 470ms,错误率没变,CPU 也没满。值班同学的第一反应是重启——好在被拦住了。重启之后,现场就没了,明天同样的事故还会来,而你手里没有任何证据。
正确的动作序列是:
- 保全现场:先把当前状态拍快照,再考虑动系统;
- 采集证据:确认是哪类资源的问题;
- 建立假设:给出可以证伪的猜想;
- 验证定罪:用数据支撑假设,修复后复核。
第一步:保全现场
现场信息分两种:会消失的和会累积的。会消失的优先抢救——进程当前的调用栈、打开的文件、TCP 连接状态、内核计数器。这些东西重启后就再也要不回来。
# 抢救型证据(会消失,先抓) cat /proc/<pid>/stack # 进程内核栈 ss -tanp | grep <pid> # TCP 连接状态分布 cat /proc/net/snmp # TCP 重传等计数器快照 pidstat -p <pid> -w 1 5 # 上下文切换采样 # 留档型证据(会累积,也要留基线) vmstat 1 10 > vmstat.log iostat -x 1 10 > iostat.log sar -n DEV 1 10 > sar_dev.log
⚠️ 常见坑:把
top截图当现场。top的瞬时值噪声极大,而且看不出队列深度和等待时间,至少要pidstat/vmstat这种带时间序列的采样。
现场快照的保存策略
把上面这些输出统一落到带时间戳的目录里,事故结案后它就是"案卷",用于复盘和与下次事故比对。没有历史案卷的性能团队,每次都是从零开始办案。
第二步:采集证据,粗定位资源类型
延迟涨了,无非四个方向:CPU 不够、内存吃紧、IO 等待、锁或外部依赖等待。先看进程的上下文切换和运行状态:
vmstat 1 5
关注两列:r(等待 CPU 的 runnable 线程数,持续大于 CPU 核数说明 CPU 饱和)和 wa(iowait 比例,持续高于 10% 值得追查)。本案里 r 平稳、wa 为 0,CPU 和磁盘 IO 初步排除。
再看 pidstat -w 的输出: voluntary context switch 每秒上万——线程在频繁让出 CPU,典型的锁竞争或阻塞在某个系统调用上。嫌疑范围收窄到"等待"。
第三步:建立假设
到了这一步才轮到"猜",而且猜法必须可证伪。当时的假设是:
数据库连接池耗尽,业务线程在
poll上排队,等待连接归还。
证伪手段:如果连接池真的耗尽,那么活跃连接数应该顶到上限,且 pstack 里能看到大量线程停在 poll/read 上。
第四步:验证定罪
# 看线程到底停在哪 cat /proc/<pid>/task/*/stack | sort | uniq -c | sort -rn
输出里 200 多个线程的栈顶都落在同一路径上,配合连接池监控曲线(活跃连接钉死在上限),假设成立。修复动作是排查连接泄漏的代码路径,而不是加机器。修复后 P99 回到 130ms,证据链闭合。
取证流程全景
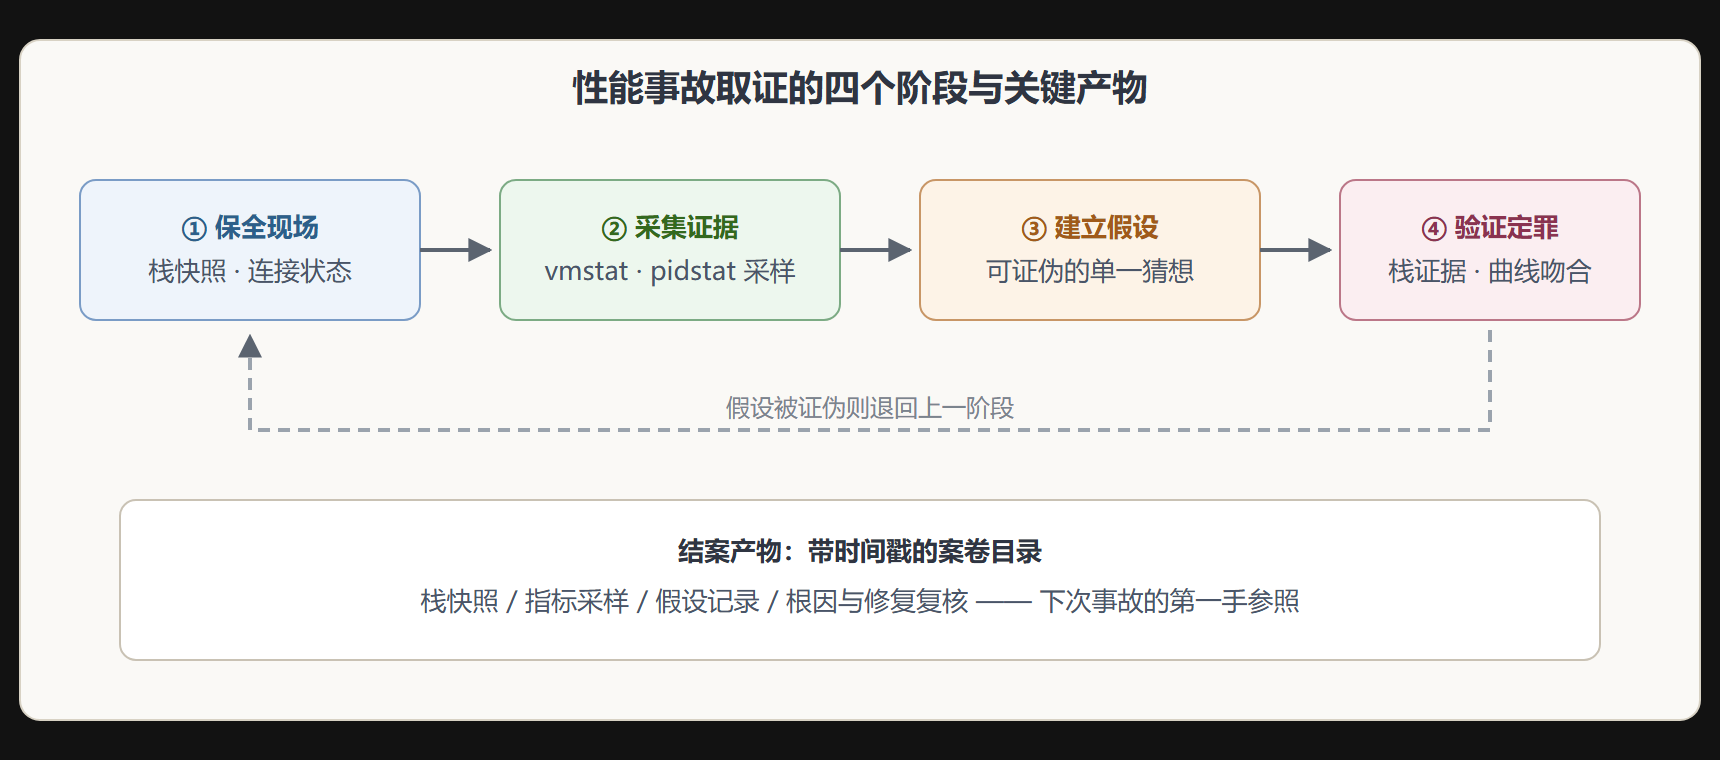
本节要点回顾
- 先取证再动手:重启、扩容、改配置都会污染现场,动手前先把
/proc快照和时间序列采样落盘; - 会消失的证据优先:内核栈、连接状态、线程等待点,重启即蒸发;
vmstat的r与wa是最快的资源粗判,一步把嫌疑从四类压到一两类;- 假设必须可证伪:写下"如果是 X,就应该能看到 Y",然后去找 Y 或它的缺席;
- 结案要归档:案卷是团队对抗重复事故的复利。
下一节我们把"证据"本身讲清楚:哪些指标能构成可信的证据链。
延伸:把取证流程固化成值班脚本
口头流程靠不住,凌晨三点的人只会做肌肉记忆里的事。成熟的团队把"保全现场"做成一条命令,值班同学敲下去,两分钟内所有会消失的证据自动落盘:
#!/usr/bin/env bash # evidence-snapshot.sh <pid> —— 事故现场一键取证 PID=$1; TS=$(date +%Y%m%d_%H%M%S); DIR=/var/case/$TS mkdir -p "$DIR" timeout 10 cat /proc/$PID/stack > "$DIR/kstack.txt" 2>&1 timeout 10 cat /proc/$PID/status > "$DIR/status.txt" timeout 10 ls -l /proc/$PID/fd > "$DIR/fds.txt" timeout 10 cat /proc/$PID/limits > "$DIR/limits.txt" timeout 10 ss -tanp > "$DIR/ss.txt" 2>/dev/null timeout 10 cat /proc/net/netstat > "$DIR/netstat.txt" timeout 60 pidstat -p $PID -wurt 1 30 > "$DIR/pidstat.txt" timeout 30 vmstat 1 10 > "$DIR/vmstat.txt" echo "case saved to $DIR"
脚本本身要进版本库、常备演练。一个从未演练过的取证脚本,在真实事故里几乎一定会因为权限、路径或超时参数问题半途而废——那等于事故现场只保护了一半。
延伸:结案报告的最小字段
证据链闭合后,案卷要能回答四个问题,否则复盘会退化成讲故事:事故窗口的精确起止时间、根因的证据(哪条命令的哪行输出)、为什么监控没能更早发现、修复后用什么指标验证不会复发。把这四项写成模板,每起事故强制填写,团队的排查能力才会随案卷数量复利增长。
[结案报告模板] 影响窗口: 02:14 - 02:52 (P99 120ms -> 470ms) 定罪证据: /proc/<pid>/task/*/stack 200+ 线程停在 poll; 连接池活跃数钉死在上限 200 监控盲区: 连接池等待线程数未纳入告警, 只有 pool 使用率 防复发: 新增 pool waiters > 10 持续 2min 告警; 泄漏路径已加 must-close 断言, 灰度 3 天无复发