1.2 证据链:性能指标体系与度量模型
1.2 证据链:性能指标体系与度量模型
性能指标体系由延迟、吞吐、利用率、饱和度、错误率五类指标构成,单独任何一项都不能定罪,组合起来才形成证据链。本节讲每类指标的取证价值、平均值的陷阱,以及 USE 方法这套"验伤标准"。
一份指标,各有各的证词
五类指标像五个证人,各说各的视角:
| 指标 | 回答的问题 | 典型来源 | 单独看的误导 |
|---|---|---|---|
| 延迟(Latency) | 一个操作多快 | 打点、追踪系统 | 含重试时会掩盖故障 |
| 吞吐(Throughput) | 单位时间做了多少 | 计数器差值 | 高吞吐可能靠排队撑着 |
| 利用率(Utilization) | 资源忙的比例 | /proc/stat、iostat |
忙不等于有产出 |
| 饱和度(Saturation) | 排队有多严重 | 运行队列、队列深度 | 需结合利用率看 |
| 错误率(Errors) | 失败了多少 | 日志、重传计数 | 静默失败不计入 |
注意利用率这一行:"忙"不等于"有产出"。CPU 100% 可能是在做有用的计算,也可能在自旋锁上空转;磁盘 100% util 可能顺序大块读写(健康),也可能是队列堆满的小 IO(病态)。这就是为什么利用率必须和饱和度、吞吐一起看。
平均值的陷阱
事故通报里写"平均延迟 80ms,一切正常",而用户在骂街——因为 1% 的请求花了 3 秒。平均值对长尾分布极其不敏感,而用户体验恰恰由长尾决定。
正确的做法是看分位数:
P50 = 45ms 一半用户的体验 P90 = 96ms 十分之一用户的下限 P99 = 480ms 百分之一用户的下限 ← 告警应该盯这里 P99.9 = 2.1s 尾部中的尾部,通常是锁竞争或 GC
💡 关键直觉:P99 恶化而 P50 稳定,嫌疑多半在"偶发等待"——锁、IO 抖动、GC 停顿;P50 与 P99 同步恶化,才是容量类问题。这个分流判断在办案初期非常省时间。
还有一个隐蔽的坑:** coordinated omission**(协同遗漏)。如果你用固定频率主动发探测请求,遇到慢请求时后续探测会被推迟,恰好躲开了最慢的时间窗——测出来的分位数系统性偏乐观。选用支持"根据发送时刻而非完成时刻对齐"的度量工具可以规避。
USE 方法:给每类资源验伤
Brendan Gregg 提出的 USE 方法是套用性极强的检查规程:对每种资源(CPU、内存、磁盘、网络)依次检查三样东西——
- Utilization:利用率多高?
- Saturation:还有多少工作在排队?
- Errors:有没有报错?
资源 Utilization Saturation Errors CPU mpstat CPU% vmstat r 列 machine check 内存 free 可用率 si/so 换页、OOM ECC 错误 磁盘 iostat %util iostat aqu-sz 队列深度 dmesg IO 错误 网络 带宽占用 重传率、丢包 ifconfig errors
指标体系分层
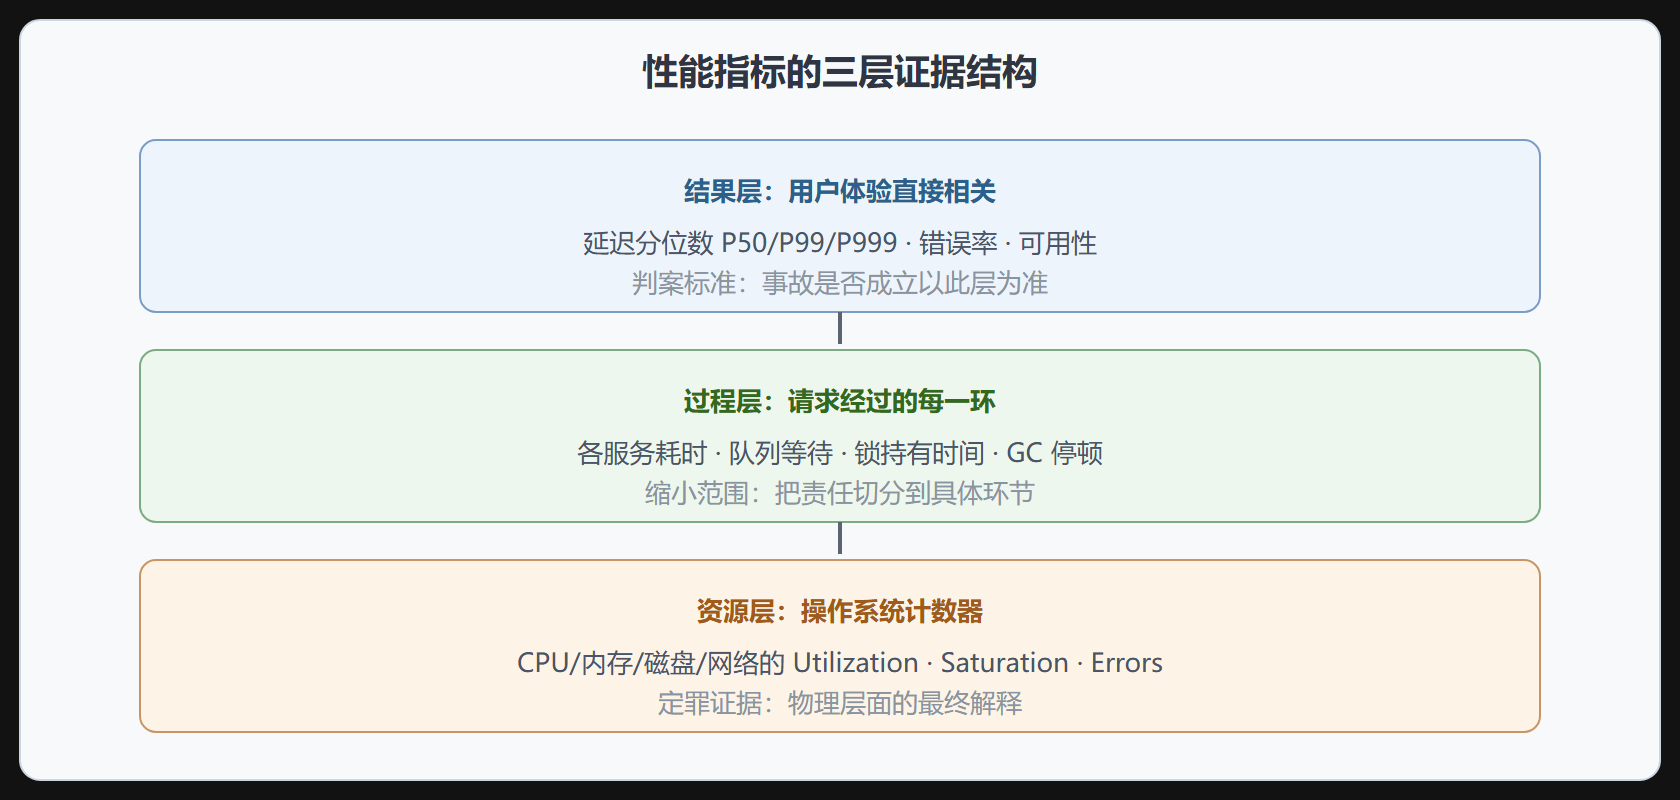
三层结构的用法:结果层报警(P99 恶化),过程层切责任(慢在哪一环),资源层给终审(哪个物理资源饱和)。跳层是常见错误——从结果层直接扎进 CPU 利用率,很容易把症状当根因。
RED 与四黄金信号
面向服务(尤其是微服务)还有两套精简版指标集:
- RED:Rate(请求速率)、Errors(错误率)、Duration(延迟分布),每个服务三个指标,监控面板的标准起点;
- 四黄金信号:延迟、流量、错误、饱和度,来自 Google SRE 的实践,比 RED 多了饱和度维度。
我的实践取舍:服务监控用 RED 起步(简单、覆盖 80% 场景),加上实例级的饱和度指标兜底;排查时再切换到 USE 的逐资源检查。两套不是竞争关系,一个面向"服务健康",一个面向"资源健康"。
本节要点回顾
- 五类指标各有限盲区:利用率"忙不等于有产出",必须与饱和度配对使用;
- 看分位数不看平均值:P50 稳定 + P99 恶化指向偶发等待,同步恶化指向容量不足;
- 警惕协同遗漏:固定频率探测会系统性低估长尾;
- USE 方法给每类资源做 Utilization/Saturation/Errors 三连检,是排查时的标准动作;
- 三层指标结构(结果/过程/资源)规定了解释权:定罪必须落到资源层。
指标是证词,但采证动作本身会惊动嫌疑人——下一节谈观察者效应。
延伸:用显著性检验避免"噪声定罪"
延迟类指标是分布,不是单点。P99 从 120ms 波动到 135ms 可能只是流量构成变化,直接当成事故根因会把团队引向死胡同。立案前先做一次廉价的两样本检验,把"证据"与"噪声"分开:
import numpy as np from scipy import stats baseline = np.array([118, 122, 119, 125, 121, 130, 117, 123, 120, 124]) # 昨日同时段 P99 current = np.array([455, 462, 448, 470, 510, 440, 466, 458, 472, 461]) # 事故窗口 P99 u, p = stats.mannwhitneyu(baseline, current, alternative="two-sided") effect = current.mean() / baseline.mean() print(f"p={p:.2e}, 均值放大 {effect:.1f}x") # p << 0.001 且放大 3.8 倍 -> 显著劣化, 可以立案
反过来,p 值不显著或放大倍数小于 1.1 时,正确动作是继续观察而不是拉群排查。把这条规则写进值班手册,能砍掉大量"查了三小时什么都不是"的无效立案。
延伸:指标口径对齐清单
同一指标在不同层的口径经常对不上:负载均衡器统计的是"收到完整响应",应用统计的是"业务逻辑耗时",数据库统计的是"查询执行"。对账时先列口径差异表——是否包含排队、序列化、网络传输;是均值还是分位;采样窗口是否对齐。口径没对齐之前,任何跨层比对都是无效证据。一个实用做法是在压测环境注入固定 100ms 的人为延迟,看它逐层衰减还是放大,据此标定每层测量仪器的"读数误差"。
[口径对齐表示例] 层 统计点 含排队 含序列化 分位 LB resp_time 是 是 p99 App handler_rt 否 否 p99 DB exec_time 否 否 avg => LB - App ≈ 网络+反序列化; App - DB ≈ 连接池等待+ORM开销