1.3 观察者效应:观测开销与海森Bug
1.3 观察者效应:观测开销与海森 Bug
观测开销指性能工具介入目标系统后引入的额外负担;海森 Bug(Heisenbug)指因观测行为本身而改变或消失的缺陷。任何测量都会扰动被测对象,性能工程的功夫之一,是在"看得清"和"扰动小"之间选对位置。
一个消失的死锁
有个经典段子式的真实场景:一个服务每隔几天死锁一次,工程师在关键路径加了详细日志,准备抓个现行——结果死锁再也不发生了。日志的加锁和 IO 改变了线程调度时序,竞态窗口被挤没了。这种"一观测就消失"的缺陷就叫海森 Bug,名字是对海森堡不确定性原理的致敬。
对应的反面是玻尔 Bug(Bohrbug):稳定复现、条件明确的缺陷。两者的办案策略完全不同:
| 玻尔 Bug | 海森 Bug | |
|---|---|---|
| 复现 | 给定条件必现 | 时有时无,观测即变 |
| 首选工具 | GDB 断点单步 | 低扰动采样、动态追踪 |
| 策略 | 白盒逐行审 | 黑盒统计、事后验尸 |
| 危险操作 | 几乎没有 | 断点、strace、verbose 日志 |
扰动从哪来:三类开销
观测工具的扰动不只是"变慢",要拆开看:
- 时间开销:探针触发时暂停目标线程、拷贝数据。strace 走 ptrace 机制,每个系统调用两次上下文切换,让 IO 密集型程序慢一个数量级是常态;
- 时序开销:探针引入的延迟改变了竞态窗口——这是海森 Bug 的直接来源;
- 内存/存储开销:全量追踪一分钟的 MySQL 可能产生几十 GB 数据,磁盘先于问题被打满。
对比一下主流手段的典型开销量级:
手段 典型 CPU 开销 时序扰动 适用场景 printf 日志 1% ~ 10% 高 开发环境 GDB 断点 暂停级 极高 本地复现调试 strace 系统调用级 20% ~ 10 倍 高 查"卡在哪"而非查性能 perf 采样 99Hz < 3% 低 生产可用 eBPF 定向追踪 < 1% 起 低 生产可用
⚠️ 常见坑:用
strace诊断"程序为什么慢",然后得出"系统调用多所以慢"的结论——调用多可能是 strace 之前就存在的正常行为,慢恰恰是 strace 自己造成的。strace 回答"卡在哪个系统调用",不回答"性能差在哪"。
采样为什么扰动小
采样的扰动经济学值得单独说:以 99Hz 对进程采样,相当于每秒瞄 99 眼,每眼微秒级,其余 99.99% 的时间程序完全不被打扰。追踪(tracing)则是"盯梢"——每个事件都要记录,事件越密开销越大。
代价是采样有盲区:只跑了 1 毫秒的函数大概率一次都没被采到。所以局部的、短暂的异常(一次性锁等待、偶发 IO 抖动)要用追踪抓,全局的、持续的热点用采样找。两者是互补关系,第 2 章会展开。
开销与精度的取舍空间
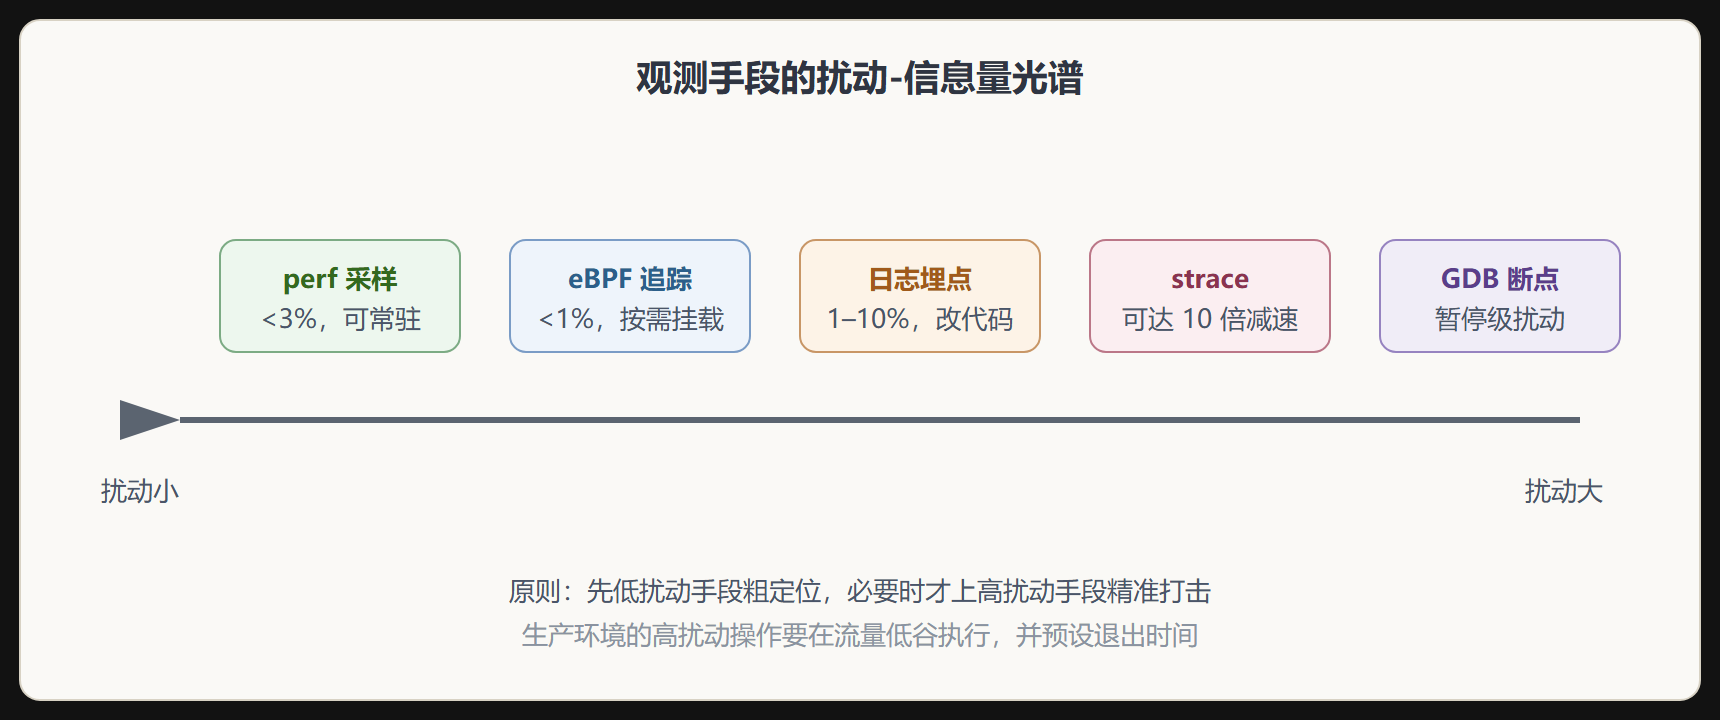
降低扰动的工程手法
- 限流采证:eBPF 程序里对事件做内核态聚合(直方图、计数器),只把摘要传回用户态,避免事件风暴;
- 采样率分档:平时 10Hz 的持续剖析,事故时临时升到 99Hz,取证完毕降回;
- 旁路落盘:探针数据写本地内存环形缓冲区,由独立进程异步消费,不在目标线程上做 IO;
- 时间盒:给高扰动操作设定最长存活时间(比如 60 秒后自动卸载探针),防止取证动作本身酿成事故。
本节要点回顾
- 测量必扰动:时间、时序、存储三重开销,其中时序扰动直接制造海森 Bug;
- strace 查"卡在哪",perf 查"慢在哪",用错工具会得出因果倒置的结论;
- 采样靠抽查、追踪靠盯梢:持续热点用采样,偶发异常用追踪;
- 降扰动的三板斧:内核态聚合、采样分档、旁路异步落盘;
- 高扰动操作要时间盒,生产环境的取证动作本身必须可控。
下一章进入机制层:采样和追踪的探针到底怎么挂进内核与 CPU。
延伸:量化观测开销的标准实验
"加了日志就复现不了"不能停留在直觉,开销要量化。标准做法是阶梯实验:分别以 0%、1%、10%、100% 的采样率运行同一压测,记录吞吐与延迟的变化曲线,得到该探针的"开销-采样率"斜率,再据此选择生产可接受的上限:
# 阶梯实验:不同采样率下跑同一负载 for RATE in 0 0.01 0.1 1.0; do export PROFILING_SAMPLE_RATE=$RATE wrk -t8 -c256 -d60s --latency http://svc:8080/pay \ | tee overhead_${RATE}.log done # 对比四份日志的 Requests/sec 与 p99,得到每 1% 采样率的代价
典型结论:基于信号器的采样探针在 1% 采样率下开销小于 1%,而逐事件打点日志在同样流量下可能吃掉 15% 以上的 CPU——后者只能用于临时抓取,不能常驻。
延伸:海森Bug 的抓捕策略
观察行为本身改变时序的 Bug(竞争窗口、锁序敏感),正面强攻往往无效。可行策略有三条:把观测点从"进程内"挪到"进程外"(用 eBPF 在内核态旁路采集,不进业务线程);把日志改为异步批量落盘并预先分配缓冲,消除日志本身的 malloc/锁;以及在测试环境用确定性调度工具(如 rr record 的记录回放)先固化执行序列,再在回放里反复检查,观察不再影响被观察者。三条思路的共同点:让证据采集路径与被观测路径解耦。
补充一条排班层面的实践:观察者效应不只是技术问题,也是流程问题。事故自动打开全量调试日志的"应急开关"应当预置在配置中心,但必须同时带自动回收——超过三十分钟自动回落到常规级别,否则下一次压测就把带着全量日志的服务当成真实性能基线收录进监控,之后所有的对比都建立在被污染的基线上。凡动过观测配置的环境,其性能数据要打上"观测期"标记,从容量评估样本里剔除。这类规则看似琐碎,却是取证体系长期可信的卫生前提:测量仪器本身要定期被校准,而"哪些时段仪器被改装过"必须留有台账。
延伸:开销预算的分配原则
多个观测组件叠加时,开销预算要在采集端统一分配而不是各组件各自为政。假设总预算是 CPU 的 3%,日志、指标、剖析、链路追踪各分多少应显式约定:典型分配是剖析 1%、链路采样 1%、指标与日志合计 1%。任何组件想超支,必须从别的组件划拨,这条纪律防止了"每个组件都说自己只占 1%、叠起来占 8%"的经典翻车。落地时在采集 agent 的配置里集中声明各组件配额,并用整机 CPU 画像定期审计实际占用,审计发现某组件长期超额就降它的采样率——预算表与实测对账,和性能本身的取证是同一套方法论。