2.1 采样与追踪:两种取证手法的分野
2.1 采样与追踪:两种取证手法的分野
采样(Sampling)按固定节拍抓取程序瞬时状态,得到统计画像;追踪(Tracing)记录每个感兴趣事件的完整序列。前者像路口的定时抓拍,后者像贴身跟拍。性能数据的采集机制非此即彼,选错手法要么抓不到证据,要么把现场压垮。
两者的本质差异
用一张对比表立住概念:
| 维度 | 采样 | 追踪 |
|---|---|---|
| 数据量 | 固定(采样率 × 时长) | 随事件数增长,无上界 |
| 开销 | 恒定、可预算 | 事件密集时爆炸 |
| 完整性 | 统计近似,有盲区 | 精确到每个事件 |
| 擅长 | 找持续热点 | 抓偶发异常、因果顺序 |
| 典型工具 | perf record、py-spy | ftrace、bpftrace、strace |
关键差异在数据量的性质。采样的开销是常量:99Hz 采 10 秒就是 990 条记录,不管程序多忙。追踪的开销是变量:一个每秒百万次调用的函数,逐事件记录等于让程序背上一个同样每秒百万次的包袱。这就是追踪必须配过滤和聚合的原因。
采样的统计学:它到底可信吗
采样得到的火焰图,本质是对"CPU 时间在调用栈上的分布"做统计估计。置信度规律很直觉:
- 函数占 30% 的 CPU 时间,几百个样本就能稳定检出;
- 函数占 0.1% 的 CPU 时间,需要上万样本,短时间采集根本看不见。
所以有个经验法则:采样对"占 CPU 2% 以上"的问题足够可信,更细的嫌疑要靠追踪。反过来,如果采样图里某个函数已经很显眼,不必怀疑是噪声——能被抽查抓到的都是惯犯。
采样的另一个特性是幸存者偏差:它只看到正在 CPU 上跑的代码(on-CPU)。等锁、等 IO、睡眠的线程几乎不会被采到。Off-CPU 分析因此成为采样的必要补充,第 4 章会专门处理。
追踪的因果链价值
追踪记录事件序列,天然带时间戳和因果关系,这是采样永远给不了的。一次追踪输出类似:
<...> 312.104 mysql mysqld: 入队请求 id=8817 <...> 312.104 mysql mysqld: 拿到行锁 table=orders row=4021 <...> 312.341 mysql mysqld: 释放行锁 row=4021 ← 237ms 后
哪个锁、第几行、持有多久,一清二楚。代价是:这些事件在没过滤时每秒可能有几十万条。所以现代追踪工具的核心能力都体现在内核态过滤——只留 id 大于 8800 的事件、只留持锁超过 100ms 的记录。过滤谓词在事件发生地执行,而不是把事件搬回用户态再扔掉。
混合手法:先抽查,后盯梢
实战标准动作是两段式:
# 第一段:采样找热点(低开销,广覆盖) perf record -F 99 -g -p <pid> -- sleep 10 perf report --sort symbol # 第二段:对可疑函数定向追踪(高信息量,窄范围) # 用 bpftrace 只盯热点函数的执行时长分布 bpftrace -e 'kprobe:vfs_read / @start[tid] / { ... }'
采样与追踪的配合流程
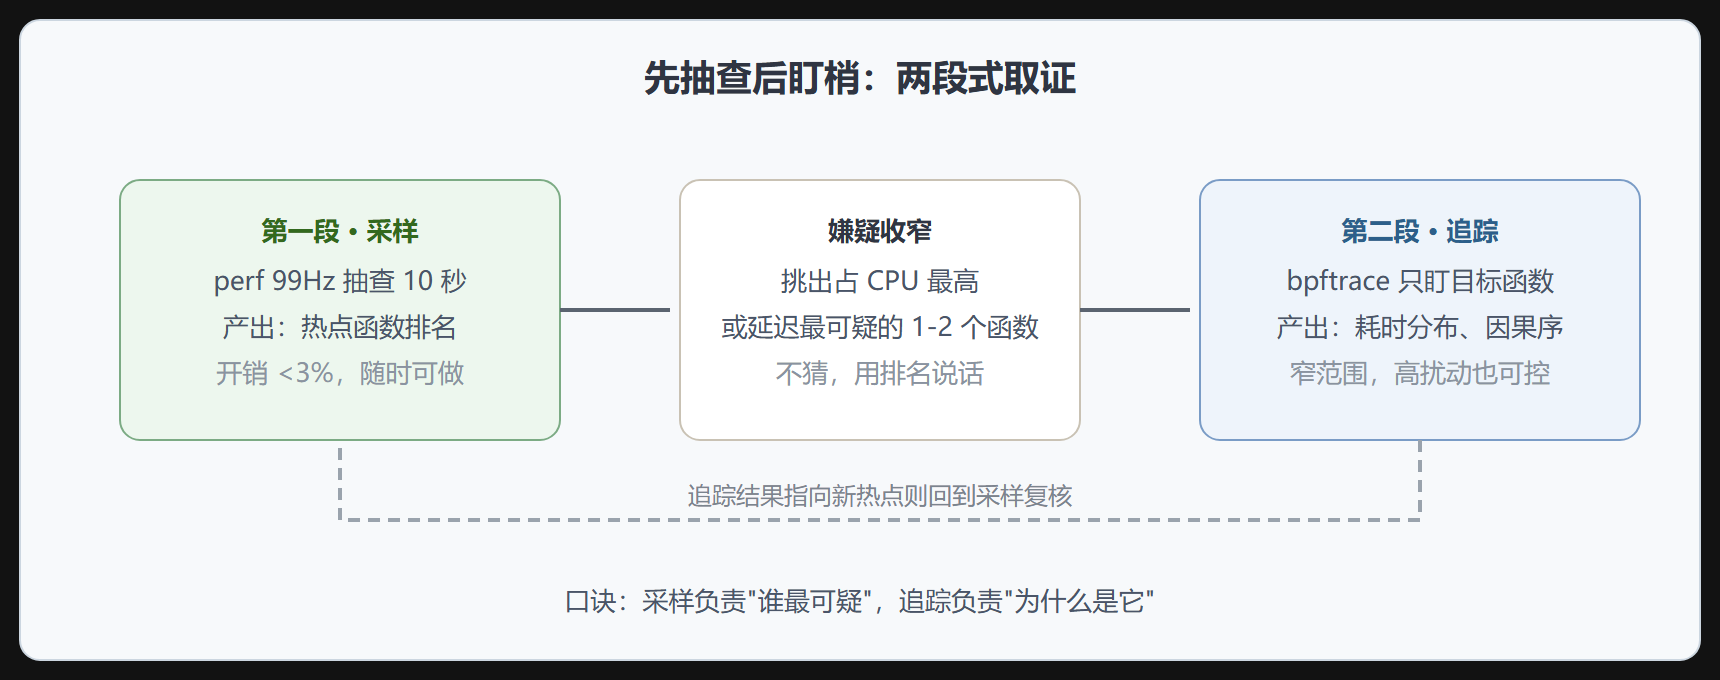
💡 关键直觉:采样回答"谁",追踪回答"为什么"。跳过采样直接全域追踪,是用显微镜找嫌疑人——倍率再高,没有坐标也是白费。
本节要点回顾
- 开销性质不同:采样开销恒定可预算,追踪开销随事件数线性增长;
- 采样对 2% 以上热点足够可信,更细的偶发问题交给追踪;
- 采样有幸存者偏差:睡眠/等锁的代码几乎不可见,需 off-CPU 补充;
- 追踪必须内核态过滤,把谓词放到事件发生地执行;
- 标准动作是两段式:先采样收窄嫌疑,再定向追踪取因果。
知道了怎么采,下一节看采到的证据本体:调用栈与硬件计数器。
延伸:采样率与漏检概率的估算
采样取证天然会漏掉短小热点,漏检概率可以估算。设某函数单次执行耗时 t,采样周期为 T,则单次执行被至少命中一次的概率约为 t/T。若一个 50µs 的函数在 10ms 采样周期下运行 100 次,全程被采到的期望次数是 100×(0.05/10)=0.5 次——一整轮压测有近四成概率完全看不见它。这解释了" 采样画像里没有不等于没发生":
import math # 每轮调用 N 次、单次耗时 t、采样周期 T,全程零命中的概率 def miss_prob(N, t_us, T_us): p_hit = min(t_us / T_us, 1.0) return (1 - p_hit) ** N print(f"{miss_prob(100, 50, 10000):.2f}") # 0.61 —— 61% 概率完全漏检 print(f"{miss_prob(100, 50, 1000):.4f}") # 0.006 —— 周期降到 1ms 后基本可见
结论分两档:找毫米级的大热点,采样足够;追微秒级的短路径(锁、分配器、序列化),必须换事件级追踪或降低采样周期并接受相应开销。
延伸:采样偏差的方向性
固定定时器采样有一个系统性偏差:它偏爱"正在 CPU 上跑"的代码,看不到睡眠与阻塞。on-CPU 采样画像里占比很高的函数,只说明它烧 CPU,不说明它在拖延迟。把同一负载的 on-CPU 与 off-CPU 画像并排看,若 on-CPU 平淡而延迟高企,嫌疑立即转向锁等待、IO 或下游依赖——这一步判断决定了后续是上 perf 还是上 ftrace/bpftrace,选错工具会浪费整个取证窗口。
延伸:混合采集的实际编排
真实系统几乎总是混合使用两种手法,编排原则按"发现—定位—验证"三阶段切换:常态下只有低频采样在跑(例如 99Hz 的剖析加分钟级指标),负责发现问题形态;问题出现后,对嫌疑实例临时叠加事件级追踪(锁事件、IO 事件或特定函数探针),负责把问题钉到具体路径;修复验证阶段回到采样并叠加 A/B 对照。三阶段各有时限——追踪探针默认带 TTL 自动摘除,避免"临时探针"变成常驻税。编排的关键动作是预先写好探针的启停脚本与 TTL 参数,事故时一条命令完成叠加,一条命令全部回收。成熟团队的差距不在会写哪种探针,而在两类手法之间的切换是否足够快、回收是否足够干净。
选型上还有一个易被忽略的维度:证据的消费者是谁。采样画像给工程师看,形态直观、无需了解采集细节;事件流给自动化系统消费,适合做规则与统计检验。把"给人看的"与"给机器看的"分开设计采集方案,能避免在日志格式上反复妥协——日志格式的每次含糊,最后都会变成消费端解析代码里的补丁。