2.2 调用栈与硬件计数器:证据的来源
2.2 调用栈与硬件计数器:证据的来源
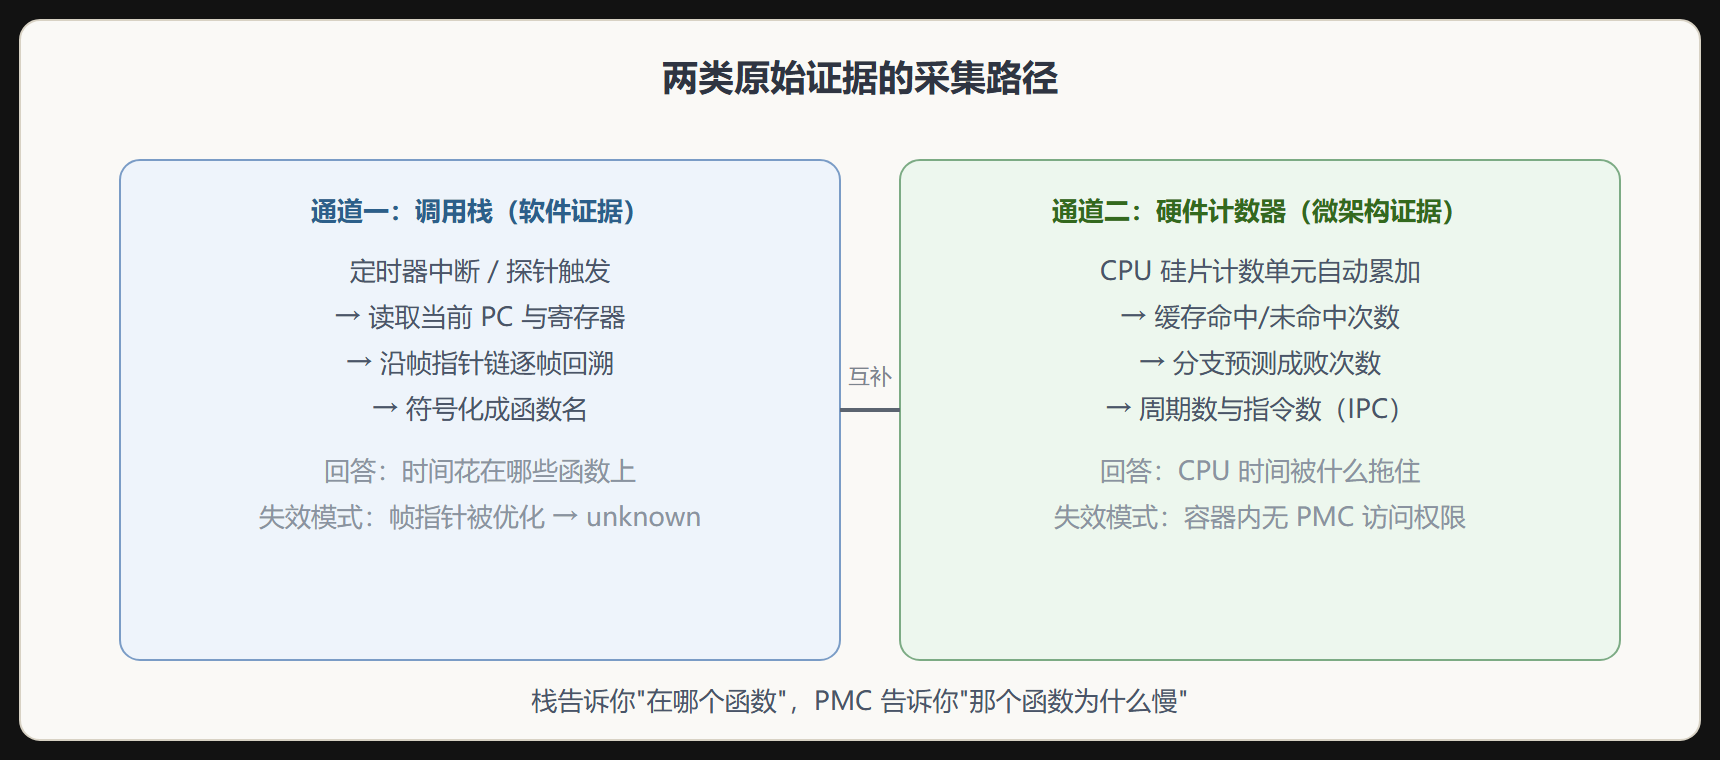
调用栈记录函数之间的调用链,是"热点归因"的基本证据;硬件性能计数器(PMC)是 CPU 内部的统计单元,能提供缓存未命中、分支预测失败等微架构级铁证。采样和追踪产出的原始素材,基本都是这两样。
调用栈是怎么拿到的
程序运行时,每个线程的栈里码放着一层层栈帧(stack frame):返回地址、参数、局部变量。要知道"此刻是谁调用了谁",从栈顶往下逐帧读取返回地址即可,这个过程叫栈回溯(stack unwinding)。
回溯有两种主流方式:
帧指针回溯(frame pointer) 编译时保留 rbp 寄存器指向上一个帧的基地址 回溯 = 沿 rbp 链逐帧跳,快而稳 代价:每次函数调用多两条指令,约 1-2% 性能损失 DWARF 调试信息回溯(.eh_frame) 编译器把栈布局描述写进调试段 回溯 = 查表推算,无需寄存器 代价:回溯慢数倍,表可能不全
这就解释了一个高频怪象:火焰图里一大块叫 [unknown] 的柱子。原因几乎总是帧指针在编译时被优化掉了(-O2 默认 -fomit-frame-pointer),栈链在中途断裂,后面的调用方全部失联。修复方法是构建时加 -fno-omit-frame-pointer,牺牲 1% 上下的性能换回完整的证据链——对要被分析的生产服务,这笔账通常划算。
⚠️ 常见坑:解释型语言还有 JIT 栈的问题——虚拟机生成的代码帧不在原生栈表里,需要工具理解运行时(如 perf 的 jitdump 支持)。Java/Python 程序直接用原生 perf 会看到大片 unknown,先找语言专属方案。
内联是另一个"证据变形"因素:编译器把小函数内联进调用者后,栈里根本没有那个函数的帧。火焰图上你看到的是外层函数"变胖",被内联的小函数隐身了。定位时要意识到:图上没有某个函数,不等于它没执行。
硬件计数器:CPU 自带的行车记录仪
PMC 是 CPU 硅片上的寄存器组,每个核几十个,硬件层面自动累加事件,读取开销接近零。它能提供软件永远拿不到的证据:
| 事件类 | 典型计数器 | 指向的问题 |
|---|---|---|
| 缓存 | L1-dcache-load-misses | 数据布局差、伪共享 |
| 缓存 | LLC-load-misses | 工作集超出末级缓存 |
| 分支 | branch-misses | 分支不可预测(如数据依赖的 if) |
| 内存 | dTLB-load-misses | 大页缺失、地址随机化代价 |
| 指令 | instructions / cycles | IPC 高低的微观解释 |
最有用的组合拳是 IPC(每周期指令数):
perf stat -p <pid> -- sleep 5 Performance counter stats: 42,183,552,310 instructions 18,290,551,206 cycles ... 2.31 insn per cycle
解读口径:IPC 明显低于 1,CPU 大部分周期在"等"——等内存(缓存未命中)或等分支结果;IPC 接近或超过 2(现代多发射 CPU),说明计算受限,优化方向是算法和向量化,而不是数据布局。这一步能避免大量南辕北辙的优化。
一个真实案例的推理链:某图像处理服务 CPU 高,perf stat 显示 IPC 只有 0.4,perf record 热点是一个像素遍历循环;再看 perf record -e L1-dcache-load-misses,未命中集中在二维数组的列遍历上。把内层循环从按列改成按行(顺应缓存行),IPC 回到 1.8,CPU 降了一半。没有 PMC,"遍历顺序"这种问题在火焰图上根本不显形——它不是热点函数变了,而是同一个函数微架构效率变了。
证据采集的双通道
容器与云环境的 PMC 限制
PMC 是全核共享的物理资源,虚拟化和容器环境经常不透传。云上实例里 perf stat 报 not counted 或权限错误是常态。退路有两条:换用基于软件事件的指标(task-clock、上下文切换),或使用云厂商的裸金属实例。这也是第 6 章容器观测盲区的一个具体表现。
本节要点回顾
- 栈回溯靠帧指针链,编译时加
-fno-omit-frame-pointer是消灭[unknown]的根本手段; - 内联会让小函数在火焰图上隐身,"图上没有"不等于"没执行";
- IPC 是微观体检指标:低于 1 等 内存/分支,高于 2 才是计算受限;
- PMC 提供软件拿不到的铁证(缓存未命中、分支失败),定位数据布局类问题必用;
- 云环境 PMC 常不可用,要预置软件事件 fallback。
延伸:栈回溯的三种实现与开销对比
拿到调用栈的方式有三种,代价差异巨大:帧指针回溯(-fno-omit-frame-pointer)只需顺链走 FP 寄存器,纳秒级但要求全链路编译保留帧指针;DWARF 展开解析 .eh_frame,无需重编译但每层栈要查表,微秒级;last branch record(LBR)由 CPU 硬件记录分支轨迹,几乎零侵扰但栈深有限。生产环境常驻剖析首选帧指针或 LBR,临时诊断才用 DWARF:
# 确认二进制是否保留帧指针(有输出即可用 FP 回溯) readelf -s ./app | grep -c __frame_pointer_init || echo "no FP" # perf 指定回溯方式对比开销 perf record -F 99 -g --call-graph fp -o fp.data -- ./app perf record -F 99 -g --call-graph dwarf,16384 -o dw.data -- ./app perf report -i fp.data --stdio | head -20
一个常见故障:升级后火焰图全是问号断栈,九成是新版依赖库用 --omit-frame-pointer 编译。把"保留帧指针"写进基础镜像的编译规范,是让调用栈证据长期可信的工程前提。
延伸:用 PMU 定位缓存伪共享
硬件计数器能把"慢"翻译成"哪类微架构事件"。缓存伪共享的典型签名是本地内存访问比例下降、HW_CACHE_MISSES 抬升而指令数不变。用 perf 事件可以现场验证:
perf stat -e cycles,instructions,L1-dcache-load-misses \ -e mem_load_retired.l3_miss -- ./app # IPC 正常但 L1 miss 每千指令 > 20 且 L3 miss 高 -> 数据布局问题而非计算量问题
配合 c2c 子命令(perf c2c record -- ./app; perf c2c report)能直接给出伪共享的缓存行地址与冲突线程对,是并行程序取证里证据等级最高的一手材料。