2.3 eBPF:内核里的法证实验室
2.3 eBPF:内核里的法证实验室
eBPF(extended Berkeley Packet Filter)是 Linux 内核内的可编程沙盒虚拟机:经过验证的小程序可以被动态挂载到内核事件点上,在事件发生地完成过滤、聚合与统计。它把过去"改内核代码才能做的观测"变成运行时动态注入,且验证器保证程序不会崩溃内核——这是生产级低扰动取证的技术底座。
从一个痛点讲起
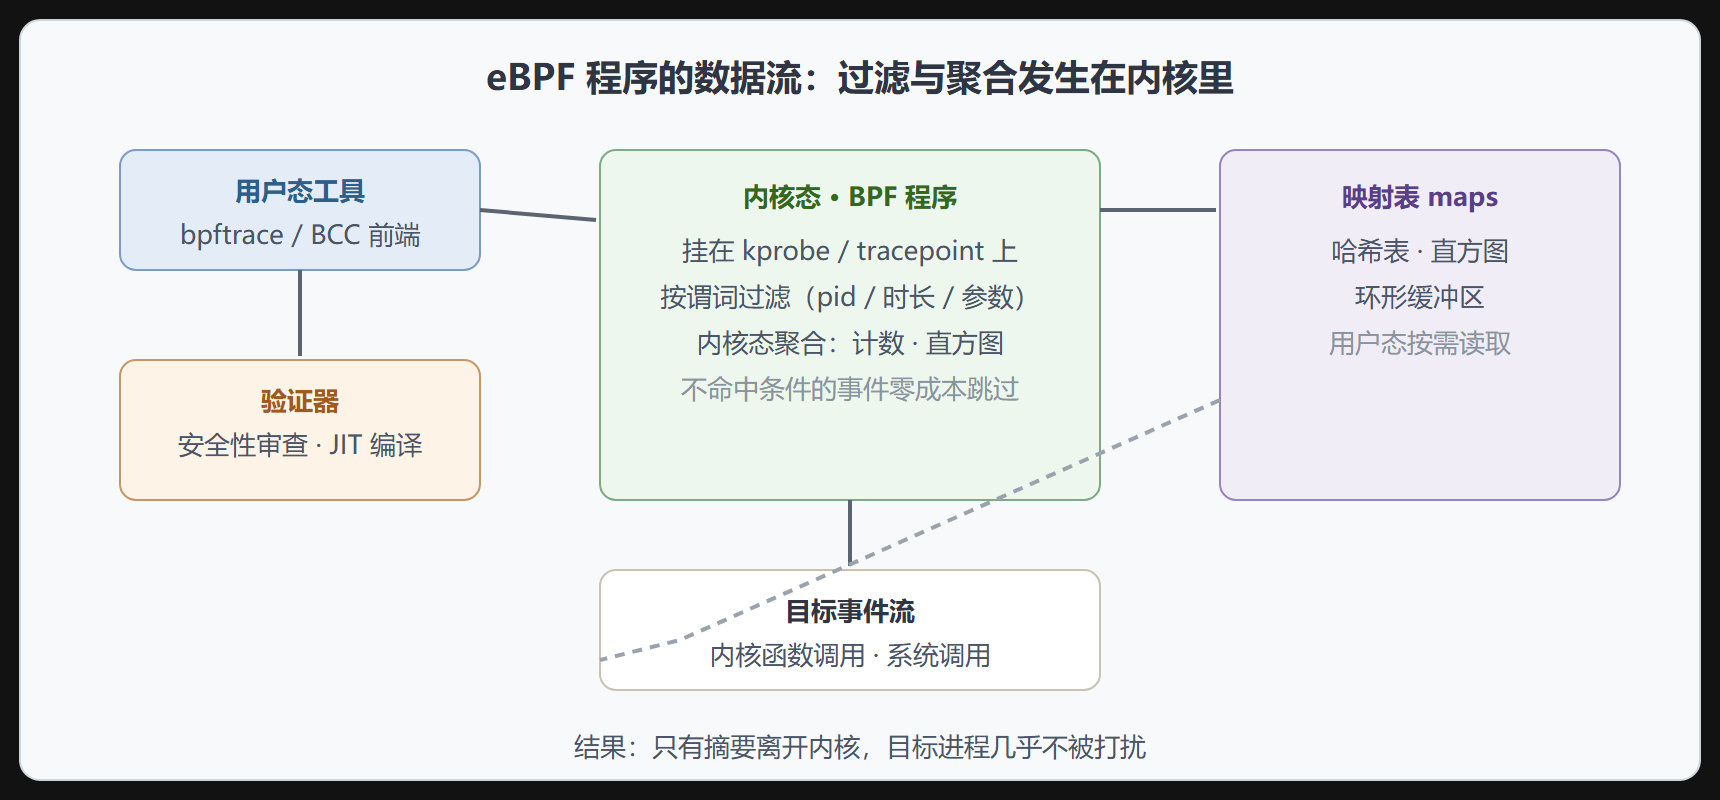
想知道"进程 X 的 read 系统调用都读了哪些文件、各花了多久",传统做法只有两条路:写内核模块(风险等同给心脏做手术,一个空指针全网宕机),或者用 strace(第 1 章说过,扰动大到一个数量级)。eBPF 给了第三条路:把一段小程序安全地"贴"到内核函数 vfs_read 的入口和返回处,事件在内核里就被过滤聚合,用户态只收到摘要。
关键在于"在内核里做过滤"这一步。对比两种数据路径:
strace 路径: 事件发生 → 暂停目标进程 → ptrace 通知 → 上下文切换到 strace → 用户态记录 → 切换回来 → 目标进程继续 (每个事件两次上下文切换) eBPF 路径: 事件发生 → 触发 BPF 程序 → 内核态判断过滤条件 → 命中则更新映射表/环形缓冲 → 目标进程几乎无感继续 (无上下文切换,未命中条件的事件零回传)
eBPF 程序的一生
一段 eBPF 取证程序从写出到运行,要过四道关卡:
- 编写:C 或 bpftrace 高级语言写成,编译成 BPF 字节码;
- 验证:内核验证器逐指令检查——禁止越界访问、禁止无限循环、必须在所有路径上安全退出。验证不过,程序根本进不了内核;
- JIT 编译:字节码翻译成本机指令,运行速度接近原生代码;
- 挂载:附着到某个事件点,事件触发时执行。
可挂载的事件点覆盖了内核与用户程序的关键路径:
| 挂载点类型 | 挂在哪 | 典型取证用途 |
|---|---|---|
| kprobe / kretprobe | 内核函数入口/返回 | 任意内核函数的参数与耗时 |
| tracepoint | 内核预定义静态点 | 调度、IO、网络事件(更稳定) |
| uprobe / uretprobe | 用户态函数入口/返回 | 应用函数耗时、参数 |
| perf 事件 | PMC、定时器 | 采样剖析 |
数据回传靠映射表(maps):哈希表存聚合结果、直方图存分布、环形缓冲区流式传事件。工具读这些映射表就能拿到结果,全程不用再进内核抓数据。
eBPF 取证数据流
上手体感:十行以内的小实验
bpftrace 把 eBPF 封装成一行命令。统计系统中 read 系统调用的耗时分布:
bpftrace -e 'kprobe:vfs_read { @start[tid] = nsecs; } kretprobe:vfs_read /@start[tid]/ { @us = hist((nsecs - @start[tid]) / 1000); delete(@start[tid]); }'
输出是一张内核态直方图(微秒级桶):
@us: [256, 512) 612 |@@@@@@@@@@@@@ | [512, 1K) 1408 |@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@ | [1K, 2K) 530 |@@@@@@@@@@@ | [2K, 4K) 42 |@ |
一目了然:绝大多数读取在 512 微秒到 1 毫秒之间。这份数据是内核里聚合好的,回传的只是一排桶计数——这就是"法证实验室"的含义:分析在案发现场完成,运走的只有结论。
能力边界与代价
eBPF 不是万能的,它的约束也来自验证器本身:
- 循环受限:为可验证性,早期内核版本不允许任意循环(新版本有界循环可用),复杂逻辑要展开或拆分;
- 栈只有 512 字节:大缓冲必须放映射表;
- 内核版本差异:不同版本支持的挂载点和辅助函数不同,跨环境部署要小心兼容性;
- 不能随便 sleep 或阻塞:BPF 程序运行在原子上下文里。
💡 关键直觉:eBPF 的价值不在于"能看到更多"(内核模块也能),而在于用安全换可用——验证器保证了探针不会压垮生产系统,观测才能从"救火时才敢上"变成"常驻线上"。
本节要点回顾
- eBPF = 内核内沙盒虚拟机 + 事件挂载点 + 映射表回传,三件套构成低扰动取证平台;
- 验证器是安全核心:越界、死循环、不安全路径在进入内核前就被拒绝;
- 过滤与聚合发生在内核态,这是与 strace 类工具的本质效率差异;
- 挂载点四大家族:kprobe、tracepoint、uprobe、perf 事件,覆盖内核与应用;
- 约束真实存在:512 字节栈、循环限制、内核版本兼容,写复杂工具前先掂量。
延伸:用 bpftrace 写第一个取证脚本
bpftrace 是 eBPF 的"一行命令"形态,适合把怀疑点快速变成探针。以下脚本统计每个进程的块层延迟分布,10 行内回答"慢在内核还是慢在设备":
#!/usr/bin/env bpftrace // blk-lat.bt —— 按进程统计块设备 IO 延迟分布 tracepoint:block:block_rq_issue { @ts[args->dev, args->sector] = nsecs; } tracepoint:block:block_rq_complete /@ts[args->dev, args->sector]/ { $us = (nsecs - @ts[args->dev, args->sector]) / 1000; @usecs[args->comm] = hist($us); // 直方图按进程聚合 delete(@ts[args->dev, args->sector]); } END { clear(@ts); }
输出里若 kworker 与业务进程的延迟直方图形态一致,慢在设备;若仅个别进程延迟尾部极长,慢在它自己的提交路径(如 fsync 风暴)。这种"一次探针同时验证两个假设"的效率,是传统日志打点无法比拟的。
延伸:验证器报错的排查思路
bpftrace/BCC 脚本被验证器拒绝时,报错集中在三类:未初始化读取(先给变量赋值再使用,探针入口立即置零);越界访问(对 args 结构体取字段前加类型断言或用现成 tracepoint 而非 kprobe 裸指针);超时路径(循环上界写死为常量,且不依赖输入大小)。理解验证器不是刁难而是保证"探针绝不拖垮内核",排错方向就从"绕过检查"转向"把访问路径写得更可证明"——这也是生产环境敢常驻 eBPF 探针的根本原因。