3.1 perf:瑞士军刀级的采样取证
3.1 perf:瑞士军刀级的采样取证
perf 是 Linux 内核自带的性能剖析工具(隶属 tools/perf),以极小的系统侵入完成统计剖析:perf stat 读计数器做宏观体检,perf record 定时采样收集调用栈,perf report 交互式查看热点。它是 Linux 上单机性能取证的默认起点。
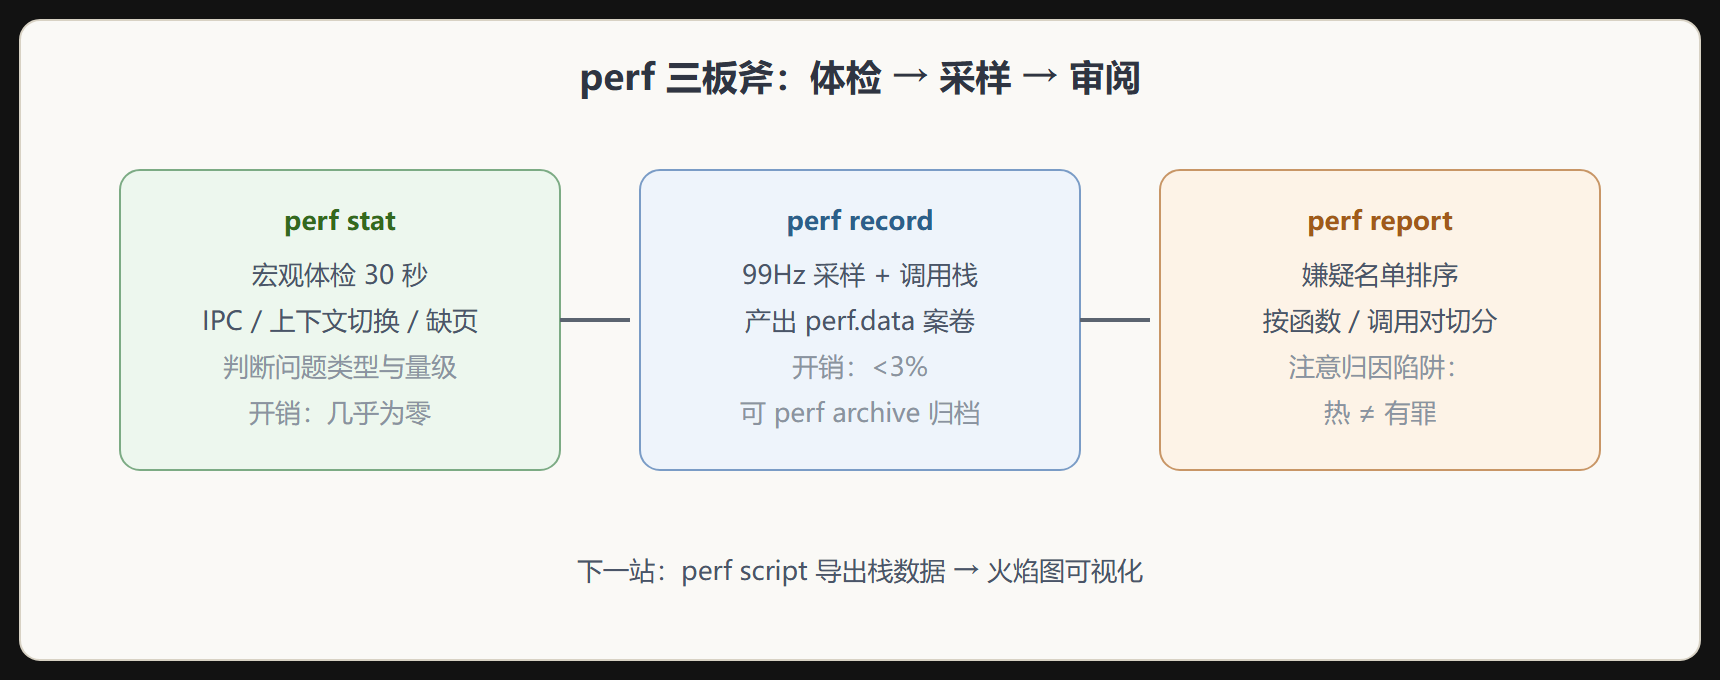
板斧一:perf stat,三十秒宏观体检
对可疑进程先做一次全身检查:
perf stat -p <pid> -- sleep 10
典型输出(节选):
Performance counter stats for process 'orders-api': 8,431.22 msec task-clock # 0.84 CPUs utilized 1,204 context-switches # 0.143 K/sec 58 cpu-migrations # 0.007 K/sec 12,331 page-faults # 0.001 M/sec 18,940,221,033 cycles # 2.246 GHz 26,113,540,812 instructions # 1.38 insn per cycle 921,884,003 branches # 109.221 M/sec 6,204,015 branch-misses # 0.67% of all branches 10.004377827 seconds time elapsed
逐行判读,像看化验单:
- task-clock 0.84 CPUs utilized:单线程为主,没用满一个核,CPU 饱和的可能性低;
- insn per cycle 1.38:IPC 中等偏上,微架构没有明显拖累;
- context-switches 每秒 143 次:不高,锁竞争不严重;
- page-faults 1.2 万次:如果每秒上万次缺页,值得查内存访问模式或透明大页。
-d 参数可以加上缓存与 dTLB 的细分,第 2 章讲的微架构证据就是从这里来。
板斧二:perf record,采样收集证据
# 对整个系统采样 30 秒,频率 99Hz,记录调用栈 perf record -F 99 -ag -- sleep 30 # 只盯一个进程,指定事件为 CPU 周期 perf record -F 99 -g -p <pid> -e cycles -- sleep 15
两个参数值得较真:
-F 99而不是 100:避免采样节拍与程序自身周期性行为(如 100Hz 的定时任务)同步,产生规律性偏差。99 是刻意选的互质频率;-g记录调用栈:没有-g只有热点函数没有调用关系,归因能力大打折扣。前提是目标带帧指针(第 2 章的老话题)。
采样完得到数据文件(默认 perf.data),可以先档案级归档:perf archive 会把符号信息打包,案卷转移到别的机器也能解析。
板斧三:perf report,审阅证据
perf report --sort symbol # 按函数看占比 perf report --sort comm,symbol # 区分进程 perf report --sort symbol,dso # 区分是应用还是库的代码
文本模式输出:
# Overhead Command Symbol # ........ ........... ........................ 31.24% orders-api [.] json_serialize 18.70% orders-api [.] malloc 9.12% orders-api [.] std::string::append ...
这份排名就是"嫌疑名单"。但注意归因陷阱:malloc 占 18% 不等于 malloc 写得差,可能只是上层调用太频繁——真正的罪犯是让它被调了那么多次的那条路径。要切开这层归因,把 --sort symbol 换成 --sort symbol_from,symbol_to(调用方-被调方对),或者直接上下一节的火焰图。
perf 三板斧的取证链路
常用变体事件
perf 不只能测 CPU 周期,换事件就是换侦办方向:
# 谁在制造缺页 perf record -e page-faults -ag -- sleep 10 # 调度延迟:谁在排队等 CPU perf record -e sched:sched_switch -ag -- sleep 10 # 缓存未命中的空间分布(需要 PMC 权限) perf record -e LLC-load-misses -g -p <pid> -- sleep 10 # 时钟事件:PMC 不可用时的替代采样源 perf record -e cpu-clock -F 99 -g -p <pid> -- sleep 10
perf list 列出本机全部可用事件,是探索的入口。
本节要点回顾
- perf stat 先行:IPC、上下文切换、缺页三组数字先定问题类型,再决定深入方向;
-F 99 -g是标准采样姿势:互质频率防同步偏差,调用栈是归因生命线;- 热点 ≠ 根因:
--sort换维度(调用对、dso)切开归因链,别急着改最宽的柱子; - 换事件换侦办方向:page-faults 查内存、sched 查调度、LLC-misses 查缓存;
- perf archive 归档案卷:跨机器分析的前提。
排名表缺乏结构感,下一节把它画成火焰图。
延伸:perf stat 的方差诊断
单次 perf stat 的计数波动可能掩盖真实信号,加 -r 重复运行并输出方差,能把"缓存命中提升了"从感觉变成统计:
perf stat -r 5 -e task-clock,cycles,instructions,\ branch-misses,cache-misses,L1-dcache-loads \ ./bench --workload=checkout # 关注 ±stddev 一列: branch-misses 方差超过均值 20% 时, # 单次对比实验不可信, 需固定 CPU 频率与绑核后重测 sudo cpupower frequency-set -g performance # 锁频降方差 taskset -c 2 perf stat -r 5 ./bench # 绑核隔离干扰
锁频加绑核后,典型服务的 IPC 测量方差可以从两位数百分比压到 3% 以内——达不到这个精度,任何"优化前后对比"都无法作为定罪证据。
延伸:从 perf record 到可读结论的最短路径
采完数据后最常犯的错是直接看聚合百分比。更稳的路径是先看颗粒度、再切换视图:
perf record -F 199 -g --call-graph dwarf -o perf.data -- ./app perf report -i perf.data --header # 先确认采样数与运行时长匹配 perf report -i perf.data --sort symbol # 按函数聚合, 找头三个占比 perf report -i perf.data -g fractal,5 # 展开调用路径, 看谁在调它
采样数与预期不符(如负载 60 秒但样本只有几百个)说明探针被频率限制或进程大部分时间在睡眠,此时应换 off-CPU 视角而不是加大 -F。采样数合理时,结论写法也讲究:说"inflate() 占 38% 采样,主要来自响应序列化路径"是证据;说"inflate() 太慢"是印象。