3.2 火焰图:把证据画成罪案地图
3.2 火焰图:把证据画成罪案地图
火焰图(Flame Graph)是 Brendan Gregg 发明的调用栈可视化:每个矩形是一个函数,宽度正比于它在采样中出现的次数(即 CPU 时间占比),栈越深位置越高。它不产生新证据,而是把成千上万个采样栈折叠成一张人眼可读的"罪案地图"。
从原始栈到火焰图
perf 采样到的原始数据是一行行完整调用栈:
mysqld;handle_connection;do_query;execute_select;innodb_scan;row_search;memcpy mysqld;handle_connection;do_query;execute_select;innodb_scan;row_search;btr_cur mysqld;handle_connection;do_query;parse_sql;...
每行出现一次算一票。火焰图的做法是:同一行出现 N 次 → 最顶层函数的矩形宽 N;栈前缀相同的 → 共享底座往上摞。所以:
- 宽度 = CPU 时间占比( votes);
- 高度 = 调用深度,与快慢无关;
- 顶层不一定是"最热函数"——要按宽度看,不是按高度看。
生成命令(flamegraph 工具链):
perf record -F 99 -ag -- sleep 30 perf script | stackcollapse-perf.pl | flamegraph.pl > flame.svg
三步分别是:导出原始栈、折叠成"栈;栈;栈 次数"格式、渲染 SVG。现代内核的 perf 甚至内置了 perf report --stdio 之外的 lab 火焰图模式,但经典管道组合通用性最好。
读图:三个真实案例
案例一:平顶宽山 = 单一热点
│ ┌────────────────┐ │ ┌───────┐ │ json_encode │ 41% │ ┌────┐ │ parse │ └────────────────┘ │ main │ │ sql │ ... └──────┘ └───────┘
一座顶部平坦、宽度突出的大山,就是教科书式的单一热点:直接优化这个函数(或减少它的调用次数)。最没有争议的案情。
案例二:右侧一座细高塔 = 深调用链问题
宽度 3% 但高达 40 层栈的细塔,通常是递归或超深封装。它单次成本低,但路径长意味着每次业务请求都要爬一遍这座塔——优化方向是砍层数(缓存中间结果、合并封装),不是优化某个具体函数。
案例三:满屏碎石 = 无明显热点
没有山,全是均匀的小柱子。这是"采样找不到惯犯"的形态,通常意味着:
- 问题不在 on-CPU(在等锁/等 IO)→ 转 off-CPU 分析;
- 热点被分散(大量小函数、或解释型语言调度)→ 提高采样时长;
- 采样期间没有复现负载 → 确认压测真的打到位了。
⚠️ 常见坑:把两份不同负载的火焰图直接对比。正确的差分做法是生成对比火焰图(红蓝图):红色代表新增开销、蓝色代表减少部分,同色系宽度差一眼锁定回归点。工具链同样支持,把两份折叠文件按顺序喂给
flamegraph.pl加差分参数即可。
变体:不同罪案用不同图
| 变体 | 证据来源 | 定位的罪案 |
|---|---|---|
| on-CPU 火焰图 | CPU 上的采样 | 计算热点 |
| off-CPU 火焰图 | 离开 CPU 时的栈 | 等 IO、等锁、睡眠 |
| 内存火焰图 | 按分配字节数折叠 | 分配热点、泄漏源 |
| 热力火焰图 | 颜色编码时间变化 | 热点是否随时间漂移 |
| 差分火焰图 | 两份图对比 | 优化前后、版本回归 |
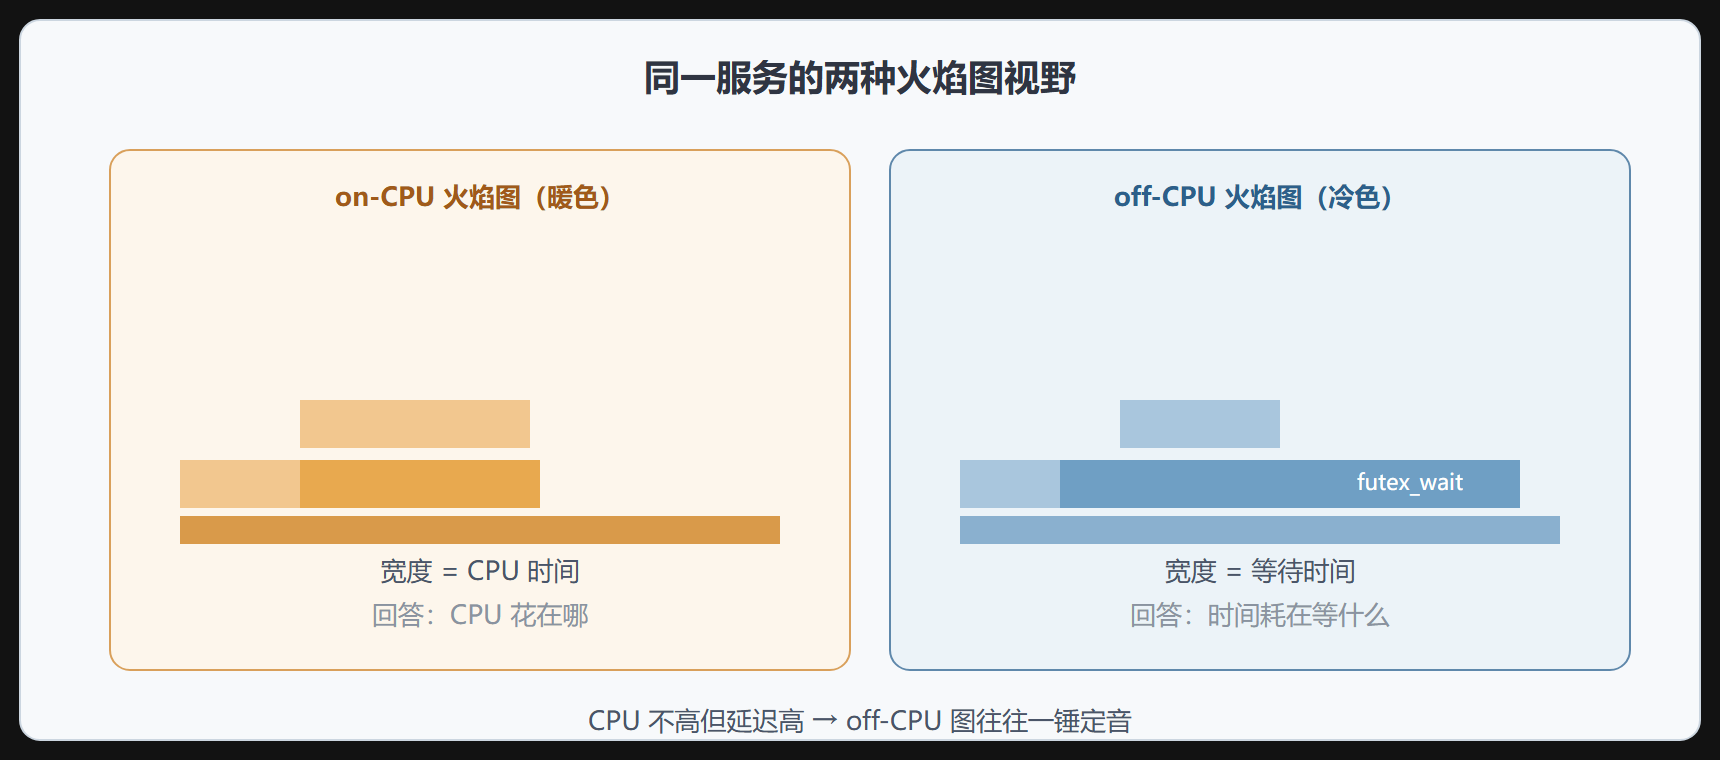
off-CPU 值得多说一句:它采样的是"线程被切换出 CPU 或进入睡眠那一刻的栈",宽度含义从"占了多少 CPU"变成"睡了多久"。一个服务 CPU 不高但延迟高,on-CPU 图平淡无奇,off-CPU 图里 futex_wait 一柱擎天——锁等待立刻现形。
on-CPU 与 off-CPU 的互补视野
交互与语义细节
生成的 SVG 是可交互的:点击任意矩形会放大该子树;Ctrl+F 搜索函数名,命中部分反色高亮——在一座上千个函数的大图里找特定嫌疑人,全靠搜索。
读图最后一条纪律:宽度是占比不是绝对值。优化掉一个 30% 的热点后,其他柱子会按比例"变宽",因为分母变小了。评估优化效果要看绝对时间或吞吐,别被重新洗牌的相对宽度迷惑。
本节要点回顾
- 宽度 = 时间占比,高度 = 调用深度,高度不代表快慢;
- 平顶宽山是单一热点,细高塔是深链路问题,满屏碎石说明问题不在 on-CPU;
- CPU 低延迟高时换 off-CPU 火焰图,
futex_wait之类的等待一柱擎天即定罪; - 版本对比用差分火焰图,红增蓝减,回归点一眼可见;
- 宽度是相对值,优化效果的终审看绝对指标。
采样图谱之外,下一节回到追踪阵营:ftrace 与 bpftrace。
延伸:微分火焰图定位回归
两张火焰图的差异人眼很难比对,微分火焰图把优化前后的两份采样合成一张:宽度差直接显示哪些栈变宽、哪些变窄。这是回答"这次改动到底影响了什么"的最快手段:
perf record -F 199 -g -o before.data -- ./app --seed-case # ...应用优化后... perf record -F 199 -g -o after.data -- ./app --seed-case git stash && perf script -i before.data > before.fold git stash pop && perf script -i after.data > after.fold # 红色=变宽(劣化), 蓝色=变窄(改善), 基准取 after ./flamegraph.pl --diff baseline before.fold after.fold > diff.svg
使用微分图有一条纪律:两次采样必须在同负载、同配置下进行,否则宽度差里混入的是流量差异而不是代码差异。
延伸:读图的三个高频误判
第一,火焰图横向宽度是采样占比,不代表绝对耗时——总量翻倍时"占比不变"的函数其实慢了一倍,读图前先记下采样总时长。第二,栈顶平顶不一定是热点,可能是采样探针在系统调用返回处的偏置,配合 perf stat 的 syscall 计数交叉验证。第三,忽略"塔基"很矮但很宽的形态:大量不同路径各占少量采样,常见于异常处理风暴或 hash 扰动导致的路径分散,这种情况要到调用方分布里找共性,而不是死盯某个栈顶。