4.1 CPU 嫌疑犯:on-CPU 与 off-CPU 取证
4.1 CPU 嫌疑犯:on-CPU 与 off-CPU 取证
CPU 瓶颈分两种形态:on-CPU(线程在核上做计算,CPU 真被算满了)和 off-CPU(CPU 不忙但线程不在运行,时间耗在等待上)。两者的取证手段完全不同,用错工具会得出"CPU 很闲所以没问题"的错误结案。
第一步:确认 CPU 是否真的饱和
vmstat 1 5 mpstat -P ALL 1 5
看三个地方:
vmstat的r列:等待 CPU 的可运行线程数,持续大于核数即饱和;mpstat的%iowait:等待 IO 的 CPU 时间占比;mpstat各核分布:单核 100% 而其他核空闲,是串行化问题,不是容量问题——加机器无效。
饱和形态的快速判别
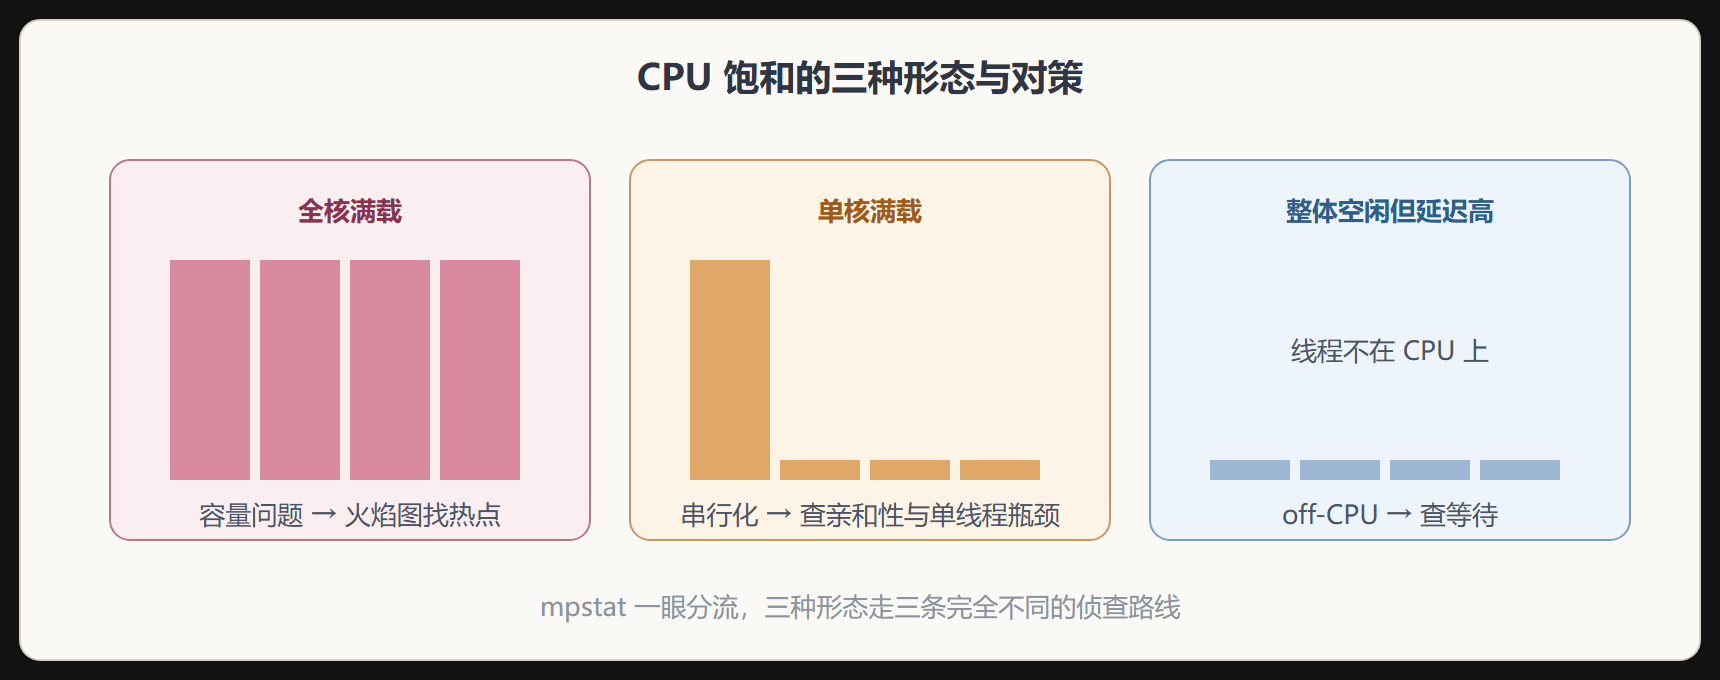
on-CPU 取证:满载时找热点
全核满载时用第 3 章的标准采样:
perf record -F 99 -ag -- sleep 30 perf script | stackcollapse-perf.pl | flamegraph.pl > cpu.svg
满载场景的常见罪状有几类,火焰图形态各有特征:
- 业务计算真热:山顶是序列化/压缩/加密/正则这类函数——正当开销,优化路径是算法、缓存或换实现;
memcpy系宽山:数据搬运占比高,怀疑数据结构布局、重复拷贝、或该用零拷贝的地方没用;- 锁自旋宽山:
_raw_spin_lock一类内旋函数占比高——CPU 满载是假象,实际在空转等锁,真正的罪犯是临界区(第 5 章展开); - GC 宽山:托管语言运行时函数占大头——分配速率过高,查对象生命周期。
off-CPU 取证:CPU 闲但延迟高
这是更容易误判的形态。线程的时间去哪了?不在 CPU 上,就在某个等待队列里:
# 线程自愿让出 CPU 的次数(等锁/等IO 的信号) pidstat -w -p <pid> 1 # 每个线程当前卡在哪(瞬间快照) cat /proc/<pid>/task/*/wchan # 输出如: futex_wait_queue_me → 等互斥锁 # poll_schedule_timeout → 等 IO 或网络
wchan(wait channel)是内核里线程睡眠点的符号名,一次快照就能把"全体线程此刻在等什么"拍下来。若 80% 的线程都停在 futex_wait_queue_me,锁竞争定罪;停在 poll_schedule_timeout,去查下游依赖或磁盘。
off-CPU 火焰图(第 3.2 节)是这类案件的正式证据:宽度变成睡眠时长,futex_wait、io_schedule 的塔有多高,等待就有多重。
一个完整推理链
报表导出接口 P99 达 8 秒,CPU 使用率仅 30%。推理:
- CPU 不饱和但延迟高 → off-CPU 方向;
pidstat -w显示 voluntary switch 每秒 5000 次,线程频繁睡醒;wchan快照:多数线程在futex_wait_queue_me;- off-CPU 火焰图:等待全部汇聚到一个共享的导出锁——全局互斥锁串行化了所有导出请求;
- 定罪:锁粒度过粗。修复:按租户拆分锁 + 结果缓存,P99 降到 700ms。
这个案例里如果按"CPU 没满所以加机器"处理,一个核都不会被用上,钱花了案子还在。
本节要点回顾
- 先看饱和形态再选工具:全核满载、单核满载、整体空闲是三种不同的案子;
- 单核满载是串行化问题,加机器无效,查单线程路径与核亲和性;
- 锁自旋会造成"假满载",热点在自旋函数时真罪犯是临界区;
- CPU 闲延迟高必查 off-CPU:wchan 快照三秒定位等待点,off-CPU 火焰图出正式证据;
- 等待汇聚点就是瓶颈本体:锁、连接池、下游,哪个结构把并发串成了队列,哪个就是真凶。
延伸:off-CPU 时间的分解账本
线程不在 CPU 上时,时间去了三个地方:等锁、等 IO、等调度。把 off-CPU 时间按阻塞原因分解,才能知道该找谁结账。eBPF 一次采集可同时拿到"睡了多久"和"睡在哪":
#!/usr/bin/env bpftrace // offcpu.bt —— 按内核栈统计 off-CPU 时长 kprobe:finish_task_switch /@start[tid]/ { $us = (nsecs - @start[tid]) / 1000; @[kstack] = hist($us); // 按阻塞点聚合的延迟分布 delete(@start[tid]); } kprobe:try_to_wake_up /pid/ { @start[tid] = nsecs; }
直方图集中在一小撮栈、且这些栈顶落在 futex_wait_queue_me,是锁竞争;落在 io_schedule,是存储等待;栈分散但总量大,多半是 CPU 配额不足(cgroup throttle),去查 cpu.stat 的 nr_throttled 即可定罪。
延伸:USE 三问在 CPU 上的落点
对 CPU 资源依次问利用率、饱和度、错误:利用率看 /proc/stat 与 pidstat;饱和度看运行队列 vmstat 的 r 列与 nr_throttled;错误在 CPU 上少见,等价物是迁移失败与 throttling。三个问题各有专属命令、互不替代——只看使用率会漏掉"使用率 60% 但队列已经排队"的饱和案件,这是 CPU 定罪最常见的冤案来源。
pidstat -t -p $PID 1 5 # 每线程使用率, 找单线程打满的伪并行 cat /sys/fs/cgroup/.../cpu.stat # nr_throttled 增长 => 配额型饱和 vmstat 1 5 # r 持续 > 核数 => 供给型饱和
关于调度延迟还有一个常被忽略的来源:cgroup CPU 配额的补缴机制。配额按周期发放,周期内配额用完后线程被冻结到下个周期,表现为周期性的百毫秒级停顿——cpu.stat 的 nr_throttled 与 throttled_usec 会记录,而常规的 CPU 使用率曲线完全看不出。这对延迟敏感服务尤其致命:使用率仅 40% 的容器照样可能被 throttle。核对方法是拿 throttled_usec 的增量除以时间窗,得到被冻结的时间占比,超过 1% 就应该提高配额或改用 cpu.max 的 burst 参数。这类案件的教训是:CPU 嫌疑的完整画像必须包含"供给是否稳定"这一问,而不仅看消耗了多少。