4.2 内存嫌疑犯:泄漏、分配与 OOM
4.2 内存嫌疑犯:泄漏、分配与 OOM
内存案件有三类典型形态:泄漏(只借不还,慢性死亡)、分配压力(速率过高,GC/缺页拖慢一切)、OOM(内核处决进程)。本节给出从粗到细的证据链条和每类案件的定罪标准。
先把指标看对
内存指标的名堂比 CPU 多,先立一张对照表:
RSS 进程实际占用的物理内存(含共享页) VSZ 虚拟地址空间大小(不代表消耗) PSS 按共享比例摊派后的"真实份额" minor fault 读已加载页的映射(通常是首次触页) major fault 需要从磁盘换入(严重信号) si / so 换入换出物理内存的速率(系统级警报)
日常监控看 RSS 趋势,多进程共享库的精确核算用 PSS(smaps_rollup),性能问题盯缺页与换页。
grep -E 'Rss|Pss' /proc/<pid>/smaps_rollup vmstat 1 5 # si/so 列
案件一:慢性泄漏
症状:RSS 以每小时几百 MB 的斜率爬升,重启后归零,循环往复。取证分三步:
第一步,确认增长的是堆还是别的。用 pmap -x <pid> 或 smaps 看大段内存的属性——堆段([heap])在涨是分配泄漏;匿名 mmap 段在涨可能是大块分配或内存映射文件;线程栈数量在涨是线程泄漏(每个线程 8MB 栈)。
第二步,抓分配画像。谁在分配、分配了没释放:
# 内存火焰图:按分配量折叠调用栈(需 libheaptrack 或 bpftrace 方案) bpftrace -e 'uprobe:/路径/libc:malloc /@size[tid]/ {} ' # 更实用的是现成工具:堆剖析器或按周期 dump 分配统计
托管语言有自己的武器:Java 用堆转储(heap dump)配合支配树分析,Go 用 pprof 的 heap 剖析看 inuse_space。证据形态一致:保留对象最多的调用路径就是泄漏路径。
第三步,趋势外推定 deadline。RSS 斜率稳定时,剩余存活时间 =(上限 − 当前)/ 斜率。这决定你是今夜修复还是下周修复——工程决策需要数字。
案件二:分配压力(没泄漏但很慢)
内存没泄漏,程序却被内存拖慢,两条常见路径:
- 缺页风暴:每秒数万次 minor fault,说明内存访问模式差(稀疏数据结构、随机访问大数组)或透明大页没启用。
perf stat的 page-faults 一列直接量化; - 分配速率过高:短命对象在热路径上疯狂创建销毁。C/C++ 表现为 malloc 宽山(第 4.1 节的火焰图形态);托管语言表现为 GC 停顿——分配越多,回收越频繁。
定罪手段是分配剖析(而非堆剖析):统计"每秒分配了多少字节、来自哪些栈"。Go 的 allocs 剖析、Java 的分配采样都直接输出这个。修复方向通常是复用缓冲区、对象池化、减少序列化中间对象。
案件三:OOM 处决
内核内存耗尽时,OOM Killer 依据 oom_score 挑选"性价比最高"的进程处决。案发后先验尸:
dmesg -T | grep -A 20 'Out of memory'
输出会写明被杀进程、当时各进程的 RSS 与 oom_score、以及内核为什么走到这一步:
[8412.33] Out of memory: Killed process 3121 (java) total-vm:32GB, anon-rss:28GB Tasks state (stack traces ...) Mem-Info: active_anon:28.1GB ... free:120MB
判读要点:是单进程吃满(应用泄漏或配置的堆上限不合理),还是系统级挤压(容器 limit 与进程预期不符、页缓存挤压匿名页)。容器环境的经典冤案:JVM 按宿主机内存算堆上限,容器 limit 只有 2GB,被 OOM 处决还以为是自己泄漏——第 6 章会专门回到这个坑。
内存案件三形态对照
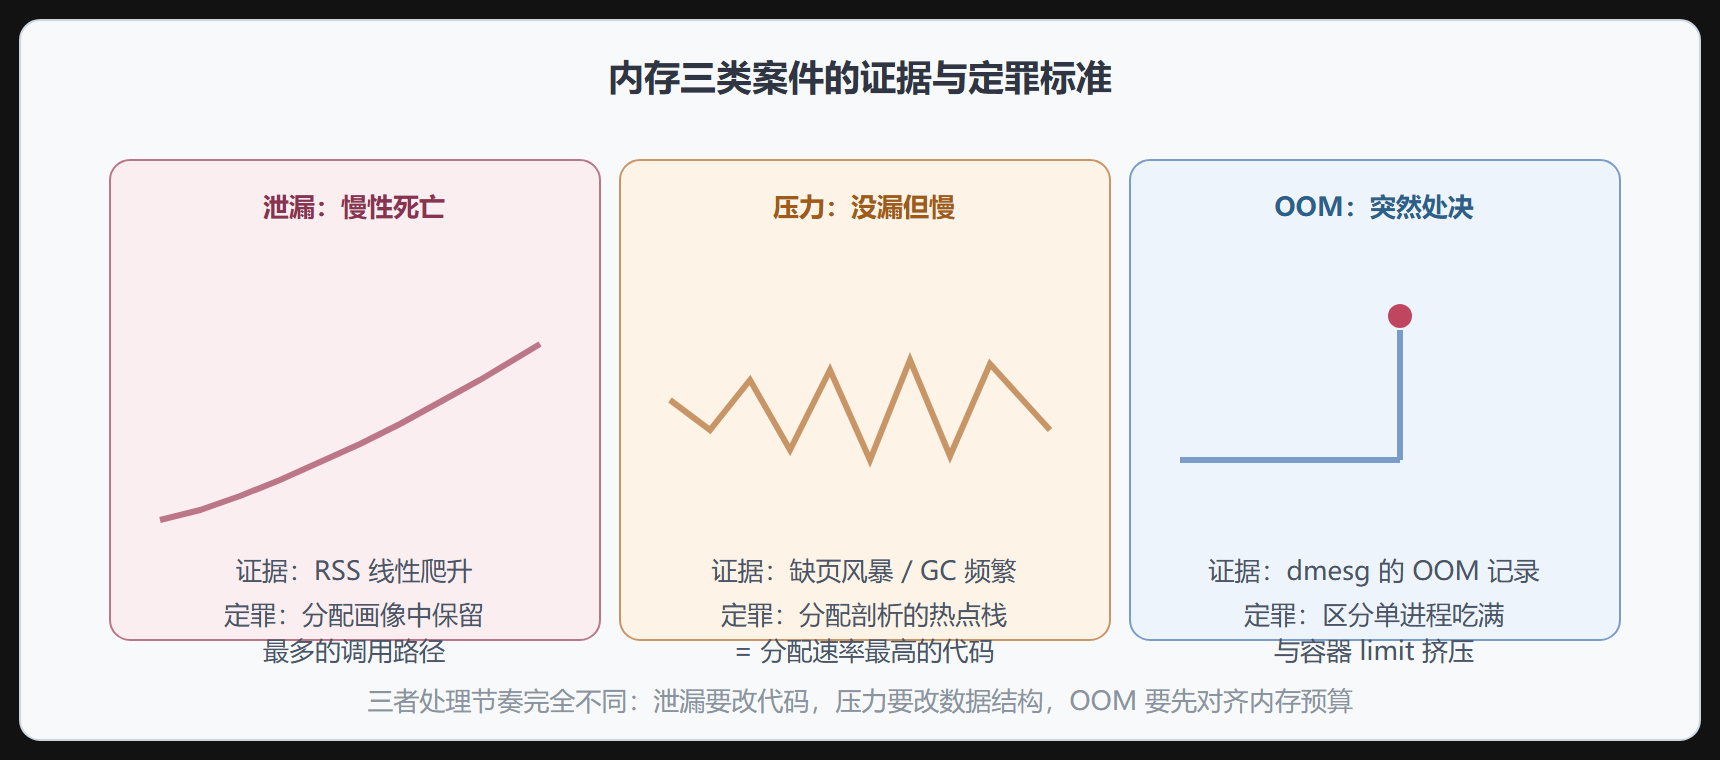
⚠️ 常见坑:看到
free命令 available 很小就断言内存不足。Linux 会把空闲内存拿去做页缓存,判断真实余量要看 available 列与 si/so,而不是 free 列。
本节要点回顾
- RSS 看趋势、PSS 算份额、缺页看速率,三个指标各司其职;
- 泄漏定罪靠分配画像:保留对象最多的调用路径即泄漏路径,斜率外推决定修复时限;
- 分配压力查分配剖析:短命对象在热路径上的创建是托管语言 GC 停顿的头号来源;
- OOM 验尸看 dmesg,并区分应用问题与容器 limit 预算错配;
- free 列不是余量,available 与换页速率才是。
延伸:RSS 与分配器持有量的差值分析
进程内存高不等于泄漏。把 RSS 拆成"分配器持有但未归还"与"应用逻辑持有"两块,差值就是排查方向:glibc 的 malloc arena 默认不还内核,碎片会让 RSS 只涨不降,形态酷似泄漏;真泄漏的特征是活跃对象单调增长且不随流量回落。区分手段是强制整理前后对比:
MALLOC_ARENA_MAX=2 # 压缩 arena, 常驻服务的标配 export MALLOC_TRIM_THRESHOLD_=131072 # 压测 10 分钟后观察: 流量回落后 RSS 是否回落 grep VmRSS /proc/$PID/status # 若 arena 收紧后 RSS 回落 => 碎片; 仍单调涨 => 用分配探针定位调用方 bpftrace -e 'uprobe:malloc:size=@bytes[ustack]=sum(arg0); uretprobe:*:malloc' 2>/dev/null
对长期只涨不落的服务,另一条证据线是按调用栈聚合的分配字节数排行(如 jemalloc 的 prof 或 tcmalloc 的 heap profiler),泄漏栈会以稳定速率累积,直方图随时间单调右移。
延伸:OOM 时刻的证据抢救
容器 OOMKill 发生在被杀之后,dmesg 只留一句遗言,但内核的分配轨迹可以事后还原。常规三层:dmesg -T | grep -i oom 确认受害进程与当时的 RSS/页表开销;/sys/fs/cgroup/.../memory.peak 与 memory.events 的 oom_kill 计数确认是容器配额还是整机内存不足;若目标是"下次别再发生",给服务加分配速率告警(单位时间 RSS 增量)比事后验尸更有价值——泄漏的定罪证据从来是斜率,不是终点值。