4.3 存储 IO 嫌疑犯:从 iowait 到队列深度
4.3 存储 IO 嫌疑犯:从 iowait 到队列深度
存储 IO 案件的标准侦查路径:从 iowait 这个体感指标出发,追到队列深度(饱和度)、单次 IO 大小与速率(吞吐结构),最后落到"随机小 IO / 同步刷盘 / 丢给日志的流量"三种典型罪状之一。
iowait 是最容易被误读的指标
%iowait 的本义是:CPU 有空闲线程,且至少有一个线程在等 IO 的时间占比。它高说明"有空闲也在等",但:
- iowait 低不等于 IO 没问题:CPU 很忙时线程根本轮不到标 iowait,IO 照样堵;
- iowait 高不等于磁盘慢:哪怕 0.1 毫秒的快速 IO,只要 CPU 空闲,也会被计入 iowait。
所以 iowait 只是"该往 IO 方向查"的信号灯,定罪要看下一层:设备级统计。
iostat -x 1
关键列的判读:
Device r/s w/s rkB/s wkB/s rrqm/s aqu-sz await %util sda 3200 120 51200 960 12 8.4 12.1 98.7
aqu-sz(队列深度):平均排队请求数。8.4 意味着每个新 IO 前面排着 8 个——饱和的直接证据;await:单次 IO 平均总耗时(排队 + 服务),毫秒级。HDD 上 12ms 接近物理极限,SSD 上超过 2ms 就值得怀疑;%util:设备忙的时间占比,但注意 SSD 能真正并行,%util 100% 时吞吐可能还有大余量——它只对单队列设备近似成立;r/s对rkB/s的比值:3200 次读共 51MB,平均每次 16KB。小 IO 随机读的指纹。
三种典型罪状与定罪
罪状一:随机小 IO。 指纹是高 IOPS + 小尺寸(4KB/16KB 为主)+ 高 await。定罪后问一个问题:这些 IO 该合并吗?数据库全表扫描导致的按页随机读,换个索引或加大读缓冲就能整批消灭;日志按行刷盘导致的小写,攒批或异步化即可。先消灭 IO,再考虑换更快的盘——顺序反了就是拿钱掩盖设计问题。
罪状二:同步刷盘在关键路径上。 指纹是 w/s 与事务数同量级、每次写 await 接近 fsync 延迟。取证:
# 谁在发 fsync perf trace -e fsync -p <pid> | head # 每次刷盘的耗时分布(内核态直方图) bpftrace -e 'kprobe:vfs_fsync_range { @t[tid] = nsecs; } kretprobe:vfs_fsync_range /@t[tid]/ { @ms = hist((nsecs-@t[tid])/1000000); delete(@t[tid]); }'
写放大常在此现形:一个业务写放大成 N 次物理刷盘(元数据日志 + 数据 + 索引),直方图会诚实地列出每次几毫秒。
罪状三:页缓存驱逐引发的读风暴。 指纹是 major fault 上升 + 大量重复读同一文件。有人把读热文件的内存让给了大批量顺序流,第二次读就得回盘。证据在 /proc/vmstat 的缓存指标趋势里。
IO 取证阶梯
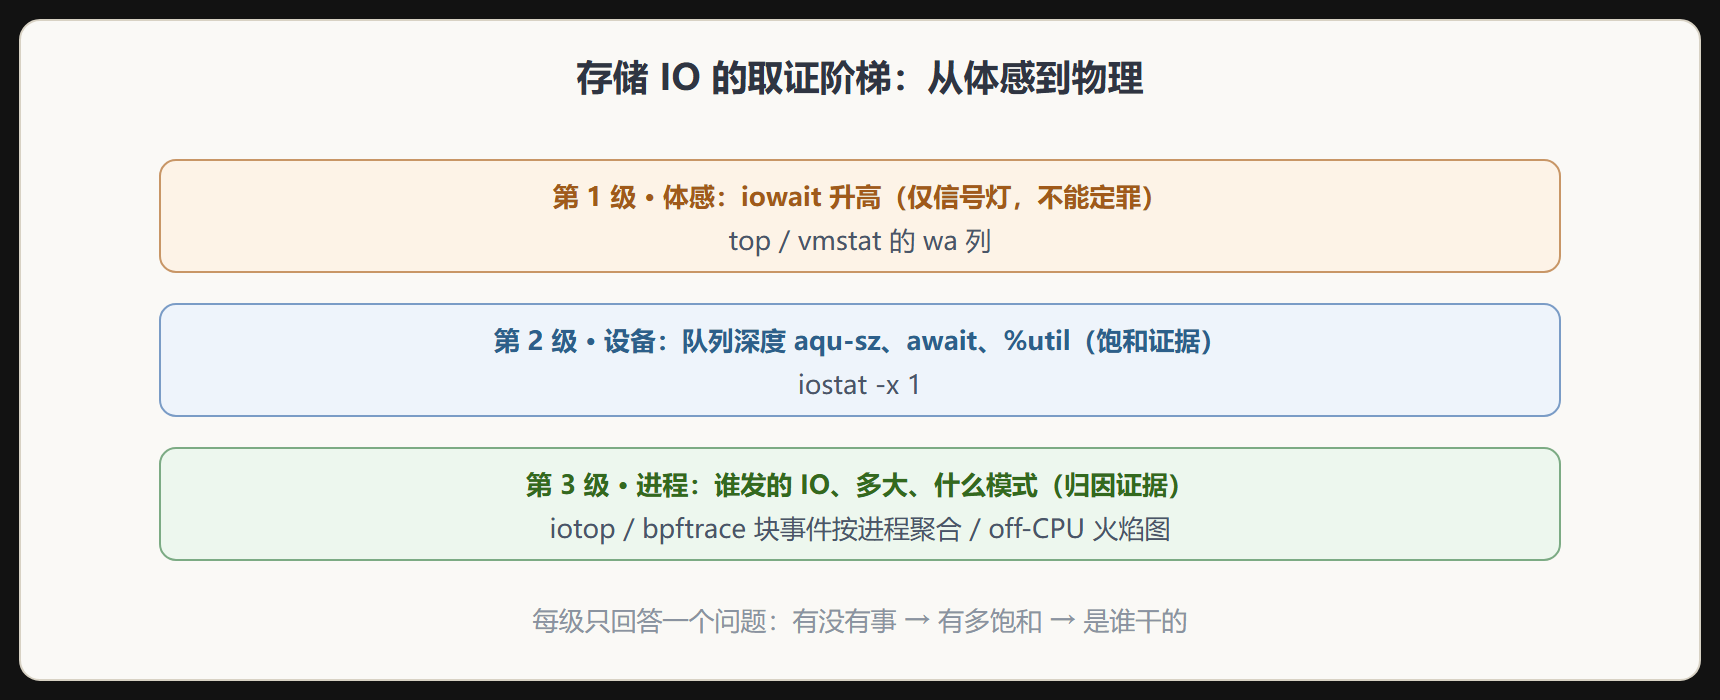
归因:找到发 IO 的进程
# 按进程聚合块层 IO(eBPF,内核态统计) biolatency-bpfcc -m 1 # 延迟直方图 biosnoop-bpfcc # 每次 IO 的进程、扇区、耗时
biosnoop 输出逐条 IO 明细:
TIME(s) COMM PID DISK SECTOR BYTES LAT(ms) 1.203 postgres 1204 sda 88123 8192 0.42 1.204 orders-api 3121 sda 12455 4096 11.8
同一个盘上,postgres 的读 0.4ms、orders-api 的写 11.8ms——慢的不是盘,是被同步刷盘卡住的那条路径。设备级统计说"有事",进程级归因才能说"谁的案子"。
本节要点回顾
- iowait 只是信号灯:低不能排除 IO 问题,高不能证明盘慢;
- 定罪看 aqu-sz 与 await:%util 对并行设备失真;
- 随机小 IO 先消灭再换盘:索引、攒批、异步化多数时候比硬件升级便宜且彻底;
- 同步刷盘用 fsync 延迟直方图取证,写放大会在分布里现形;
- biosnoop 做进程级归因:同一块盘上不同进程的待遇可以差 30 倍。
延伸:iowait 的正确读法
wa 是最容易误导人的指标:它是"CPU 空闲且有进程在等 IO"的时间占比,既是 IO 指标也是 CPU 视角。多核机器上一个 IO 等待线程会把 32 核里 1 核的 wa 稀释到 3%,看起来无害。读 wa 必须配合队列深度与完成延迟:
iostat -x 1 5 # 关注三列: aqu-sz(队列深度, 持续>1 即排队), await(完成延迟ms), # %util(忙度, 机械盘≈并发度, 闪存忙不等于饱和) # 找到是谁在压盘: 按进程聚合块层 IO pidstat -d 1 5
await 常年 20ms 且 aqu-sz 接近 1,机械盘特性;%util 100% 但 await 仅 0.5ms,NVMe 正常并发,两种"高 util"的结论完全相反。
延伸:预读与随机小 IO 的收益估算
改 IO 模式前先算账:顺序读依赖预读(默认 128KB),关闭或被随机访问打断后,4K 随机读吞吐只有顺序的几十分之一。估算公式很简单——每 IO 固定开销约 50–100µs(NVMe)或 8–12ms(HDD,含寻道),小 IO 场景 IOPS 上限 ≈ 1/单次开销,合并成 1MB 大读后单次开销不变但搬运量放大 256 倍。用 fio 验证两类负载的真实上限,再决定是调 read_ahead_kb、改批量写,还是换文件系统布局,避免凭直觉调参。
fio --name=seq --rw=read --bs=1M --direct=1 --runtime=30 --filename=/data/t fio --name=rnd --rw=randread --bs=4k --direct=1 --runtime=30 --filename=/data/t # 两者的 IOPS 与 lat 差距即为合并收益的上限