6.1 容器现场:命名空间下的观测盲区
6.1 容器现场:命名空间下的观测盲区
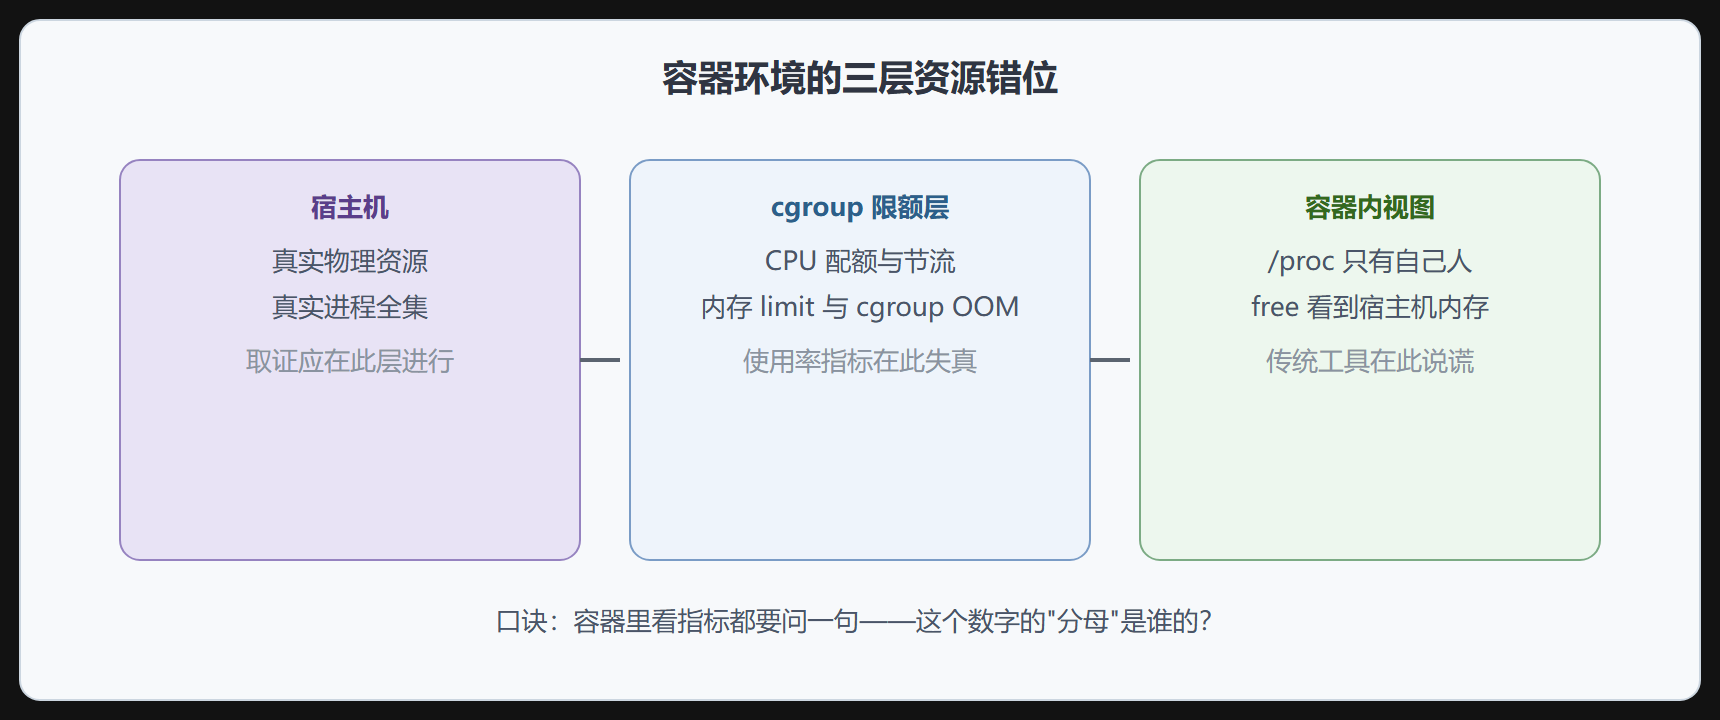
容器观测盲区源于三处:PID 命名空间让
/proc视角错位、cgroup 限额让"看得见的资源"与"可用的资源"脱钩、虚拟化屏蔽让 PMC 与部分内核追踪不可用。本节逐个拆这些盲区的成因与修复,并用容器 OOM 冤案做收尾案例。
盲区一:/proc 的视角骗局
容器里执行 top、ps,看到的是 PID 命名空间内的视图:宿主机上成百的进程隐身,自己永远是 1 号进程附近的小社会。两个直接后果:
- 进程级取证不全:CPU 到底被谁吃了,容器内看不到邻居,必须上宿主机视角;
- 内核可调参数错位:
/proc/sys默认是全局共享的,容器里改它影响全体,很多运行时干脆以只读挂载——要区分"容器专属"配置得走 cgroup 或独立 sysfs。
修复手段:在宿主机(或特权 sidecar)上跑全局工具,用 cgroup 路径过滤目标容器。现代工具链对此有一等支持:cAdvisor 按 cgroup 聚合资源指标,eBPF 工具天然工作在宿主机命名空间、再按容器分组上报。原则是:采集在宿主机,展示按容器切。
# 宿主机上按容器看 CPU(cgroup 分组) systemd-cgtop # 或直接读目标容器的 cgroup 计数器 cat /sys/fs/cgroup/<容器组>/cpu.stat
盲区二:看得见的资源 ≠ 可用的资源
cgroup 限额制造了大量"指标说没事、进程在被掐"的冤案。典型例子——CPU 限额节流(throttling):
cat /sys/fs/cgroup/<容器组>/cpu.stat
nr_periods 120000 nr_throttled 38412 ← 三分之一的周期被节流! throttled_usec 2140182334
容器 CPU 使用率常年显示 60%,看着健康,但 nr_throttled/nr_periods 高达 32%——每 100 毫秒的配额提前用完,剩下的时间整个 cgroup 被冻结。用户感受到的是周期性卡顿,而容器内任何"CPU 使用率"指标都不报警。这是容器时代最重要的单一指标盲区:使用率必须与节流计数一起看。
内存侧对应的是第 4.2 节埋的伏笔:容器 limit 2GB,JVM 按宿主机 64GB 默认比例开大堆,最终被 cgroup OOM 处决。修复方式:运行时感知 cgroup 限额(现代 JVM 默认按容器内存比例算堆上限),并把 limit 显式写进应用配置。
容器三层错位
盲区三:被屏蔽的内核能力
- PMC 不可用:虚拟化环境不透传性能计数器,
perf stat拿不到缓存/IPC 数据,退路是软件事件(cpu-clock); - ptrace 受限:容器默认 security 配置可能禁止
gdb attach,需要显式放开能力位; - BPF 与 ftrace 需要特权:普通容器没有权限加载 eBPF 程序,正确姿势是"宿主机侧的观测代理"统一采集,容器只产出应用层信号(指标、trace、日志)。
这套架构有个名字上的共识:观测代理模式——每个节点跑一个特权观测组件(node-local agent),代理全体容器的取证需求,应用容器保持最小权限。它同时解决了盲区一和盲区三。
冤案实录:容器 OOM 的三层误判
一个 Java 服务每三天被杀一次,三批人先后得出三个错误结论:
- 应用团队:"堆 dump 看了没有泄漏,是平台问题。"(对了一半:确实不是泄漏)
- 平台团队:"宿主机内存充足,监控无异常。"(宿主机视角没错,但凶手在 cgroup 层)
- 破案:
dmesg显示的 OOM 记录指向 cgroup 限额,而容器 limit 是 2GB、JVM 堆上限按宿主机内存推到了 1.5GB 再加元空间和堆外——总需求超过 limit,被 cgroup OOM 处决。修正 JVM 按容器 limit 比例设堆后,三周未再复发。
这个案子说明容器取证的纪律:每一层视角(容器内、cgroup、宿主机)都只看见自己那层,跨层取证才能闭合证据链。
本节要点回顾
- 采集在宿主机、展示按容器切:
/proc视角骗局靠全局代理式工具破解; - CPU 使用率必须配节流计数:
nr_throttled高占比解释"使用率不高却周期性卡顿"; - cgroup OOM 与系统 OOM 是两案子:验尸看
dmesg指向哪一层; - PMC/ptrace/BPF 在容器内受限,观测代理模式是标准解;
- 每个指标都问分母是谁的——容器取证的的第一反应。
延伸:/host 视角与容器视角的指标对账
容器内看到的 /proc/stat、/proc/meminfo 默认是宿主机全局值(除非 lxcfs/--cgroupns 虚拟化),导致"容器里 free 还有 10G、实际配额 512M 被掐死"的经典误判。对账动作:
# 容器视角 kubectl exec $POD -- cat /sys/fs/cgroup/memory.max 2>/dev/null \ || kubectl exec $POD -- cat /sys/fs/cgroup/memory/memory.limit_in_bytes cat /sys/fs/cgroup/.../memory.current / memory.events # 真实配额与 oom 计数 # 宿主视角交叉验证 crictl stats --refresh 3 # runtime 的用量口径 ps -o pid,cgroup_throttled= -p $PID 2>/dev/null || cat /sys/fs/cgroup/.../cpu.stat
写监控时指标来源要统一声明:container_memory_working_set_bytes(cgroup 口径)与进程 RSS(宿主口径)混在一张图里,容量规划必然做错。
延伸:sidecar 采样探针的部署形态
在受限于平台无法进容器装 agent 时,用 DaemonSet 形态在宿主机上旁路采集:perf record 支持 -p <host pid>,eBPF 探针按 cgroup id 过滤即可只看目标容器,对业务零改动。代价是宿主内核版本决定 eBPF 特性可用性,探针镜像要跟随内核小版本矩阵测试。这种"平台级旁路 + cgroup 过滤"的形态,是大规模容器集群持续剖析的标准答案,也规避了每容器装探针的开销放大问题。