6.2 跨服务追踪:分布式链路的证据链
6.2 跨服务追踪:分布式链路的证据链
分布式追踪(Distributed Tracing)通过在请求头里透传追踪上下文,把一次请求跨多个服务留下的片段(span)串成完整链路(trace),从而回答单机证据回答不了的问题:端到端 800ms,每一毫秒花在哪个服务、哪次网络跳转、哪段排队。它是分布式性能案件的核心证据组织形式。
问题:单机证据在微服务面前失效
下单接口 P99 是 900ms,涉及 8 个服务。每个服务自己的监控都说"我这边 P50 只有 20ms"。三种经典解释陷阱:
- 均值掩盖:各服务 P50 都好,但每次请求总有一两个服务抽风,轮流当罪魁;
- 排队错位:慢的不是服务处理,是它调下游时在连接池里排队——单机指标根本不含这段;
- 扇出放大:网关聚合 10 个下游,其中 1 个慢拖整体,但网关自身指标只显示"等了很久"。
要拆这类案子,必须有一条贯穿全程的证据链,把"同一次请求"在各处的片段对齐到同一时间轴上。
Trace 与 Span:证据链的数据结构
- Trace:一次端到端请求的全部证据集合,全局唯一 ID;
- Span:一个工作单元(一次服务处理、一次数据库查询、一次消息投递),带起止时间、父 Span 指针。
上下文靠请求头透传(业界标准是 W3C Trace Context 的 traceparent 头)。关键细节:跨度创建容易,跨异步边界传播难——扔进消息队列、丢给线程池的任务,若没把上下文显式带过去,链路就断在边界上。断链的案子只能分段审。
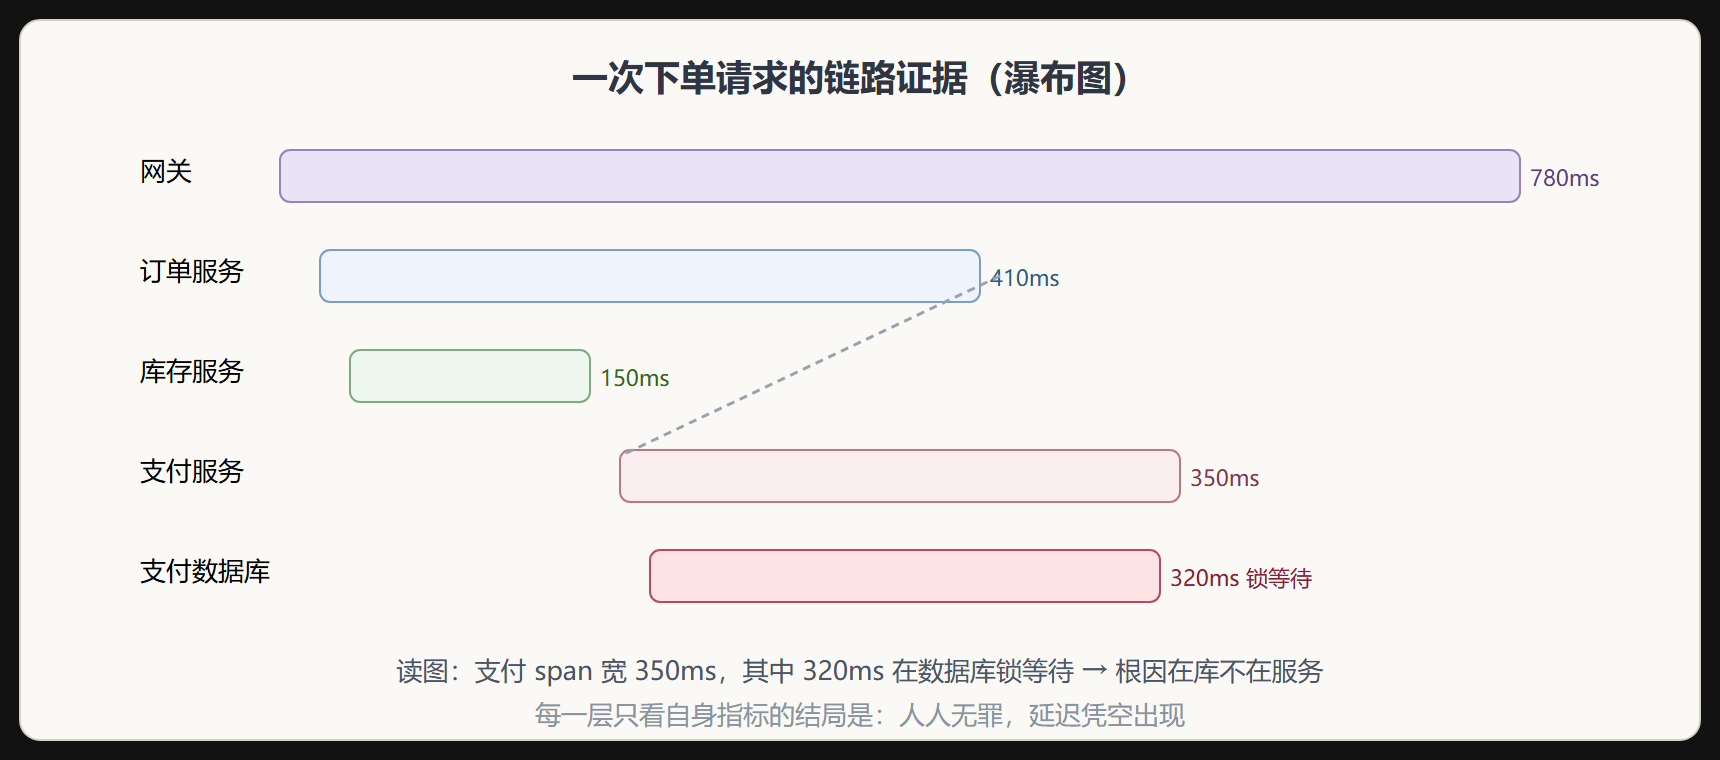
这张瀑布图就是分布式案件的卷宗形态:宽度即耗时,嵌套即因果。读图纪律是找最宽的叶子——本案支付数据库 320ms 锁等待,占端到端 41%,一击定罪。
采样:不可能全采,采多少才够
全量追踪的开销与存储都是灾难(每请求几十个 span)。采样策略三档:
| 策略 | 做法 | 特点 |
|---|---|---|
| 头部采样 | 请求入口按概率决定追踪与否(如 1%) | 简单便宜,但恰好漏掉罕见慢请求 |
| 尾部采样 | 全程记录,末端按结果决定保留(保留慢的、错的) | 能抓住"万分之一慢请求",成本最高 |
| 混合 | 正常流量低概率 + 错误/超时必留 | 实践主流 |
慢请求恰恰是低概率事件,头部采样容易把最需要的证据按概率扔掉——这是设计采样策略时最值得花钱的地方。
从链路到根因:加维证据
链路定位"慢在哪个环节",要定罪还需要在该环节内加维度:
- span 标签:数据库 span 带上 SQL 指纹、行数;HTTP span 带状态码、重试次数;
- 与剖析联动:trace 上下文传给采样剖析器,慢请求发生时刻的火焰图可以按 trace ID 关联(第 6.3 节的持续剖析提供了时间维对齐的可能);
- 与日志联动:日志行带 trace ID,从链路一键跳到该请求的全部日志——这是排查从"哪个服务慢"走到"哪行代码错"的桥。
⚠️ 常见坑:跨线程与异步任务不透传上下文,链路在边界断裂,最长的那段等待恰好记录不到。接入追踪时,框架的线程池、消息队列的消费者两端都要显式处理上下文传播。
本节要点回顾
- trace/span 是证据链的数据结构:宽度即耗时、嵌套即因果、全局 ID 即对齐轴;
- 最宽的叶子是第一嫌疑:端到端延迟的分布读法;
- 采样决定能不能抓到真凶:尾部采样或"错误必留"是慢请求案件的保命配置;
- 断链发生在异步边界:线程池、消息队列两端都要透传上下文;
- 链路定位环节,日志与剖析定罪代码,三类证据靠 trace ID 串联。
延伸:trace 上下文的传播格式
链路追踪的前提是 trace id 沿调用链无损传播。W3C traceparent 是当前标准头,格式固定为 版本-traceid-父spanid-标志,任何一跳丢失(异步队列、线程池切换、第三方 SDK 未透传)都会把一条链切成两段,取证时先验传播完整性:
# 网关侧注入标准头 curl -H 'traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01' \ http://svc-a:8080/start # 各服务入口打印接收到的 traceparent, 对照中间件配置: grep -R "traceparent" config/ | grep -v propagate # 找到未透传的一跳 # 异步边界显式续链 (伪码): # producer.headers("traceparent", current.traceparent()) # consumer: extractor(headers).continue_span()
延伸:从链路图到定罪的三步法
拿到一条慢链路 trace 后的固定动作:第一步找"最长 span"与"最长 gap"——gap 是 span 之间的空档,指向队列等待或未插桩环节;第二步看 span 的 tag 分类(db.query / http.call / lock.wait),把 500ms 拆成各占多少;第三步带着定位结果跳到对应服务的持续剖析快照(按 trace id + 时间窗关联),把分布式结论落回单机证据。三步走完,"链路慢"才能翻译成"某服务某函数某等待",否则链路系统只是故障树的观光电梯。
span 时间轴分解示例 (总 612ms) svc-a handler [############-------- 380ms] db.query 310ms └ db SELECT order [########## 310ms] <- 定罪点: 慢 SQL gap 42ms (队列/序列化, 未插桩, 需补中间件埋点) svc-b downstream [#### 190ms]
链路取证的最后一公里是把证据交还给具体的人。一条跨五个服务的慢 trace,定罪点落在其中一个服务,但该服务的 owner 收到的往往只是一张截图。规范的做法是告警里携带可点击的 trace 深链与时间窗参数,owner 打开后直接看到展开的慢 span、关联的日志(按 trace id 聚合)与该时段的剖析差分。工具链打通这一跳的组织价值常被低估:它决定了定罪证据的传递是否失真,也决定了"协作排查"是共享一张不断被重新截图的图,还是共享同一份可回放的数据。