7.1 低延迟系统:纳秒级现场取证
7.1 低延迟系统:纳秒级现场取证
低延迟系统(高频交易、实时控制、广告竞价)的性能敏感度进入微秒与纳秒量级,此时任何观测工具本身都是重大干扰源:一次缓存未命中 100ns,一次上下文切换 5μs,而 strace 一类工具的代价以毫秒计。取证的武器必须换一套:被动计数器、硬件时间戳、离线回放。
先建立量级感
低延迟世界的数字与常规服务完全不同档:
一次 L1 缓存访问 ~1 ns 一次分支预测失败 ~10-20 ns 一次末级缓存未命中回内存 ~100 ns 一次 NVMe 读 ~10,000 ns (10 μs) 一次上下文切换 ~1,000-10,000 ns 一次跨核锁竞争 可达数万 ns 一次 perf 采样的栈回溯 数千 ns(对热点路径已经很重)
对照目标:高频交易的关键路径预算常在几微秒。一次上下文切换就能吃掉整个预算,更别说打断点了。这个量级表本身就是设计工具——每个优化提案先问它省的是哪一档的纳米/微秒,再问值多少工程量。
取证悖论与三板斧
第一板斧:被动计数器。 CPU 的 PMC 与运行时的内部计数(分支失败、缓存未命中、反汇编停顿)由硬件/运行时自动维护,读取是旁路的,不碰关键路径。低延迟系统的主要持续证据来自这类零打扰通道。
第二板斧:硬件时间戳。 软件计时用的时间戳计数器读取本身就有几十 ns 的代价且可能串行化,测量纳秒级路径要靠硬件时间戳单元(如网卡在收包时打的时间戳),把"测量"外包给不占用 CPU 的设备。
第三板斧:离线回放。 生产环境只记录输入流(零处理逻辑,纯追加写入环形缓冲),真实执行与分析全部在回放环境进行。生产侧的观测代理永远不进热路径。
常规武器在低延迟世界的禁用清单
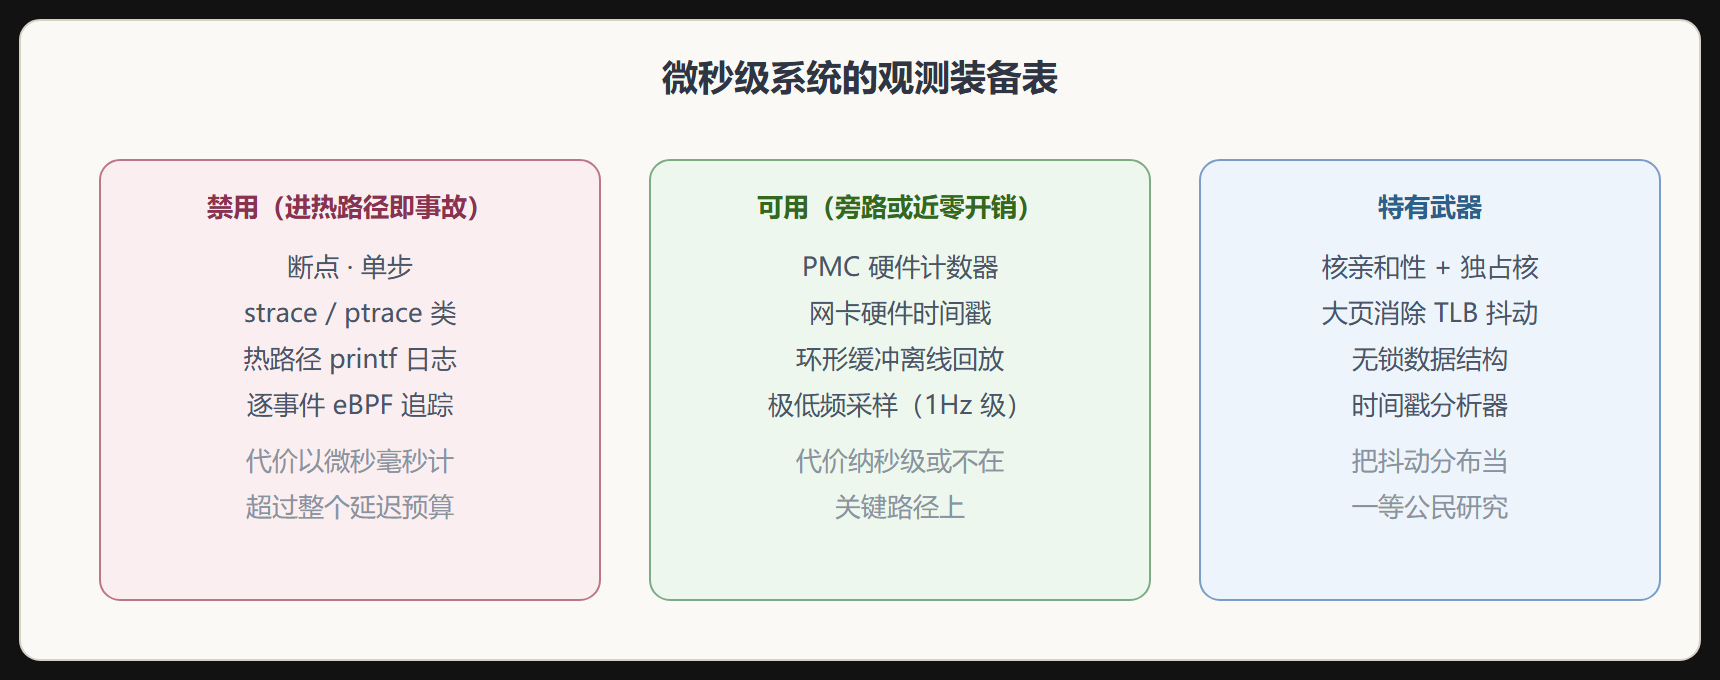
抖动分析:低延迟案件的主证据
常规服务看平均与 P99;低延迟系统看抖动分布的尾部——P99.99 甚至最差单次。因为控制类与竞价类系统里,一次 200μs 的毛刺就可能造成实际损失,均值再漂亮也没意义。
典型取证框架:
- 关键路径两端打硬件时间戳,差值写入无锁环形缓冲(不在原地做任何统计);
- 离线分析直方图,寻找毛刺聚簇:毛刺是均匀散布还是集中在特定时刻?
- 集中在整秒边界的 → 某个周期任务(监控采集、统计上报)在抢核;
- 与系统事件对齐:毛刺时刻比对上下文切换记录、CPU 迁移记录、缓存污染嫌疑。
一个真实模式:毛刺每 60 秒一簇,对齐后发现与某统计任务同相。该任务被挪到独占核后,P99.99 从 180μs 降到 60μs。低延迟优化的常见形态不是让快的更快,而是把毛刺的来源隔离出去——NUMA 绑定、内核旁路网络、禁用 CPU 频率调节,全是同一种思路。
⚠️ 常见坑:在低延迟系统上部署常规监控代理(每 10 秒采一轮全量指标)。代理的每次唤醒都是抖动源,监控本身成了最大的性能案件——这类"侦探成为嫌疑人"的剧情在低延迟圈反复上演。
本节要点回顾
- 量级表是第一工具:每项开销对号入座,才知道什么值得优化、什么不能碰;
- 取证三板斧:被动计数器、硬件时间戳、离线回放,全部旁路热路径;
- 看抖动尾部不看均值:P99.99 与最差单次才是有效证据;
- 毛刺对齐系统事件是主要破案手法:周期任务、核迁移、频率调节;
- 优化重心是隔离毛刺源(独占核、内核旁路),不是压均值。
延伸:延迟预算表的编制与核算
纳秒级系统的第一工具不是探针,是一张延迟预算表:把整个处理路径拆成环节,给每段分配预算,实测后逐行核销。超支环节立即现形,取证从"找异常"变成"对账":
[路径预算 vs 实测 (单向, 纳秒)] 环节 预算 实测P50 实测P99 结论 网卡DMA->内核 100 82 145 P99超支, 查中断合并 内核->用户态 150 118 160 达标 解析+路由 800 640 720 达标 风控查表(共享内存) 500 470 690 P99抖动, 查NUMA远端访问 下单写日志(异步) 300 280 310 达标
核算用 perf -e cycles 精确计时段落,或 TSC 时戳打点(rdtsc 开销约 6–20ns,可接受),预算表进版本库随代码演进,任何改动的 PR 必须附新核销数据。
延伸:jitter 源头的逐项排除清单
抖动源排查是清单化工程:CPU 频率漂移(锁频 cpupower frequency-set -g performance)、核迁移(taskset -c 绑核 + 关闭 irqbalance)、NUMA 远端内存(numactl --membind)、页错误(大页或 mlockall)、内核活动(隔离核 isolcpus、关闭 tick nohz_full)、缓存污染(隔离关键核的 LLC way)。每项都有开关与验证命令,例如验证中断是否已被驱离关键核:
cat /proc/interrupts | awk '$1 ~ /:/ {print}' | grep -v eth0 # 看分配 # 期望: 关键核上只剩 timer 最小中断; watch -d cat /proc/interrupts 观察增量
收尾强调测量本身的纪律:纳秒级世界里,测量工具的自身开销不能再忽略,clock_gettime 约 20–30ns、rdtsc 约 6–20ns、一次缓存未命中约 100ns——计时打点本身可能就是最大的被测段。惯用做法是成对打点并测量"空段"(两相邻打点间无代码)得到打点自身开销,从结果里扣除;热路径避免函数调用(内联或宏),防止测量改变内联与寄存器分配。低延迟取证的最后一课是永远怀疑自己的尺子:先用已知延迟的注入实验校准计时管线,再信它的读数。
关于团队协作再补一句:低延迟系统的取证结论几乎都依赖"同一实验多次运行的分布",单次运行的纳秒级数字没有意义,因此实验管理与工具同等重要——固定种子、固定数据集、固定核隔离配置,每次实验记录环境指纹(内核版本、微码、BIOS 设置、网卡固件)。没有环境指纹的实验数据,三个月后连"当时跑在哪台机器"都答不上来,遑论复现。把实验记录当初级案卷管理,是纳秒级工程区别于普通服务的纪律成本,也是它的护城河。