7.2 AI 法证:机器学习辅助的异常定位
7.2 AI 法证:机器学习辅助的异常定位
AI 辅助的异常定位指用统计与机器学习模型在海量指标、日志、链路中自动筛查嫌疑:异常检测圈出"不正常的时刻"、日志聚类压缩海量文本、根因排序给出"最可能的肇事组件"。它是侦探助手而非法官——推荐嫌疑,定罪仍靠人拿证据。
为什么需要机器筛查
一个中大型系统的监控规模:数千个服务 × 每服务上百指标 × 秒级采样,再加每日 TB 级日志。人肉看图的时代在这个体量前早已结束。更麻烦的是告警风暴:一个数据库抖动,下游 40 个服务全部报警,值班同学收 300 条告警——真正需要处理的只有 1 条。
AI 法证解决的是筛查与排序,不是推理。三类成熟形态:
| 形态 | 做什么 | 典型效果 |
|---|---|---|
| 异常检测 | 学习指标的正常波动带,偏移即报 | 比静态阈值少一个量级的误报 |
| 日志聚类 | 海量日志按模板归并,新模板即异常信号 | 亿行日志压成几百个模式 |
| 根因排序 | 结合拓扑与告警传播,给嫌疑列表 | 把 300 条告警收敛成 1-3 个嫌疑 |
异常检测:动态基线的价值
静态阈值("CPU 超 80% 报警")在周期性业务面前误报不断:每天晚高峰都超,每次都响,最后被静音,真事故反而漏掉。基于季节性模型(按小时/周周期分解)的动态基线,预期值随时间波动,只在"偏离当下应有水平"时报警。
一个直观对比:静态阈值下,晚高峰的正常上涨全部误报;动态基线下,只有"今晚比往常同时刻高出 30%"才触发。前者训练值班人员忽略告警,后者保住告警的信用。
判读动态基线报警时注意它给的是偏离度不是绝对值:偏离 5 倍但绝对量很小的指标(如某边缘服务的错误计数从 2 涨到 10)可能不如偏离 20% 的大流量指标重要。排序仍要结合业务权重。
根因排序:告警的传播树
告警风暴里藏着结构:故障从故障点沿依赖拓扑向下游传播,越靠近"源头"的报警越早出现、传播扇出越大。根因排序算法利用这两条线索:把报警按时间与调用拓扑对齐,找最上游、最能解释其余报警的节点。
告警风暴: [db-slow] → [orders-latency] → [gateway-latency] → [checkout-error] → [search-latency] ... 根因排序输出: 1. db-slow (首报 + 下游扇出全覆盖, 置信度 0.93) 2. orders-latency (可能是共因受害者)
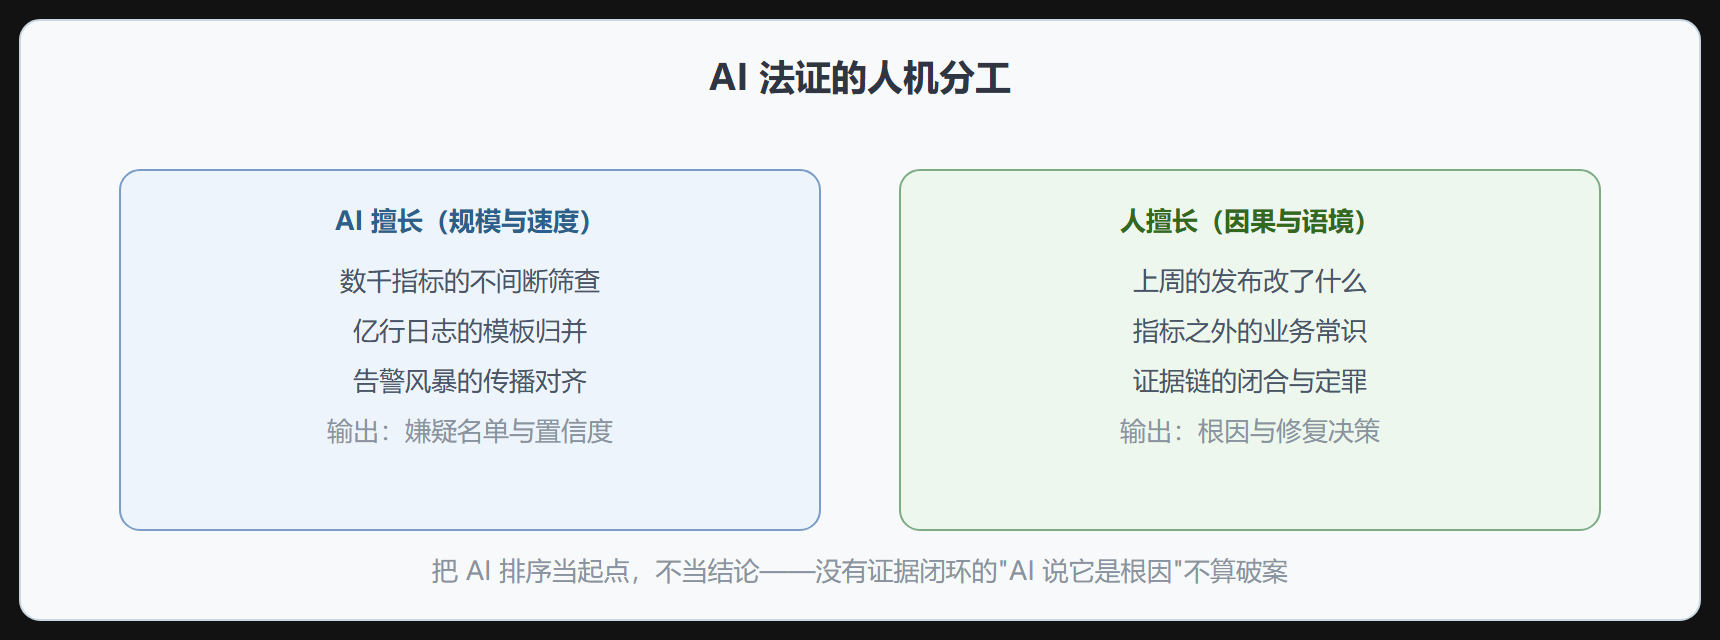
排序给了起点,接下来的动作仍是人的事:登数据库取证(第 4 章流程)、确认锁或 IO 的饱和证据。AI 把"从哪开始查"从猜变成排序,但证据链仍要人闭合。
人机分工的边界
落地姿态与坑
- 从日志聚类起步:投入小、见效直接,模板化日志的"新模板报警"往往比指标更早暴露问题;
- 异常检测先上非关键指标磨合基线,再扩到核心链路——模型冷启动期的误报会消耗信任;
- 根因排序依赖拓扑质量:服务依赖图过时,排序就是 garbage in garbage out。拓扑数据的维护常是被忽视的隐性成本;
- 保留人的复核位:每次 AI 排序与最终根因不符的案例要回流为标注数据,系统才越用越准;没有回路的 AI 法证不会进步。
大模型加入后新增了两块能力:自然语言查询指标("给我看支付服务昨天 P99 最差的半小时"直接出图)和事后报告初稿生成(时间线、影响面、嫌疑排序自动成文)。但结论部分仍需工程师填入证据链——生成式文本擅长组织叙事,不擅长对真实性负责。
本节要点回顾
- AI 法证的定位是筛查与排序:动态基线、日志聚类、根因排序三件套;
- 告警传播树的两条线索:首报时间与扇出覆盖,上游源头优先;
- 偏离度不等于重要性,排序要叠加业务权重;
- 拓扑质量决定根因排序上限,维护成本是隐性账单;
- 人机分工的铁律:AI 给嫌疑名单,定罪必须有人的证据闭环。
延伸:异常检测的特征工程
监督学习在排障领域不成立(故障样本太少),主流是无监督密度估计:以分钟粒度采集多维特征(各资源使用率、各接口分位延迟、错误计数、GC 停顿、上下文切换),训练季节性基线模型,对新数据点算偏差分。特征设计决定上限:
import numpy as np from sklearn.ensemble import IsolationForest # 特征: [p50,p99,err_rate,qps,rss,ctxsw,gc_pause] 按小时组成 7 维 X = np.loadtxt("metrics_hourly.csv", delimiter=",") clf = IsolationForest(contamination=0.01, random_state=0).fit(X) score = -clf.score_samples(X) # 越大越异常 print(np.argsort(score)[-5:]) # 最异常的 5 个小时段
告警只报"分数突增的小时段 + 该时段贡献最大的特征维度"(用树模型的 feature contribution),值班同学拿到的是"02:00–03:00,主导因素 p99 与 gc_pause",而非一个裸分数。
延伸:人机分工的边界
AI 法证的诚实定位是"收窄嫌疑范围",不是"给出根因"。异常检测负责在数万指标里挑出值得看的时段与维度;调用栈聚类负责在持续剖析的百万栈里把相似形态归并、把新形态顶到前排;根因确认仍由人执行——因为模型的训练分布里没有"昨晚上线的新代码"这类信息。落地时把 AI 输出当成"立案建议书"接进取证流程的第一步,而不是当成结案报告,这条边界划清后,误报不会摧毁信任,漏报有下一层 USE 检查单兜底。
落地路径建议从小闭环开始:先在离线数据上回放历史事故,检验模型能否把已知故障时段排到异常榜前列——这是最有说服力的验收方式;通过后再接实时流做影子运行(只记录不告警)两周,统计误报率;低于阈值才切真告警,且初期只给固定接收组。这个渐进流程把"AI 告警"从信仰问题变成工程问题,也给了模型迭代的数据飞轮:每次人工确认或驳回都成为标注样本,三个月后模型对"你们的环境里什么算异常"的理解,会超过任何通用产品。