7.4 生态与趋势:从 DTrace 到持续观测
7.4 生态与趋势:从 DTrace 到持续观测
本节回望性能工具六十年的演化主线——从打印语句到符号调试器、从 DTrace 的动态追踪革命到 eBPF 与持续观测——并给出当下生态的地图与选型思路。看清来路,才能判断手中工具的位置与去处。
四次浪潮:一条"降低观测门槛"的主线
1960s-80s 石器时代:printf 与日志 侵入式、改代码才能看、时序污染严重 1980s-90s 调试器时代:GDB/DBX + ptrace 断点单步变量,逻辑可控但开销暂停级,仅限开发环境 2000s 动态追踪革命:DTrace(Solaris) 生产系统不重启即可插探针,D 语言写聚合 "观测生产环境"从禁忌变成日常 2008-至今 采样与 eBPF 时代:perf、ftrace、eBPF 硬件计数器 + 内核虚拟机,开销进入 1% 量级 观测从"救火行为"演进为"常驻设施"
每次浪潮的驱动力相同:复杂性增长倒逼观测透明度,而透明度的价格必须不断下降。printf 时代看一眼要付出重新编译的代价;DTrace 把代价降到"不重启";eBPF 把代价压到百分之一并保证了安全性。下一浪大概率继续这个方向:观测更便宜、更常驻、更自动。
DTrace 值得单独致敬:它首创的"探针 + 聚合 + 安全语言"三件套,几乎是 eBPF 的完整蓝图——kprobe 的前身、bpftrace 的语法灵感、乃至"内核态过滤"的架构决策,都能在 DTrace 里找到原型。Linux 没有直接继承它,却在十年后以 eBPF 完成了同等乃至更强的能力,且因 Linux 的体量把这个范式变成了全行业的公共设施。
生态地图:按层选型
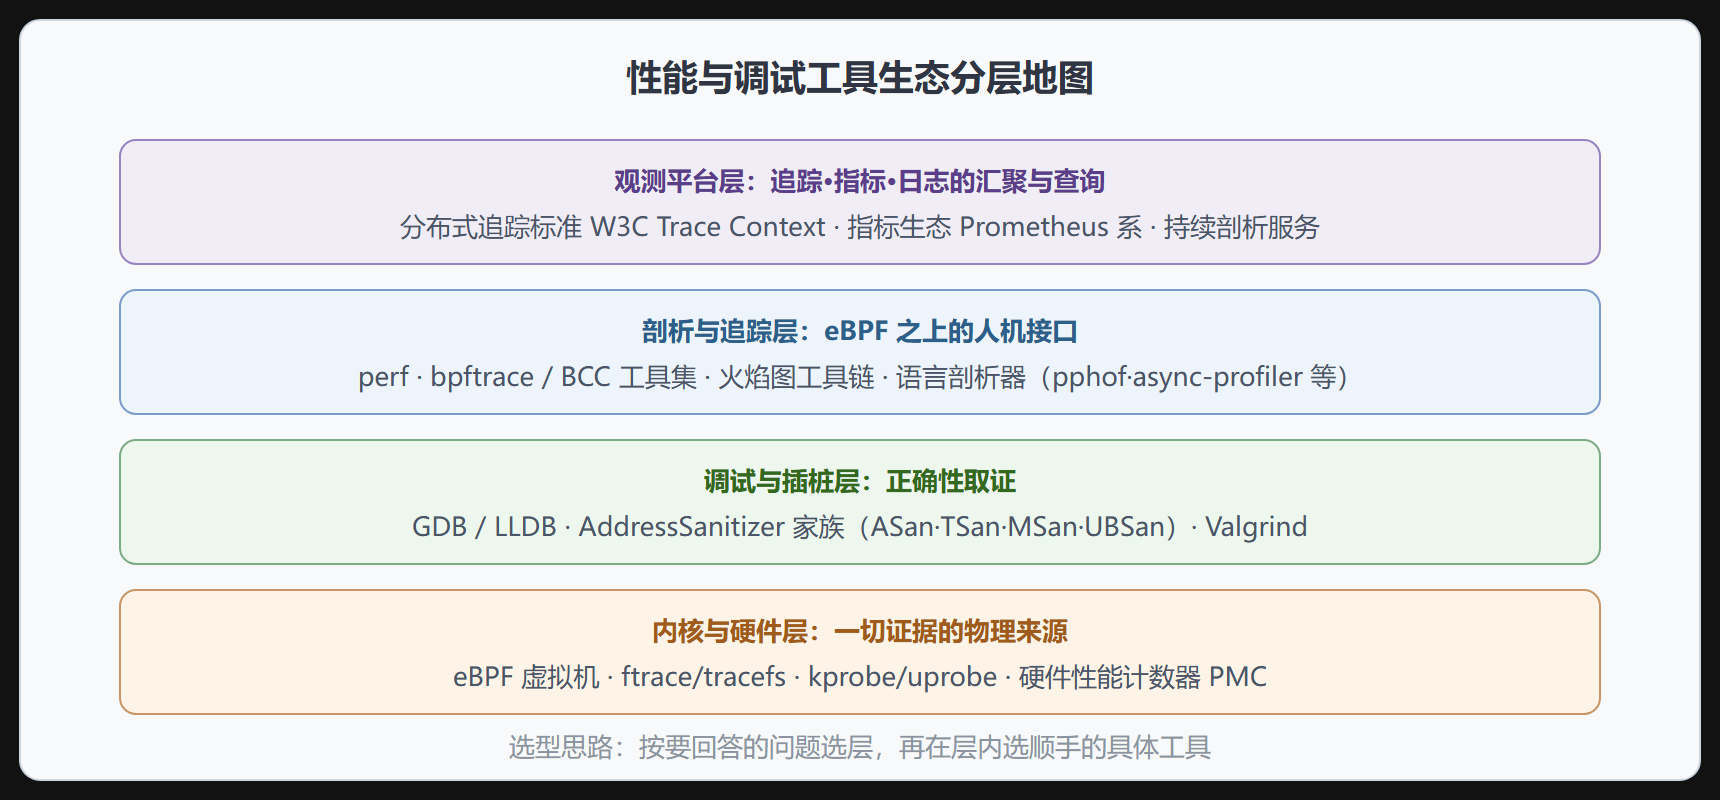
选型不用纠结工具本身,先问问题属于哪层:慢在哪(剖析层)还是哪里错(调试层)?单机(内核层够用)还是跨服务(平台层)?同一层内工具差异远小于层间差异——第 3 章的任何采样工具都能给你火焰图,跨层选错才是时间黑洞。
语言生态的差异
- C/C++/Rust:最全套,本文全部工具适用;代价是要自己处理符号、帧指针、sanitizer 构建;
- Go:运行时自带剖析接口(pprof 的 CPU/heap/mutex/goroutine 剖析),零接入成本,生态最顺滑;
- JVM 系:async-profiler 基于 perf 事件做采样,加上堆转储与 GC 日志,自成体系;
- 解释型语言(Python/Node):原生栈与 VM 栈分离是主要障碍,选语言专属采样器(如 py-spy,基于进程内存读取的旁路采样,连目标暂停都不需要)。
还在路上:三个未解问题
- 多语言统一追踪:跨语言服务里,内核层证据齐了,应用层各语言各自的探针格式仍未统一,跨语言火焰图仍是组装活;
- 存储成本:全量链路 + 持续剖析的数据量增长快于其价值密度的增长,尾部采样、智能压缩仍是活跃课题;
- AI 的证据闭环:第 7.2 节的根因排序在进步,但"AI 结论 + 自动验证证据"的完整闭环还没有成熟形态——目前仍是推荐与人证的混合模式。
全书收在这句话上:工具的浪潮会继续更迭,但取证的方法论不变——保全现场、采集证据、建立可证伪的假设、用数据定罪。换任何新工具,这四步都是你的立身之本。
本节要点回顾
- 演化主线是观测价格的持续下降:从重新编译到不重启再到 1% 常驻;
- DTrace 是现代动态追踪的蓝图,eBPF 把这个范式变成了行业公共设施;
- 选型先选层再选工具:层间差异远大于层内差异;
- 语言生态深度不一:Go/JVM 顺滑,C 系全套但自理成本高,解释型语言要用专属采样器;
- 未解问题指向未来:跨语言统一、存储成本、AI 证据闭环。
延伸:跨平台探针的可移植性策略
团队技术栈跨 Linux 与 *BSD/ illumos 时,探针层要抽象出中间层:业务埋点用 OpenTelemetry 统一语义(跨平台),系统层探针按平台各备一套但共享输出格式(符号名、栈、时戳统一为文本行或 protobuf),后端分析工具只认统一格式。这样 DTrace 与 bpftrace 的差异被隔离在采集端,分析技能可复用:
[探针抽象层] 业务事件 -> OpenTelemetry API (平台无关) 系统事件 -> Linux: bpftrace/perf ; illumos: DTrace 输出统一: <ts,pid,comm,event,payload> 行格式 分析层 -> 同一套脚本处理两种来源的落盘格式
延伸:持续观测的演进坐标
生态从 DTrace 开创动态追踪、perf/eBPF 把它带进 Linux 主流、再到 OpenTelemetry 与持续剖析把"观测"变成默认常开的基础设施,演进方向始终是两条:观测的边际成本持续下降(从专家独占到全员默认),证据的时间粒度持续变细(从分钟指标到纳秒事件)。判断一项新观测技术值不值得投入,就看它在这两条轴上的位置——凡是能把某类证据的采集成本降一个量级的(如 eBPF 之于内核观测、rr 之于并发复现),都值得提前布局;只改变展示形态的,等生态自然收敛即可。本教程的取证方法论在每一代工具上都成立,变的只是取证装备。
给技术选型者的最后一条观察:观测生态的每次代际更替,都伴随"证据所有权"的转移——DTrace 时代证据属于会用 D 脚本的专家,eBPF 时代下放到平台团队,OpenTelemetry 与持续剖析把部分证据交还给了应用开发者本人。评估新工具时除了功能,多问一句"它让谁离证据更近":拉近平民与专家距离的工具通常赢,加深鸿沟的工具再强大也难成主流。这也是本教程以方法论而非工具为主线的原因——工具会换主人,取证纪律属于留下来的每个人。
回头看本书用过的工具,也能印证这条轴:strace 逐事件昂贵、perf 采样便宜、eBPF 把内核事件的采集成本压到可常驻、rr 把"复现并发 Bug"的成本从数天压到数小时。每一件都是把某类证据的边际成本打下来,随后该类证据就从"专家的独门"变成"团队的默认"。按这个标准审视你手里的观测栈:哪类证据今天还要专门的人、专门停机才能拿到?那既是你的短板,也是下一代工具最可能出现的方向——提前留意那些正在把它变便宜的项目。