7.3 结案清单:性能工程的 Best Practices
7.3 结案清单:性能工程的 Best Practices
性能工程化是把前六章的取证能力沉淀为制度:性能预算在先、回归门禁在中、复盘归档在后。没有制度,性能好坏取决于谁在值班;有了制度,性能成为可持续管理的工程属性。本节是一份可以直接拿去落地的清单。
事前:预算与契约
性能问题的最贵解法是"出事后优化"。便宜得多的解法是把性能当需求管理:
- 延迟预算:端到端目标(如 P99 < 300ms)按链路分解到每个服务(网关 20ms、订单 80ms、支付 120ms……)。分解过程就是架构谈判:谁超预算,谁出优化排期;
- 资源预算:每服务的 CPU/内存/IO 配额写进部署描述,超出要审批——防止一个失控服务挤压邻居;
- 数据结构契约:热路径上的序列化格式、缓存策略、批量大小在设计评审时过一遍,这些决定性能上限的因素事后极难改。
预算的价值不在数字本身,而在让取舍显式化:功能上线要不要牺牲 10ms,变成一个看得见的决策而不是无声的退化。
事中:门禁与常态观测
- CI 性能回归门禁:关键路径的基准测试进流水线,每次提交对比基线,退化超阈值(如 5%)阻断合并。关键细节是基准要隔离环境 + 多次运行取分位数,否则机器噪声会让门禁狼狈到被关掉;
- 持续剖析常开(第 6.3 节):1% 换"任何时刻可回看";
- 发布关联:指标与剖析数据打版本标签,任何异常先查"最近改了什么"——多数性能案件的第一嫌疑人就是最近的发布;
- sanitizer 轮巡:CI 定期任务用 ASan/TSan 构建跑核心用例,内存与并发案件在测试阶段拦截。
# 一个最小可行的性能门禁示意(基准跑三次取中位数对比基线) # bench 基线存于性能数据仓库,随主分支滚动更新
事后:复盘的纪律
性能事故复盘最忌讳"根因:XX 服务慢,已优化"。合格的复盘卷宗包括:
- 时间线:首发症状、扩散过程、定位动作、恢复时刻;
- 证据链:当时的火焰图/链路/日志快照(第 1.1 节的案卷目录直接复用);
- 根因:能写成完整因果句("因为索引缺失导致全表扫描,IO 队列饱和,所以……");
- 为什么没拦住:哪道门禁缺失或失效——这类问题比根因本身更值得改;
- 防复发动作:监控项、门禁规则、预算调整,逐项有负责人。
能力建设:团队层面的复利
| 投资 | 一次成本 | 复利 |
|---|---|---|
| 取证工具统一封装(脚本库) | 人周级 | 每次故障少 30 分钟摸索 |
| 案卷知识库 | 每案 1 小时 | 重复案件秒级对号 |
| 性能培训(本书内容的内化) | 季度半天 | 值班不再是轮盘赌 |
| 基准与门禁维护 | 持续小投入 | 回归当天发现而非用户先发现 |
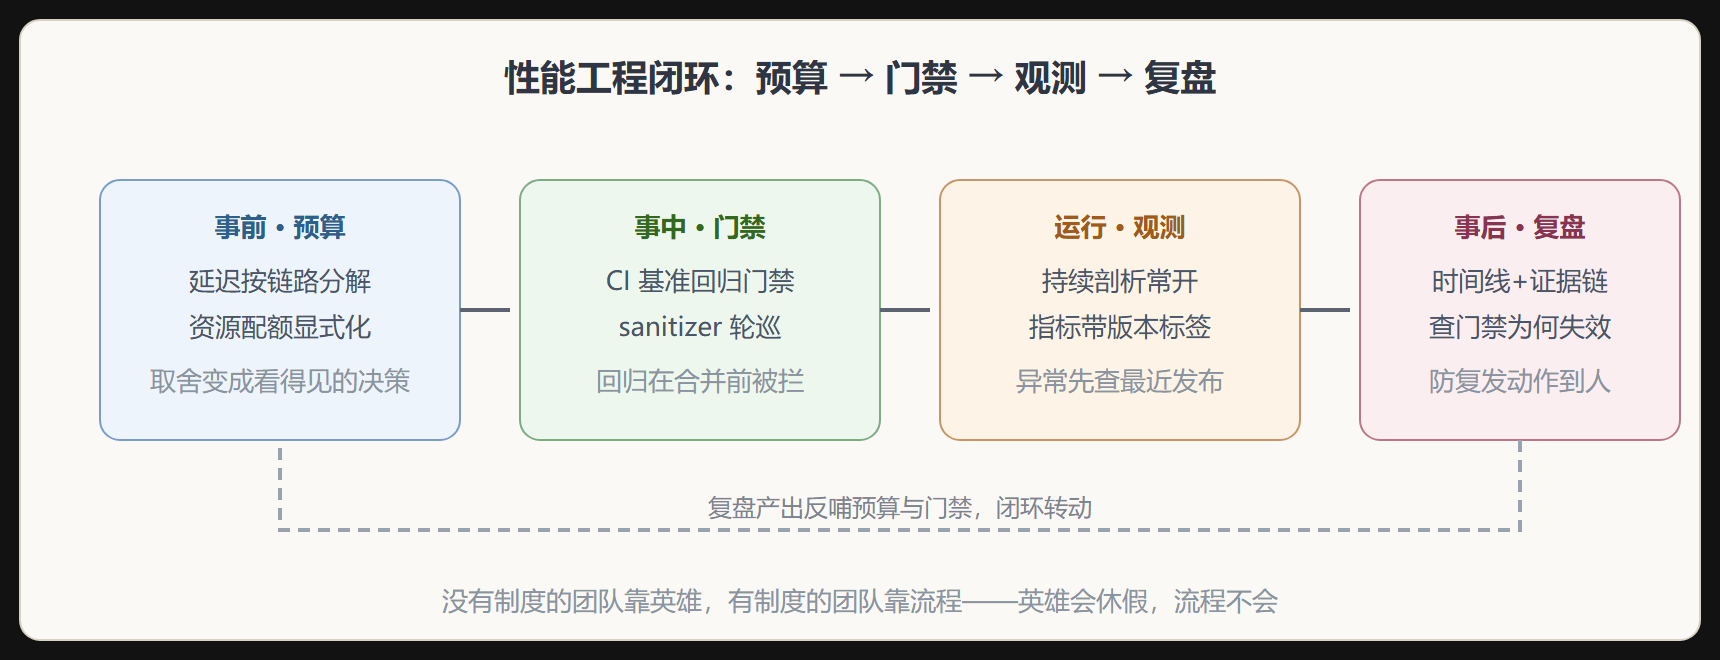
工程闭环全景
常见陷阱(按出现频率排)
- 基准测试在共享环境跑:CI 机器上的噪声让门禁形同虚设,宁可减少基准数量也要隔离环境;
- 优化无基线:没测量就动手,做完也不知道有没有效果——第 1.2 节的分位数纪律同样适用于优化验证;
- 复盘停在根因不查门禁:同样的案子每季度重演一次,因为没人问"为什么门禁没拦住";
- 监控只建不审:告警半年没人理的指标要么修要么删,僵尸告警在真正的事故里稀释信号;
- 性能是"别人家的事":没有预算分解,性能责任无法落到具体服务,最后变成全局僵局。
本节要点回顾
- 预算先行:延迟按链路分解、资源配额显式化,取舍成为看得见的决策;
- 门禁拦回归:CI 基准对比 + sanitizer 轮巡,问题在合并前暴露;
- 观测常态化:持续剖析 + 版本标签,异常第一反应是查最近发布;
- 复盘四要素:时间线、证据链、因果句、门禁失效分析——最后一项最常缺席也最有价值;
- 制度优于英雄:闭环转起来,性能才可持续。
延伸:性能回归门禁的 CI 形态
清单里最值钱的一条是把"防复发"做成 CI 门禁:每次合并跑固定负载基准,关键指标劣化超过阈值即阻断。要点是固定环境与统计判据,否则门禁会因噪声误伤而被迫下线:
# .github/workflows/perf-gate.yaml 核心片段 - run: taskset -c 2 ./bench --case checkout --seed 42 | tee r.txt - run: | p99=$(grep p99 r.txt | awk '{print $2}') base=$(cat .perf-baseline/p99) python -c "import sys; sys.exit(0 if $p99 < $base*1.05 else 1)" \ || { echo "P99 回归 >5%: $p99 vs $base"; exit 1; }
基线文件由维护者定期刷新,抖动大的指标(p99)可用多次运行的中位数判据。门禁上线头一个月务必收集误报率,超过 10% 就先修测量环境,不达标的环境养不出可信门禁。
延伸:结案清单的分层复用
本节清单按使用者分三层:值班层(保全现场脚本、USE 一页单、决策树海报)保最快速度立案;工程师层(预算表、CI 门禁、检测器常开规范)保修复质量与防复发;团队层(案卷归档、口径对齐表、容量斜率告警)保组织记忆。三层各自有明确的所有者与更新触发条件——值班层随工具升级更新、工程师层随架构评审更新、团队层随事故复盘更新。清单不是文档,是带 owner 的活系统;没有 owner 的清单在第三次误报后就会无人问津,这是性能工程清单化最常踩的坑。
最后给一个反直觉的提醒:清单要有裁剪机制。清单项随时间只增不减,最终会长到无人执行——每季度审计一次,把过去半年从未触发、且触发也不改变行动的条目移入"归档区",保留条目都要能回答"这条在最近哪起案件里起过作用"。清单的生命力在于每一条都被信任,而不在于条数多少。结案清单的终极形态不是最全的清单,而是团队真的在用、且每次事故后都在进化的那份清单。
清单与告警的关系也值得一并理顺:告警是"清单的自动执行者",每条告警都应能追溯到清单的某一条——防复发检查项落地成了阈值,容量斜率检查项落地成了预测告警。反向审计同样成立:告警列表里找不到清单出处的那条,多半是某人临时的直觉产物,要么给它找到清单依据,要么删掉。这种双向对账能让告警系统与性能清单同频进化,避免两者各自膨胀成互不相认的两堆配置——那正是多数团队性能治理退化的起点。