1.3 事件驱动凭什么省电:一笔脉冲稀疏账
1.3 事件驱动凭什么省电:一笔脉冲稀疏账
本节摘要:事件驱动省电不是玄学,是三个机制叠加的可计算账:只算有事件的部分(稀疏性,通常省 1 到 2 个数量级)、只跟相关单元通信(局部性,省路由能耗)、没有全局时钟空转(消灭同步开销)。本节把每一项单独算一遍,再给出这套账在什么条件下会失效——这是判断"省电宣传"真伪的过滤器。
确诊了墙、看完了病史,本章最后一节回答一个最容易被宣传污染的问题:事件驱动到底凭什么省电。我们把"省电"拆成三个独立机制逐笔核算,你会发现每一项都可以从你自己的负载数据里估出来——这就是本节给你的、可迁移的判断工具。
机制一:稀疏性——不为零付电费
帧驱动计算的节拍是这样的:每隔一段固定时间(相机 30 帧、雷达 10 赫兹、模型一个前向),把全部数据算一遍,哪怕画面里 99% 的像素和上一帧一模一样。事件驱动把逻辑倒了过来:每个计算单元只在"有变化"时被唤醒。变化率越低,省得越多。
这笔账可以用你自己的数据估。设一段 1920×1080、30 帧的视频,帧驱动每秒处理 6220 万像素;实测监控类场景里,相邻两帧间真正变化的像素常在 1% 到 5%。事件化之后每秒只需处理 60 万到 300 万个事件,计算量直接掉 1 到 2 个数量级。第 6 章的事件相机会把这个逻辑做到传感器层面,这里先把它当作通用账法记下:省电的第一来源不是器件更先进,是"没干活就不花钱"。
# 稀疏性账:监控视频场景的帧驱动 vs 事件驱动 W, H, FPS = 1920, 1080, 30 frame_pixels_per_sec = W * H * FPS # 62,208,000 for change_ratio in (0.05, 0.02, 0.01): events_per_sec = frame_pixels_per_sec * change_ratio saving = frame_pixels_per_sec / events_per_sec print(f"变化率 {change_ratio:.0%}: 事件 {events_per_sec/1e6:.2f}M/s, 计算量降低 {saving:.0f} 倍") # 变化率 5%: 事件 3.11M/s, 计算量降低 20 倍 # 变化率 2%: 事件 1.24M/s, 计算量降低 49 倍 # 变化率 1%: 事件 0.62M/s, 计算量降低 100 倍
机制二:局部性——路由只走一小段
稀疏性回答"算多少",局部性回答"传多远"。传统架构里,数据从内存到运算单元要过总线、过缓存、过片上网络,每一次搬运都有能耗和延迟。脉冲网络里,一个神经元发放后,事件只投递到它有权重连接的目标——物理上就是芯片里相邻或邻近的几个核。TrueNorth 的实测给出过参照:一个突触事件全流程(路由加突触运算加神经元更新)约 26 皮焦耳,其中纯粹的乘加只占小头,但因为传输范围被限制在片上局部,"搬运费"被压到了皮焦耳级,而不是 DRAM 的数百皮焦耳。
这里有一个容易被忽略的设计含义:局部性要求连接结构稀疏。全连接网络天生反局部性——每个神经元的脉冲要投递给所有目标,路由能耗随规模平方涨。所以第 3 章会看到,生物皮层的连接率其实只有百分之几,卷积网络的局部连接结构反而是"生物友好"的;把全连接模型硬映射到神经形态芯片,往往拿不到宣传的能效。
机制三:无时钟——消灭空转的底噪
同步数字电路的全部逻辑门跟着时钟节拍翻转,无论有没有有效数据。一个时钟树在大型芯片里的功耗可以占到两位数百分比,这是"什么都不算也耗电"的底噪。异步电路没有全局时钟,事件来了才沿数据通路翻转。对突发性、间歇性的真实世界信号(视觉、听觉、触觉都是),底噪占比可以非常高,消灭它的收益在低活动率场景尤其明显——这正是神经形态芯片的目标场景。
⚠️ 三个机制的前提与失效条件也要说清:负载本身高活动率(比如密集光流的连续场景)时,稀疏性收益消失,事件流的仲裁与路由反而成为开销;算法若需要全连接大矩阵,局部性收益消失;而异步电路的设计验证工具链远不如同步成熟,工程成本会转嫁到开发周期上。谁在宣传里隐藏了这三个前提,谁就是在卖魔法。
图:帧驱动与事件驱动的能耗结构对比
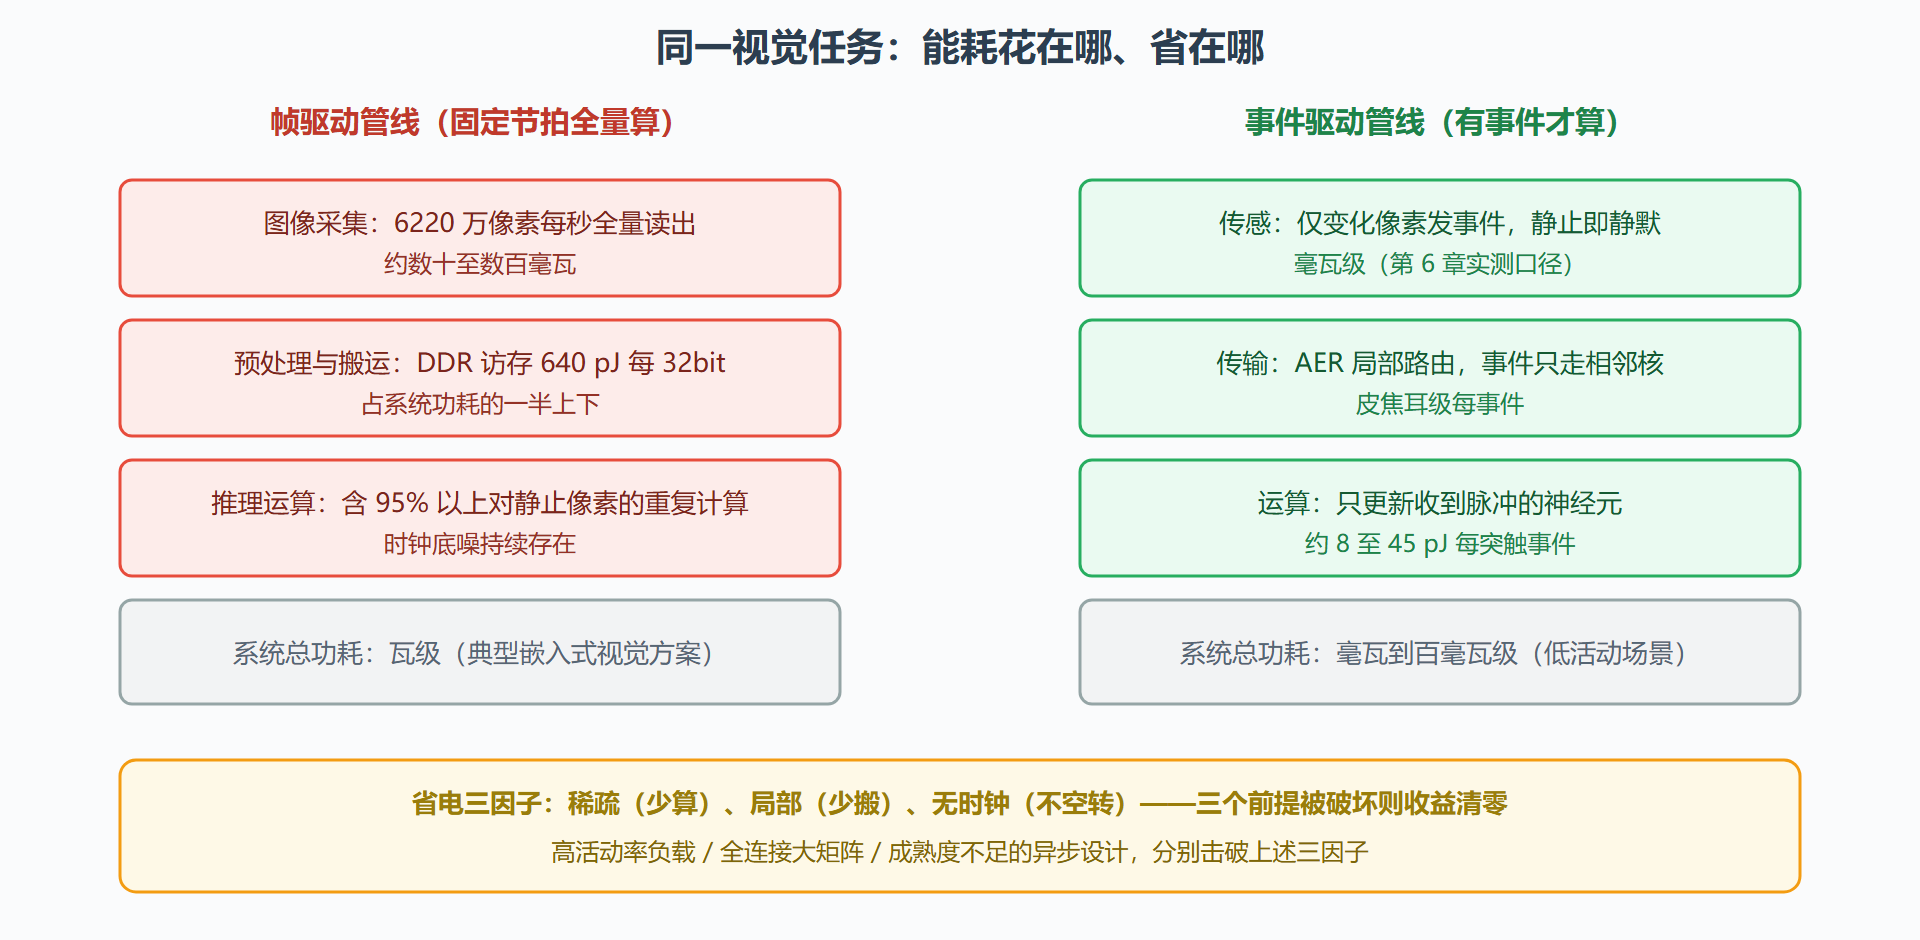
图上两条管线逐层对齐着看:每一层省下的能量都对应本节的一个机制,而不是某项黑科技。把这张图和 1.1 的 640 对 1 的账放在一起,你就拿到了完整的问题链第一环的答案:墙由搬运砌成,绕墙的钥匙是让"计算的发生"服从"事件的发生"。
把三个机制合起来估算一个端到端的例子,你能看到它们不是简单相加而是相乘。假设一条 always-on 的智能门铃链路:传统帧方案为"每秒 30 帧采集加每帧一次轻量推理",按每帧 5 毫焦耳计,日均功耗约 1.7 瓦时;事件方案里像素只在有人经过时发事件(日均活动约 1%),传感器底耗数十微瓦、事件处理毫瓦级、主芯片 99% 时间休眠,日均功耗压到毫瓦时的百分之几。三个机制各自贡献:稀疏性把计算量砍掉百倍,局部性让每次计算的能耗只算片上那一小圈,无时钟让休眠真正等于零——乘起来就是数量级的差距。反过来说,任何一条被打折(比如高活动率的商业街门口),最终收益就按那一条的折损比例缩水。
还有一个常被问到的对照值得写清:GPU 的稀疏计算(剪枝、稀疏张量核)不也是"只算非零"吗?是的,但两者省的层次不同。GPU 稀疏省的是"乘加"那部分能耗,数据仍然要搬进运算单元——搬运税一分不少;事件驱动省的是"这次计算根本不发生",连搬运带运算带时钟一起免掉。这就是为什么 GPU 上跑稀疏网络能省一半算不错了,而事件系统在低活动场景省出两个数量级并不稀奇。
亲手把三个机制量出来
给你的工作场景设计一个 30 分钟的"机制测量"练习,把抽象的因子变成你自己的数据。第一步测活动率:对你的目标场景连续采集十分钟(帧视频即可),用帧差法统计每秒发生显著变化的像素占比,画出活动率的时间分布——你通常会看到长尾形状,大部分时间活动率远低于均值。第二步测可容忍延迟:写下你的任务从"事件发生"到"必须响应"的真实时限,除以数据到达周期,得到你其实只需要多密的采样。第三步算机制收益:用 1.3 的三因子公式,把测得的活动率代入,得到省电预期区间。做完这三步,你的场景"在不在甜区"就不再是争论,而是测量。第 7 章的真实案例会反复验证这套测量的预测力。
事件驱动省电的本质,是把计算的能源支出从"按时间计费"改成"按事件计费"。负载的事件率有多低,你能省的就有多狠;负载变了,账就重算。
下一章我们进入问题链第二环:既然只有事件才值得计算,信息本身该怎么表示成脉冲——这就引出脉冲神经网络的计算观。