5.7 部署环境:从 Lava 到 NxSDK 的开发实录
5.7 部署环境:从 Lava 到 NxSDK 的开发实录
本节摘要:真芯片上的开发与仿真器有三点体验差异:资源是硬约束(核数、突触容量、路由表大小直接报错而不是变慢)、调试靠脉冲级遥测而非断点、迭代周期以编译分钟数计。本节以 Loihi 系的 Lava 与早期 NxSDK 为例走一遍部署流程,给出从"能跑"到"跑好"的排错清单。
仿真器里一切顺利的网络,到了真芯片会先撞上三面墙:资源墙(你的网络比芯片大)、观测墙(不能在芯片里打断点)、节奏墙(每次编译映射要数分钟,试错成本陡增)。本节按一次真实部署的时间顺序走一遍,把三面墙的绕行经验固化成清单。
部署流程实录:从网络到上板
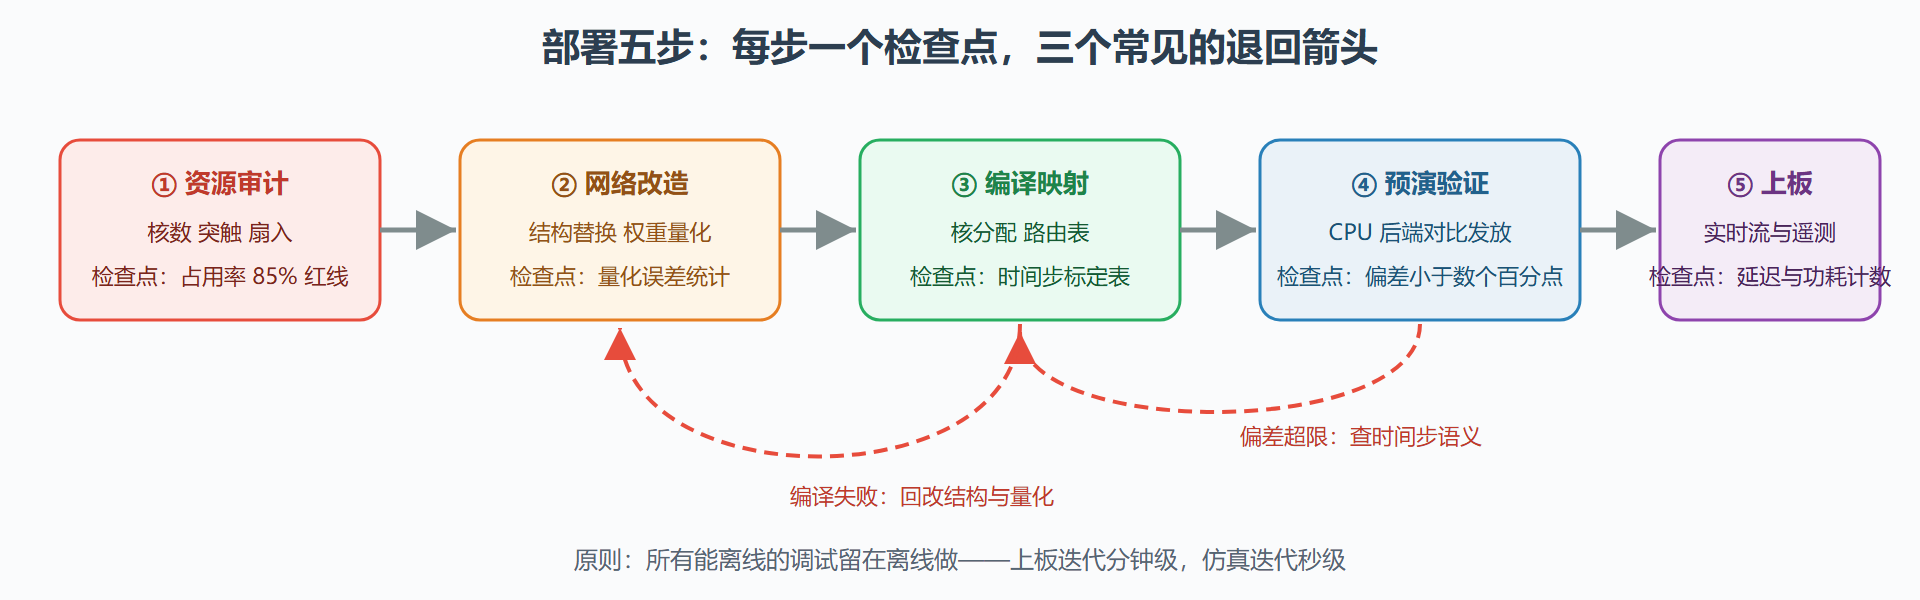
以 Loihi 系为参照,一次完整部署分五步。第一步是资源审计:数清楚网络的神经元总数、每神经元突触扇入、权重精度,对照目标配置(单芯 120 核、每核 8192 神经元上限、突触存储容量)估算核数占用——这一步 10 分钟,能省后面 10 小时。第二步是网络改造:把不支持的结构替换成可映射形式(见 5.5 节断点一),权重按目标口径量化。第三步是编译映射:生成核分配与路由表,这一步的输出里有一份资源报告,要看三处——核占用率(超过 85% 就要警惕路由拥塞)、最大扇出(超出会被拆分,引入额外延迟)、时间步标定(膜时间常数换算)。第四步是预演验证:先用 Lava 的 CPU 后端跑同样输入,对比真芯片的发放统计(各层发放率、输出分布),偏差超过几个百分点就停下来查时间步语义。第五步才是上板实测:跑实时输入流,看端到端延迟与功耗计数。
# 部署前的资源审计脚本:三分钟预估你的网络能不能装进单芯 def audit(neurons_per_layer, fanin_per_neuron, weight_bits=8, core_neuron_cap=8192, core_synapse_cap=131072): total_neurons = sum(neurons_per_layer) total_synapses = sum(n * f for n, f in zip(neurons_per_layer, fanin_per_neuron)) min_cores_neuron = -(-total_neurons // core_neuron_cap) # 向上取整 min_cores_synapse = -(-total_synapses // core_synapse_cap) cores_needed = max(min_cores_neuron, min_cores_synapse) print(f"神经元 {total_neurons}, 突触 {total_synapses}, 估算 {cores_needed} 核") print("单芯片可行" if cores_needed <= 120 else "需要多芯片或裁剪网络") return cores_needed # 例:三层网络 5 万神经元,平均扇入 64 audit([784, 32768, 16384], [64, 64, 64]) # 输出:约 8 至 16 核量级,单芯片余量充足 # 若扇入放大到 512,突触存储先于神经元数触顶——审计的价值就在暴露这种失衡
调试:换一种世界观
真芯片调试没有断点,只有遥测。Loihi 类平台提供三类探针:发放探针(每个神经元是否发放、何时发放)、状态探针(膜电位的采样序列,注意采样本身占用带宽,别全开)、能耗计数(按核统计)。有效的调试流程是"分层二分":先只开输出层探针看结论对不对,不对则回退一层看特征发放分布是否健康(健康 = 稀疏、类别间有区分度),逐层回退到第一处异常。多数问题的嫌疑排序是:时间步标定错误 > 权重量化截断 > 输入编码口径不一 > 学习规则参数越界。
节奏墙的绕法是把试错前移:编译映射前先用映射工具的"干跑"模式检查资源与结构合法性,把能在 CPU 后端发现的问题全都在仿真里解决。一个经验值:上板阶段每一轮迭代分钟级,仿真阶段秒级——同样的调试轮数,成本差两个数量级,把迭代次数压在仿真阶段是部署工程师的第一生产力。
图:从仿真到上板的五步部署通道与检查点
NxSDK 到 Lava:一次生态交接的启示
Loihi 一代时代的 NxSDK 是闭源专用工具,只运行在受限环境里,社区积累的代码难以复用;二代转向开源的 Lava 后,CPU/GPU/硬件三后端统一接口,第三方可以写自己的进程模型。这个交接对学习者的启示在于:给这类早期平台写代码时,把"业务逻辑"和"平台绑定代码"严格分层——网络定义、编码方案、评估逻辑全部写成平台无关的纯函数,只在最薄的适配层接触 SDK。将来平台换血(这事在这个领域五年一遇),你只需要重写适配层。
💡 上板排错清单,按命中率排序:时间常数未按芯片时钟重标定(先查这个);权重在量化截断后丢失小权重突触(检查绝对值小于一个最小刻度的边);输入率码的窗长与芯片时间步不匹配;脉冲扇出超限被静默拆分;探针开太多挤占了路由带宽,改变了网络自身的时序。
温度、老化与一致性这三类"环境现实"在仿真器里完全缺席,上板后却真实存在。温度漂移影响模拟前端的阈值行为——事件相机的等效阈值随温度变化,长期部署要设计周期性重标定;老化影响忆阻器类器件的电导分布(5.3 节),数字 SRAM 方案没有此虞但也要关注 SRAM 的软错误率;一致性问题指"同一网络在两块板上的行为差异"——量产交付时客户问"为什么两台设备表现不一样",你的部署日志与标定流程就是答案。这些内容不会出现在任何论文里,但决定了试点能否转量产,写进部署检查表。
最后给一条团队协作层面的建议:部署阶段的排错需要"算法-工具-硬件"三方语言互通,建议在项目第一天就约定一份共享词汇表(时间步、发放率、膜电位刻度、权重整定量纲),每次对账按词汇表说话。听起来繁琐,但它消除的是三方各自解读带来的最浪费的会议时间。
一个真实的"从仿真到上板"的时间分布也能帮你校准预期。以一个中等规模项目(十万神经元级、三层网络)为例:资源审计与网络改造合计约一周,编译映射与干跑检查一到两天,仿真与芯片的行为对账(第四步)往往最花时间——两周上下,因为时间步语义与量化误差的排查要迭代数轮;真正上板实测反而只要几天。也就是说,"上板"在整条时间线里是小头,前四步是大头——项目计划里把八成工时留给上板之前,是新手计划最常见的纠偏项。
部署的真功夫不是让网络跑起来,而是让它在芯片口径下依然是你训练时的那个网络。资源审计、口径对账、遥测二分,三件套缺一不可。
下一节展开五步里最技术的一步:编译映射的放置与路由,到底是怎样的约束求解问题。