5.8 编译与映射:资源约束下的放置问题
5.8 编译与映射:资源约束下的放置问题
本节摘要:映射是把一张网络图塞进一颗芯 tiled 结构的约束求解:每个核的神经元容量有限、突触存储有限、路由表条目有限,还要让通信就近。本节拆解四步流程——切分、放置、路由、时序验证——并用一笔核数与拥塞的估算说明为什么"剪枝先于映射"。
5.7 的五步通道里,第三步编译映射是技术含量最高的一步,值得单独一节。它解决的问题是:给定网络图(神经元为点、突触为边)和芯片资源模型(核容量、存储上限、互连拓扑),求一个分配方案,让所有约束满足且通信开销最小。这本质上是一个带多个容量约束的图划分问题——NP 难,工程上靠启发式。
四步流程:切分、放置、路由、验证
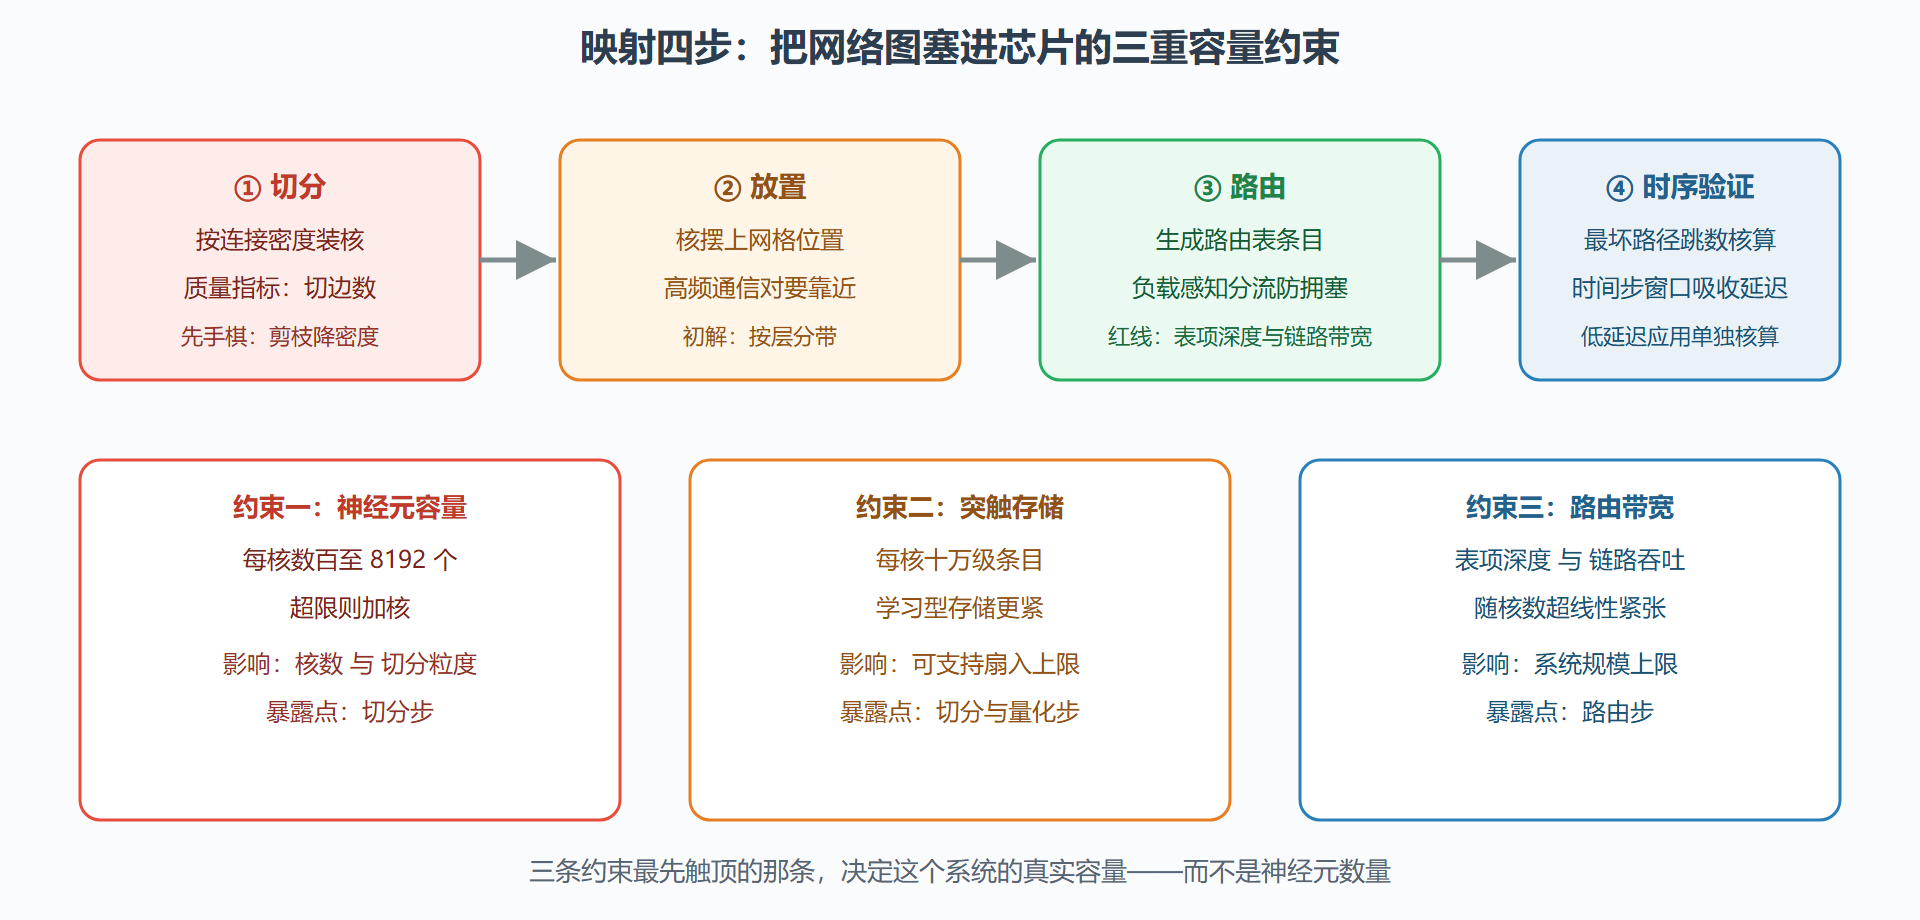
第一步切分:把神经元分组装核。贪心策略按连接密度聚类——联系紧密的神经元进同一核,因为核内通信免费、核间通信要过路由。切分的质量指标是"切边数":跨核突触越少,后面路由压力越小。这一步最有效的先手棋仍然是剪枝:把网络稀疏到百分之几的连接率(3.3 节生物连接率的量级),切分器的工作难度立刻降一个量级。
第二步放置:把核摆到芯片网格的物理位置上,目标是高通信量的核对彼此靠近。常用层次化方法或模拟退火;对流水线型的前馈网络,按层分带放置(第 0 层靠输入边缘,逐层向输出方向铺开)通常就是不错的初解。
第三步路由:为每条跨核突触生成路由表条目。mesh 拓扑下按最短路径走,但共享链路的流量叠加会拥塞——一条被几百个连接共用的链路,每帧要转发几十万个脉冲包,成为瓶颈。工程对策是负载感知路由:把热门链路分流到平行路径,宁可绕远也要摊平流量。TrueNorth 的架构里路由表深度是硬性资源,Loihi 的可编程路由同样有表项上限——路由失败的网络,要么重新切分,要么降扇出。
第四步时序验证:映射不是放完就结束,还要检查脉冲在多跳链路上的累积延迟是否破坏网络语义。多数架构用"时间步同步"吸收这种延迟(所有脉冲在一个时间步窗口内到达都算同步),但窗口收紧的低延迟应用要单独核算最坏路径跳数。
# 切分质量估算:切边数与路由拥塞的账 def estimate_mapping(n_neurons_total, conn_density, fanout_mean, core_neuron_cap=8192): n_cores = -(-n_neurons_total // core_neuron_cap) # 需要的核数 total_edges = n_neurons_total * conn_density * n_neurons_total edge_cut_ratio = 1.0 / (n_cores ** 0.5) # 网格切分经验估计 cut_edges = total_edges * edge_cut_ratio # 每条切边产生一个跨核包路径;平均跳数按网格边长估计 avg_hops = 2 * (n_cores ** 0.5) / 3 routed_packets_per_step = cut_edges * fanout_mean * avg_hops / n_cores print(f"核数 {n_cores}, 总边 {total_edges:.2e}, 切边 {cut_edges:.2e}") print(f"每时间步每核平均转发包数: {routed_packets_per_step:.0f}") return routed_packets_per_step # 10 万神经元、密度 1%、平均扇出 8 的网络 estimate_mapping(100_000, 0.01, 8) # 输出显示:核间转发量随核数超线性增长——网络越大,路由越是第一瓶颈 # 对策排序:先剪枝降 conn_density,再扇出共享(轴突式广播),最后才换更大芯片
这段估算透露一个工程规律:核间路由压力的增长快于网络规模本身,所以"芯片越大越好"的直觉在稀疏脉冲系统里经常失灵——规划系统的可用规模上限时,路由吞吐比神经元容量更早触顶。
图:映射四步流程与资源约束对照
从映射视角回看算法选择
站在映射的角度回看第 4 章会发现新的取舍维度:替代梯度训练出的网络结构是"给 GPU 顺手"的(密集卷积、大扇出),映射到稀疏架构前必须剪枝重组;而 STDP 网络天然稀疏、扇出温和,映射几乎无损。这解释了一个此前没点破的现象:片上学习路线的论文里网络都很小,不只是训练难,映射友好同样是原因。算法与映射的联合设计(训练时就把核容量当正则项)是这个方向的活跃研究点,也值得你在冷启动时留意(第 8 章)。
映射工具的输出报告有一套通用的"健康体检项",部署前逐项过一遍能拦住大部分事故。第一项,核占用热图:理想状态是占用均匀,出现"满核与空核相邻"说明切分器被连接结构逼进了角落,通常意味着网络局部过密,需要局部剪枝。第二项,路由表饱和度:任何一条链路超过七成容量就要警惕突发事件的拥塞丢包。第三项,最坏路径跳数:决定脉冲穿越全网的延迟上界,闭环系统的预算要按这个数留。第四项,切边统计:切边数异常偏高的网络意味着连接结构没有空间局部性,回到算法侧重新设计比在映射侧硬解更划算。第五项,量化残差:权重映射到硬件刻度后的误差直方图,长尾的那几个权重往往对应关键的分类边界。
这套体检的价值在于"免费"——映射工具跑完这些统计几乎零成本,而跳过它直接上板,同类问题要等数小时的上板调试才暴露。把体检清单做成 CI 脚本的一部分,是团队从"能部署"走向"工程化部署"的标志。
映射问题的另一面是"映射友好"的网络设计——与其事后解难题,不如在算法侧就长成好映射的样子。四条设计守则:连接尽量空间局部(卷积式结构天然友好,全连接尽量靠后放小层);扇出有上限意识(超过路由表深度的大扇出要在算法侧用广播树显式组织);稀疏度目标前置(训练时加幅度衰减或发放率正则,让剪枝后精度损失可控);按核容量分层(让每层神经元数是核容量的整数倍附近,切分器不拆层)。守则的共同精神是:把映射从"编译时的求解问题"变成"训练时的结构属性"——这与第 4 章讲的联合设计是同一件事的两个侧面。
映射是把"网络"翻译成"占用"的编译过程:三条容量约束互相牵制,最先触顶的那条决定真实容量。工程师的顺序应该是剪枝、估核、算路由,最后才谈芯片型号。
至此第 5 章的硬件与工具链完整闭环。第 6 章转入问题链的下一环:当传感器本身开始发脉冲,感知与计算的边界会怎样消融。