7.2 机器人与无人系统:低延迟控制闭环
7.2 机器人与无人系统:低延迟控制闭环
本节摘要:机器人把约束从"省"换成了"快":避障闭环要求感知到执行的端到端延迟压进几十毫秒,动态环境的适应又要求在线学习。事件相机加脉冲网络的组合在高速避障、四旋翼机动、机械臂反应控制上给出了实测案例,本节逐一拆解它们的系统配置与失败边界。
7.1 的判据是"省不省",本节的判据是"快不快、适应不适应"。控制闭环的延迟预算可以这样拆:以无人机 10 米每秒飞行、需要提前 1 米避障为例,整条链路(感知、决策、执行)只有 100 毫秒;传统"相机曝光 15 毫秒 + 传输 10 毫秒 + CNN 推理 20 毫秒 + 控制解算"已经紧绷,运动模糊还会在高速下进一步劣化感知质量。事件相机在这里给出结构性解法:无曝光概念、微秒级事件、高速不模糊,感知端延迟从帧周期量级压到毫秒级。
案例一:四旋翼全自主避障(苏黎世大学 UZH 系列)
UZH 机器人与感知组的系列工作是最有代表性的公开案例:掌上四旋翼完全依靠事件相机做全向避障,机载计算用小型处理器甚至神经形态芯片完成。系统配置的关键点有三个。感知端用事件相机的角速度与深度线索,直接从事件流估计障碍物接近速度(不做完整图像重建——3.3 节说的"谁在说话"逻辑:只有障碍物边缘在发事件)。决策端是一颗小型脉冲网络,输出转向指令,TTFS 式读出保证"最危险的方向先发言"(2.2 节首达时间的工程兑现)。整体闭环延迟比帧基方案低一个量级,为控制留出了充足余量。这个案例的通用启示:事件流方案的正确打开方式是"不重建、直接从事件推理"——凡是先重建图像再跑 CNN 的路线,都把事件相机最值钱的延迟优势磨掉了。
案例二:片上学习的机器人步态适应
第 4 章说替代梯度训练和 STDP 片上微调可以混合,最有说服力的验证在机器人上。Loihi 一代时代英特尔与合作的实验室做过四足机器人步态适应实验:控制器网络的一部分在片上用局部规则在线调整,机器人从平整地面走到松软地毯时,步态参数在几秒内自适应收敛——这类演示展示了"部署后仍能学"的差异化价值,这是纯推理架构(无论 GPU 还是量化 NPU)给不了的。代价同样要记录:可学习的任务范围有限(参数少、目标简单的适应),离"学一个新的复杂技能"还有数量级的距离。
案例三:机械臂的反应式抓取
工业分拣里的高速拣选要求视觉触发到运动指令 30 毫秒以内。事件相机的应用方式:传送带上的物体边缘持续产生事件流,SNN 做存在性判断与粗分类,输出直接驱动运动规划的触发条件。与传统方案的对比实验里,事件方案在"物体被遮挡后重新出现"与"高速到料"两类工况下优势最大——因为事件流没有"错过帧"的概念,信息是连续的。局限工况也要如实记录:需要精确位姿估计时(抓取六自由度定位),事件流仍要配合帧相机或结构光,纯事件方案当前到不了工位级精度。
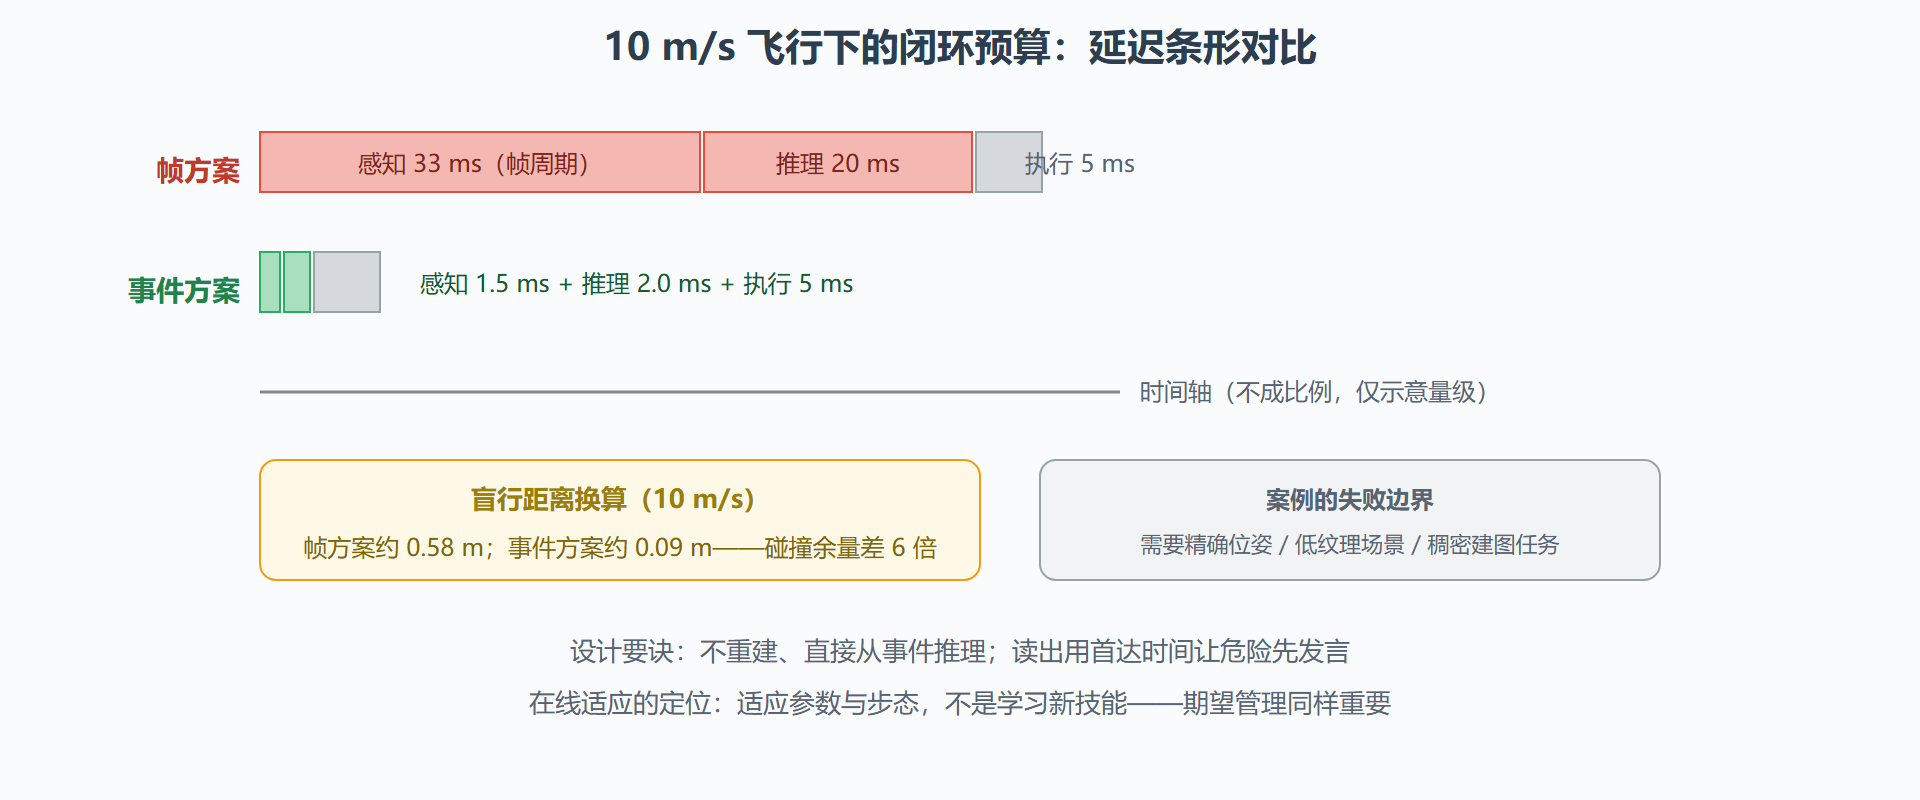
# 避障闭环的延迟预算模型:帧方案 vs 事件方案 def loop_latency(perception_ms, inference_ms, actuation_ms): total = perception_ms + inference_ms + actuation_ms return total frame_pipe = loop_latency(perception_ms=33, # 30fps 帧周期 + 曝光 inference_ms=20, # CNN 前向(嵌入式级) actuation_ms=5) # 控制解算与执行接口 event_pipe = loop_latency(perception_ms=1.5, # 事件生成与滤波 inference_ms=2.0, # 小型 SNN(TTFS 读出可提前终止) actuation_ms=5) print(f"帧方案闭环: {frame_pipe} ms") print(f"事件方案闭环: {event_pipe} ms") # 58 ms 对 8.5 ms:同等执行端下,感知加决策延迟差约 7 倍 # 按 10 m/s 飞行换算:帧方案的"最坏盲行距离"约 0.58 m,事件方案约 0.09 m
图:避障闭环的延迟分解对比——盲行距离的差距
机器人路线的选型结论
三个案例合并成一张决策图:任务需要高速闭环且目标检测粒度是"存在与方向"——事件方案成立;任务需要稠密感知或精确位姿——事件做触发层、帧/激光做测量层的混合架构更现实;任务环境动态多变且误差代价高(人机协作)——值得为片上学习支付的溢价评估一下,但要把学习目标限定在参数适应级别。机器人是神经形态计算最能展示"结构性优势"(不是快一点,是曲线形状不同)的战场,也是最容易因为过度承诺翻车的战场——汇报延迟数字时永远带上工况,这是本节的最后一课。
把三个案例的工具链形态也交代一下,准备复现的读者可以直接对号。避障类研究的标准起点是事件相机的公开数据集(驾驶场景的 DSEC、室内飞行的现成序列)加模拟闭环环境;UZH 系列的部分工作公开了飞行平台与传感器配置,感知算法的论文附带了事件流处理的实现细节。片上学习类实验的平台是 Loihi 系(通过研究合作计划获取云访问),控制对象可以先用仿真机器人(开源物理仿真器)搭闭环,验证规则有效后再上真机——这个"仿真闭环先行"的次序能把真机实验的次数压缩一个量级,安全预算紧张的团队尤其要守。工业分拣类项目则建议先做"影子模式"试点:事件系统与现有系统并行跑、只记录不执行,攒够数周的对比数据再切换控制权——制造业对这条流程的熟悉度远高于算法团队,双方按制造业的验证节奏走,落地阻力最小。
风险清单也值得单列:事件相机的强光与频闪环境(LED 灯的高频闪烁会产生大量伪事件)、机械振动的传感器自激(把机身振动误判为场景运动)、多机互相干扰(对方机身上的纹理在自己的事件流里形成噪声源)。这三条在实验室里都不出现,一进真实场地全冒出来——机器人项目的"最后一公里"成本,几乎全部花在这类环境适配问题上。
机器人战场的公式:结构性延迟优势来自"不重建直接推理",结构性适应优势来自"片上局部规则"。两个优势都有明确的失效边界,画出来比算出来更重要。
下一节去最远的战线:亿级神经元的科学仿真——那里追求的既不是省也不是快,而是"对"。