7.3 大规模仿真:从皮层柱到 Hala Point
7.3 大规模仿真:从皮层柱到 Hala Point
本节摘要:大规模神经形态系统的第一用户不是工业界而是神经科学:SpiNNaker 用百万 ARM 核实时仿真十亿级神经元,BrainScaleS 用模拟电路做千倍加速的皮层动力学,Hala Point 用 1152 颗 Loihi 2 连出 11.5 亿神经元。本节讲清三个平台的分工、几项标志性研究成果,以及科学仿真反过来如何喂养工程算法。
三条应用战线里,这一条离产品最远,却可能是战略价值最大的一条——因为它生产的是"对大脑计算原理的工程化理解",而这些理解正是前六章所有设计的源头。1.2 节说硬件的第一批用户总是神经科学家,本节解释这批用户到底在买什么。
SpiNNaker:用通用核买自由度
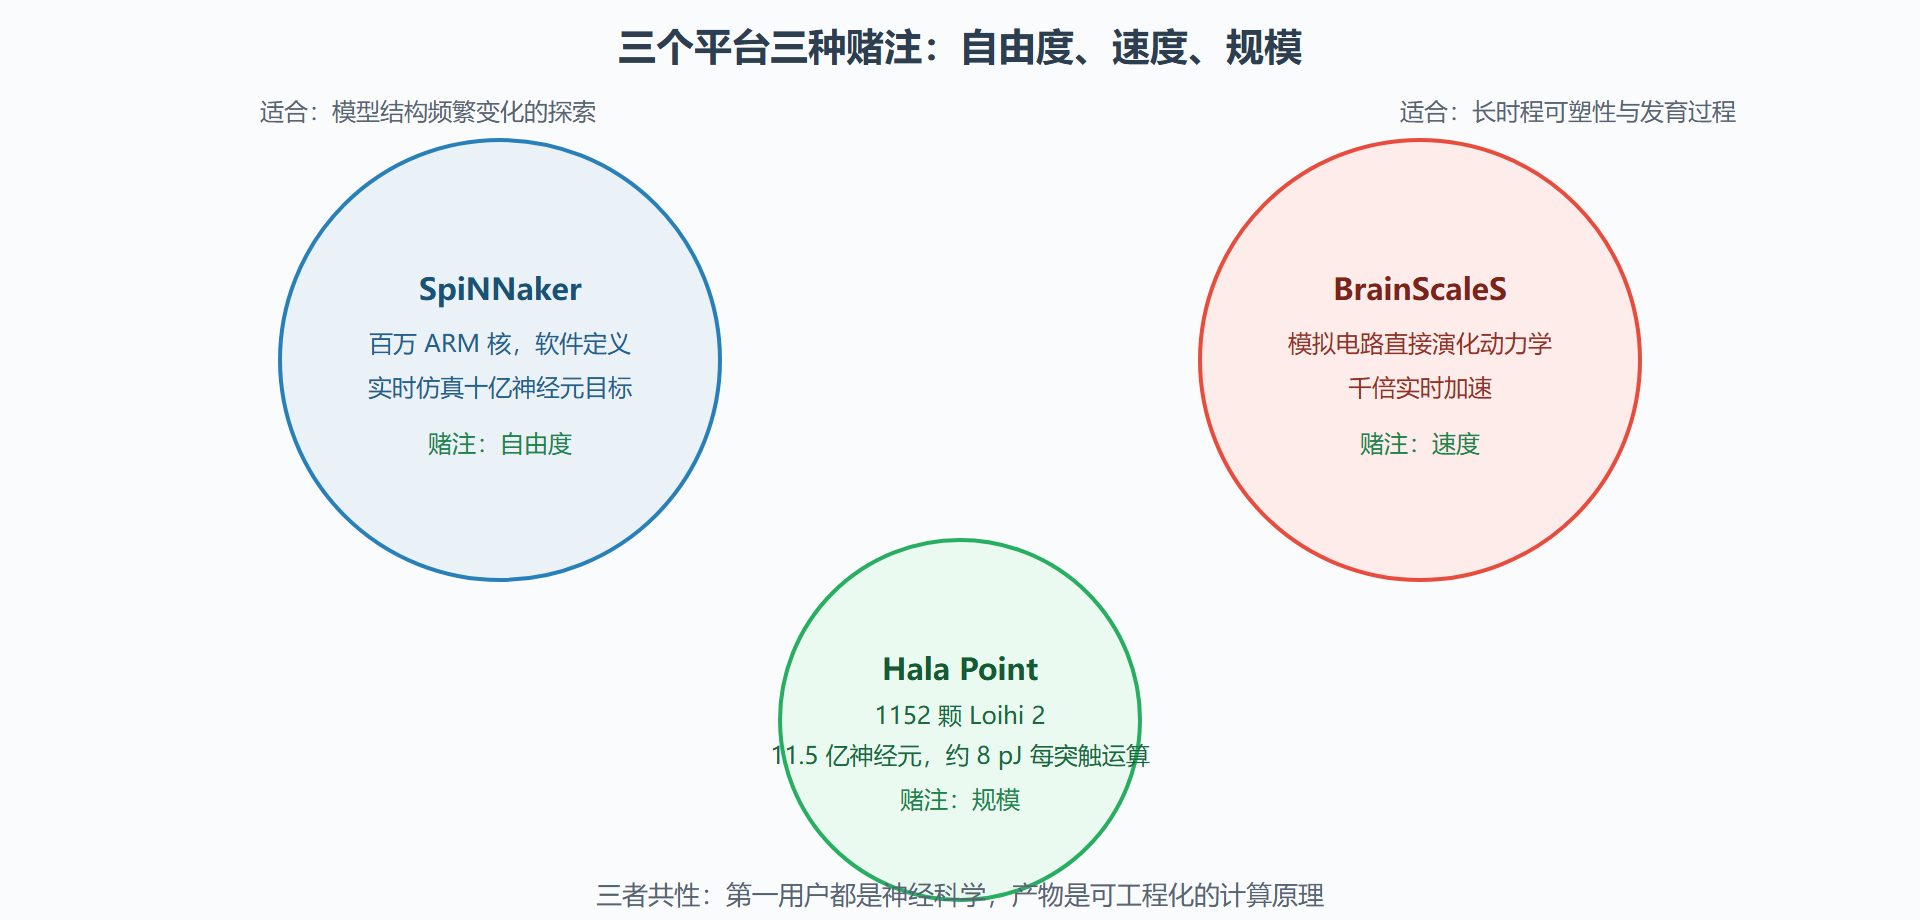
曼彻斯特的 SpiNNaker 一代是 2018 年完成装机的百万核机器:每芯片 18 个 ARM968 核,共约 100 万核,设计目标为实时仿真十亿神经元量级的点神经元网络。它的技术签名是"多播脉冲包"——一个发放事件按路由树扇出到所有目标核,通信协议专为脉冲的突发性设计。代表性成果包括蓝脑计划合作的皮层柱微电路仿真(复现万级神经元、千万级突触的皮层柱动力学)、大规模随机网络的活动传播研究等。二代(SpiNNaker2)改用更强的 ARM 核并加入针对突触状态更新的加速单元,在保持软件自由度的同时收窄与专用电路的能效差距。
适合它的问题特征:模型结构频繁变化(研究者今天换连接模式、明天换学习规则)、规模要求实时或超实时、精度要求可复现。不适合的:要极致能效的产品化场景——瓦级每芯的功耗在数据中心无妨,在纽扣电池里是灾难。
BrainScaleS:用物理动力学买速度
海德堡的 BrainScaleS 走的是相反的极端:模拟电路直接实现 AdEx 神经元与突触动力学,而且把时间常数缩短千倍——生物 20 毫秒的膜时间常数在硅上 20 微秒完成,整套系统跑得比生物快一千倍。这打开了一类独特实验:生物尺度上需要几小时的学习过程,20 秒看完结果。它适合的问题:长时程可塑性研究、网络级发育与自组织过程。代价在 5.3 节已经预演过:器件偏差需要逐芯片校准,模型保真度受模拟电路噪声限制。
Hala Point:从科学平台到"神经系统级"验证
2024 年公布的 Hala Point 是规模路线的最新节点:1152 颗 Loihi 2,11.5 亿神经元、约 1.2 万亿突触的部署规模,公布口径的突触运算能效约 8 皮焦耳,峰值吞吐百万亿级突触事件每秒。它的定位值得准确理解:这是神经形态计算的"国家级试验台",用来研究百亿参数级 SNN 的可扩展行为、脉冲域的大模型(时序连续学习方向)——不是卖给企业的产品,答案更像"神经形态领域的超级计算机"。
图:三大科学仿真平台的定位三角
科学仿真如何反向喂养工程
三个平台产出的不只是神经科学论文,还有直接回流到工程算法的成果。批一,结构先验:皮层柱仿真验证的连接模式(局部兴奋、远程抑制的比例结构)后来成为替代梯度网络的结构正则项;批二,学习规则的硬件预演:三因素规则、homeostasis 在 SpiNNaker 与 BrainScaleS 上先于商用芯片验证了参数区间,第 4 章 Loihi 学习引擎的设计直接受益;批三,稀疏与编码的实证:大规模仿真给出"多少稀疏度不损失任务性能"的经验曲线,5.8 节映射工具的默认稀疏假设来源于此。这条"科学到工程"的转化管道,是神经形态计算区别于纯产品驱动技术领域的结构性特征。
给工程师的实用建议:如果你的研究需要亿级神经元的动力学实验,三个平台的学术访问渠道都相对开放(人脑计划框架下的申请、Intel 研究合作计划),先用 PyNN 写一次模型、多平台跑,比绑定单一平台更保值。
给"要不要用大规模仿真平台"的决策一个具体的判断流程。第一问:你的问题需要实时性还是保真度?需要看生物时间尺度的动力学细节(通道、树突)—— BrainScaleS 类物理加速或桌面级高保真仿真器(第 5 章 Brian2、NEST)更合适;需要大规模点神经元网络的统计规律——SpiNNaker/Hala Point 一类平台才有意义。第二问:规模到哪一档?单柱(万级神经元)桌面机器够用;多区域(百万到千万级)需要集群版仿真器;全脑量级(十亿级)才轮到专用机器出场——多数研究问题其实停在第二档,用不上专用硬件,别为了"用大平台"而放大问题。第三问:产出是什么?论文级发现、算法先验还是工程原型?三者对平台的要求依次降低——算法先验用 PyNN 写好后任何平台都能验,工程原型更是应该直接在目标芯片的仿真后端做。
科研管理角度还有一个务实的提醒:大规模平台的实验周期以周计(排队、分配、跑批、分析),把实验设计做扎实再上平台是铁律——先在桌面级仿真器上把网络行为调到预期,再申请大规模运行验证规模效应。跳过前一步直接上大平台,是这类项目最常见的资源浪费。
这些平台产出的"认识"里,有三条对工程师特别值钱,值得点名。第一条:规模的相变行为——小网络上的学习规则放大到百万神经元级会出现新的集体现象(同步暴发、活性坍缩),稳定性机制必须重新标定,这条经验直接告诉大模型时代的工程师"逐层放大不等于线性外推"。第二条:稀疏编码的容错曲线——大规模仿真实证了网络在删掉一定比例神经元后性能的衰减斜率远好于稠密网络,这条曲线成了边缘部署里"剪枝容忍度"的理论参照。第三条:多时间尺度共存的设计价值——快通路做反射、慢通路做整合的双层结构在大规模仿真里反复验证了稳定性收益,机器人控制架构现在普遍吸收了这个模式。读大规模仿真成果时,盯着这类"可迁移的规律"读,比记录具体数字的收益高一个量级。
对想入场的学生与研究者,这条战线还有一个被低估的入场优势:门槛的多样性。不需要碰硬件也有位置——网络模型构建(PyNN/Python 技能即可)、数据分析(大规模仿真的产出是海量发放数据,处理它的技能与处理深度学习训练日志同源)、可视化与基准维护,都是真实需求。大规模平台的实验容量有限而排队常见,因此"把别人的仿真数据用出新结论"同样是被认可的产出形态——先从数据侧入场,再随兴趣靠近平台本身,是风险最低的路径。
科学仿真战线交易的是"理解"而不是"产品":SpiNNaker 买自由度,BrainScaleS 买速度,Hala Point 买规模。工程界读这些成果的方式,是把它们当作免费的前期研发。
下一节回到所有战线的公共环节:怎么评估——那套防止被"提升百倍"话术带走的清单。