3.5 SSA 的解构(De-SSA)
3.5 SSA 的解构(De-SSA)
本节摘要:SSA 的生命周期止于后端:真实机器没有 phi 指令,离开优化世界前必须把 SSA 还原成普通形式(out-of-SSA,俗称 De-SSA)。朴素做法是"每个 phi 摊开成前驱块末尾的拷贝指令",但关键边与并行语义会埋进两个经典陷阱——丢拷贝问题(lost copy)与交换问题(swap problem)。本节按"朴素方案→暴露问题→修复方案"的次序把 De-SSA 讲透,并说明它与下一章寄存器分配里拷贝合并(coalescing)的接力关系。读完你应当能手推一个小 CFG 的 De-SSA,并说清为什么不能在做完 SSA 后立刻"顺手"消灭拷贝。
本章从 3.2 起反复强调"phi 是纯 IR 概念"。本节兑现这句话的后果:phi 必须被翻译掉。翻译并不难,难在翻译时要守住 phi 的并行语义——所有 phi"同时"取值,而机器指令是串行的。
一、朴素方案:phi 摊成前驱里的拷贝
phi 的语义"从边 e 来则取参数 v_e"可以直接翻译:在前驱块 p 的末尾,把 v_e 拷进 phi 的目标名。这样 phi 指令本身删除,控制流到达汇合块时,目标名已经装好了正确的值:
变换前 变换后 B1: B1: x1 = 1 x1 = 1 goto B3 x3 = x1 ← B1 末尾插拷贝 B2: B2: x2 = 2 x2 = 2 goto B3 x3 = x2 ← B2 末尾插拷贝 B3: B3: x3 = phi(x1 from B1, use x3 x2 from B2)
单参数 phi(只有一个前驱的"汇合")同样翻译成一条拷贝。到这里一切顺利——因为例子太温顺了。下面两个反例才是 De-SSA 的真正考点。
二、陷阱一:关键边上的丢拷贝
若某条边是关键边(前驱有多个后继、后继有多个前驱),拷贝插在前驱末尾会沿"另一条不该走的边"泄漏过去。看这个形状:
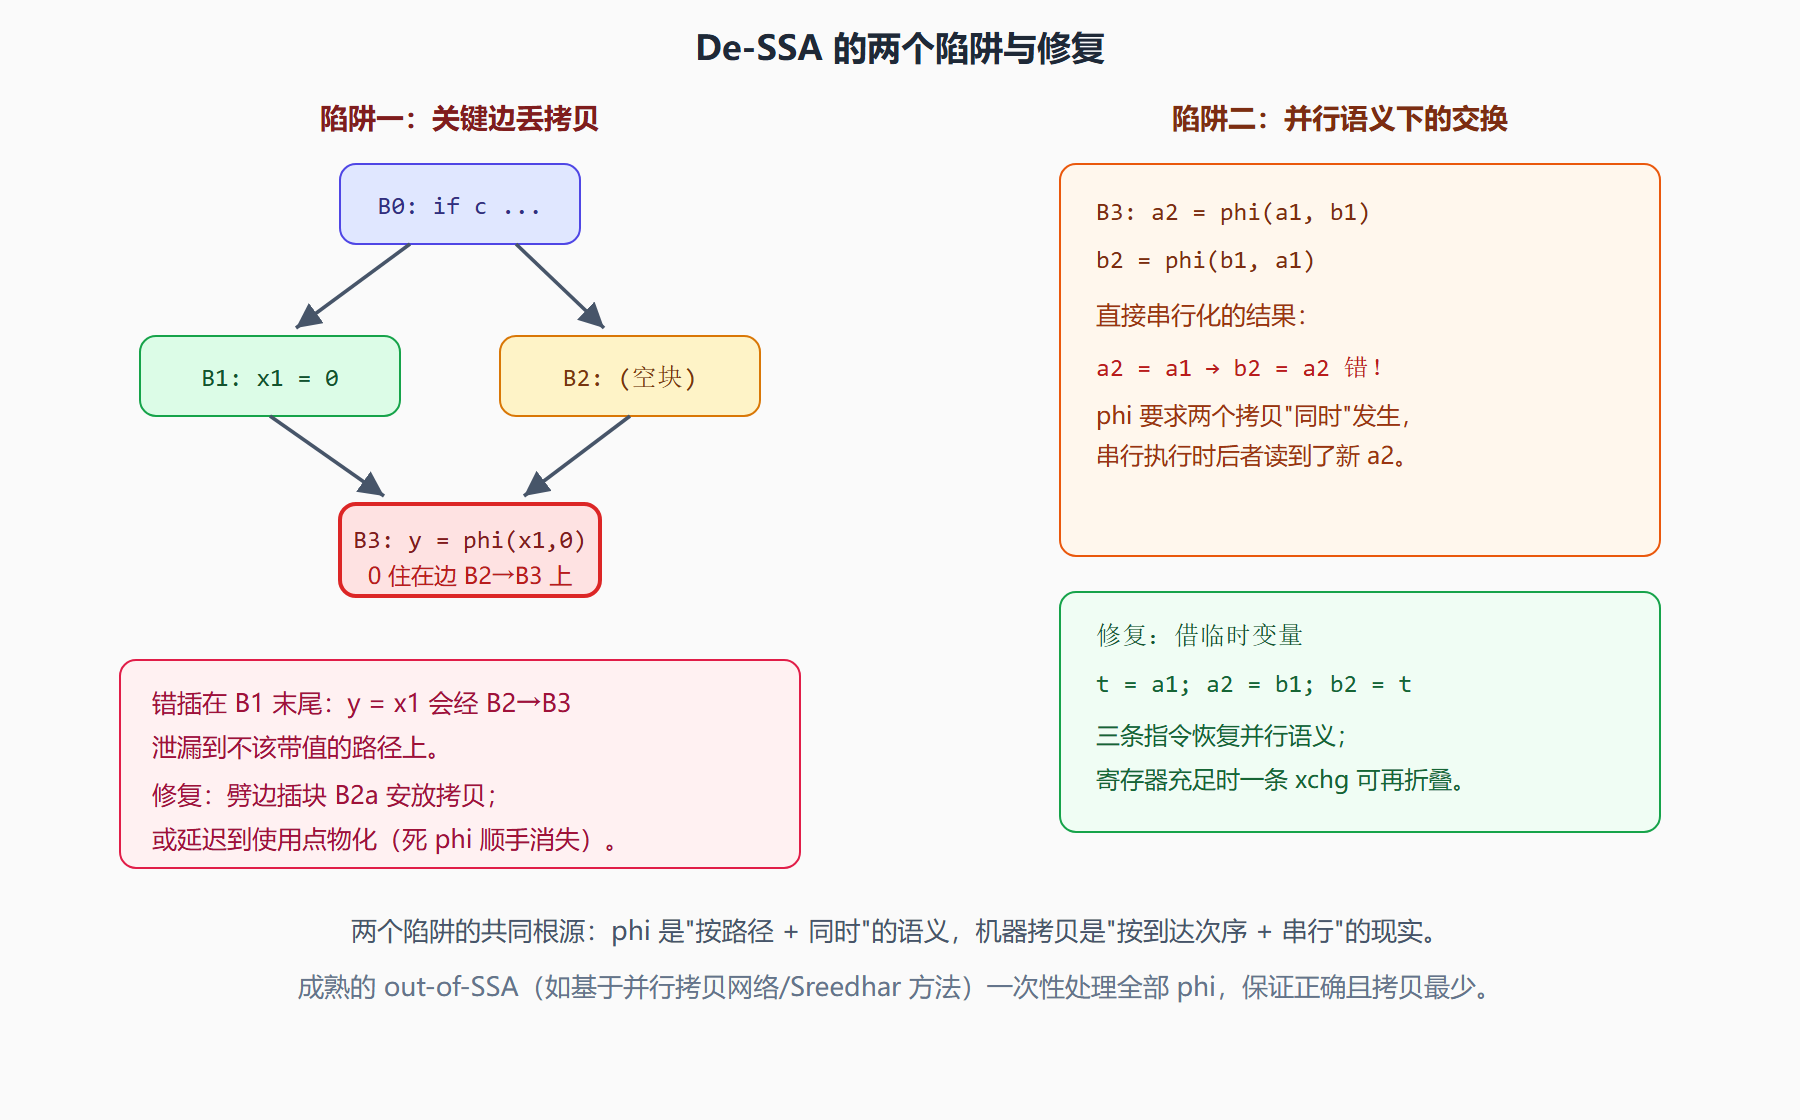
B0: if c goto B1 else goto B2 B0: if c goto B1 else goto B2 B1: x1 = 0 B1: x1 = 0 goto B3 goto B3 ← 错!x1=0 也流进了 B2: goto B3 B2: goto B3 B2→B3 这条路 B3: y = phi(x1 from B1, 0) B3: y = 0 或 0 语义被打错
phi(x1 from B1, 0) 的第二个参数是常量 0,它"住在边 B2→B3 上",可 B2 里根本没有指令可插。若把拷贝统一塞进 B1 末尾(x1 = 0 后再 y = x1),则从 B2 绕行时 y 也被写成 0——恰好这个例子里值相同侥幸无碍,把参数换成别的值立刻穿帮。
修复方式有两条路。其一是劈关键边:在 B2→B3 之间插一个空块 B2a,拷贝就有了安放点——3.3 已提过劈块,这里是它第二次出场。其二是更讲究的延迟物化:不急着在前驱插拷贝,而在 phi 结果首次被使用的地方再插;上例中若 y 在 B3 从未被使用,整个 phi 连同它的拷贝全部蒸发。延迟物化顺便完成了"死 phi 的零成本消除",这也是许多实现把它当作默认策略的原因。
图:两个经典陷阱——lost copy 与 swap problem
三、陷阱二:交换问题与并行拷贝网络
同一块里两个 phi 互换彼此的值时(经典的奇偶交换循环),朴素串行化会把第一条拷贝的新值喂给第二条——正确做法是引入临时变量破环:
// 循环里的双 phi 交换(比如就地旋转两个游标) // SSA: // a2 = phi(a1, b2) b2 = phi(b1, a2) // 互相引用,构成环 // 直接串行化 a2 = b2; b2 = a2 → 两个名字同值,交换丢失 // 借 t 破环: // t = a1; a2 = b1; b2 = t
一般化的解法是把一块内所有 phi 打包成并行拷贝,再用"寄存器分配感"的顺序化算法(检测拷贝环、按环分配临时)展开。拷贝环较大的场景(向量 shuffle、参数传递的 ABI 粘合)里,顺序化的质量直接影响多出多少条 mov。
四、与寄存器分配的接力:为什么拷贝不在此刻消灭
De-SSA 产生大量 x3 = x1 式拷贝,而寄存器分配天然讨厌拷贝(第6章的图着色会讲:把 x3 与 x1 分进同一个寄存器,拷贝即免费消除——这叫拷贝合并,coalescing)。一个自然的疑问是:既然如此,为什么不在 De-SSA 时顺手把拷贝全消掉?
因为合并是"寄存器压力与拷贝消除的联合权衡":激进合并会把干涉图上原本不相连的结点焊死在一起,可能把本来不溢出的分配逼成溢出。所以工程上的分工是:De-SSA 只负责把 phi 正确、尽量少地物化成拷贝;拷贝的生死留给寄存器分配阶段在看清干涉关系后裁决。这也是本章的收束点——SSA 世界(3.1–3.5)到此完整走完一轮"构造→优化→还原",第4章开始,我们带着这套表示去做真正的分析。
本节要点回顾:
- De-SSA 的本质:把"按路径同时取值"的 phi 降为"按到达次序串行执行"的拷贝;
- 丢拷贝问题:关键边上无处插拷贝,劈边或延迟物化修复;
- 交换问题:拷贝环需借临时变量破环,否则并行语义在串行化中丢失;
- 延迟物化:把物化推迟到使用点,死 phi 免费消失;
- 与寄存器分配的接力:拷贝合并是分配阶段的职权,De-SSA 不越俎代庖。
phi 退场之后,IR 上还剩下什么分析可做?下一章从数据流分析的通用框架讲起。
追问三则
问:De-SSA 之后还能回 SSA 吗? 能,而且常见。优化往往分阶段:先在 SSA 上跑标量优化,De-SSA 后做寄存器感知的变换,随后可能还要再回到 SSA 跑一轮(比如循环优化要求 SSA 的稀疏性)。来回换挡的可行性靠的是 3.3 的构造算法足够快——支配树近线性,重建一次不心疼。工程上"反复进出 SSA"是常态而非例外,这也解释了为什么现代编译器把 SSA 视为一种可随时重建的"视图",而不是一次性的中间产物。
问:phi 的参数是常量时怎么办? 翻译成"在前驱块里给目标名赋常量"即可,常量传播会做后续清理。上一节 3.4 的剪枝思想在这里再显身手:若常量参数所在路径上目标名从未被使用,延迟物化连这条赋值都省掉。
问:能不能干脆让硬件支持 phi? 学术界真试过(带谓词执行的架构把 phi 语义融进硬件条件写),谓词指令确实消掉了分支,但那是另一条技术路线的胜利——它消除的是分支开销,不是 phi 本身。对主流架构,De-SSA 依然是编译器的必修课:硬件没有为编译器的内部表示买单的义务,表示的先进性必须在离开编译器前兑换成普通指令。