3.4 SSA 的变体与扩展
3.4 SSA 的变体与扩展
本节摘要:标准 SSA 只给标量变量建"一次定义"的纪律,实践中围绕它长出了四个方向的变体:按 phi 稠密程度分档的最小/半剪枝/剪枝 SSA;把内存访问也纳入版本化的 Memory SSA;把控制条件写进数据流的门控 SSA(GSA)与 psi 形式;以及让每个使用点携带更多上下文的 SSI。本节逐个说清"标准形式在哪个具体场景不够用、变体补上了什么",并给出各自的代价。读完你应当能按优化需求挑选合适的 SSA 档位,而不是把 SSA 当成一个不可拆整的东西。
3.3 末尾埋了两个尾巴:剪枝 SSA 要先做活跃分析、内存变量还没进 SSA 的世界。本节把这些尾巴一个个接住——每个变体都从标准形式的一个具体短处生长出来,先看短处,再看补丁。
一、按 phi 稠密程度分档:三种"浓度"
同一份程序,三种档位生成的 phi 数量差别很大:
| 档位 | 置放依据 | phi 数量 | 前置分析 | 典型用途 |
|---|---|---|---|---|
| 最小 SSA(min) | 只按支配边界 | 最多 | 无 | 理论论述、教学 |
| 半剪枝 SSA(semi-pruned) | 仅对跨块活跃的变量 | 中等 | 局部活跃性 | 多数产品编译器 |
| 剪枝 SSA(pruned) | 定义点活跃才置放 | 最少 | 全局活跃变量分析 | 对 phi 敏感的后端 |
为什么会有"死 phi"?min SSA 在汇合点摆 phi 只看定义到达,不管这条路径上变量还有没有人用。if (c) x = f(); else x = g(); return 0; 里 x 的 phi 纯属摆设。phi 不是免费指令:后端把它物化成拷贝(3.5),每个多余 phi 都是白花的寄存器与带宽。剪枝的代价是一次全局活跃变量分析——第4章 4.2 会把这套分析做扎实,届时"剪枝"就只剩一个判断条件的功夫。
二、Memory SSA:给内存也发版本号
标准 SSA 管不住内存。*p = 1; ... y = *q; 两个访问之间隔着指针,别名分析没做完之前,谁也不敢说 y 读到的是不是刚写的 1。Loads/stores 若不版本化,优化器对内存的推理退回到"逐条怀疑"的原始状态。
Memory SSA 的做法直截了当:把"内存"看成一个虚拟变量 M,每个可能写内存的指令产生新版本,读操作引用它读的那个版本:
M0 = 初始内存状态 store p, 1 → 定义 M1 = M0 的写版本(p 指向处) store q, 2 → 定义 M2 = M1 的写版本(q 指向处) load r, 4 → 使用 M2,若别名分析断言 p/q/r 互不别名, load 可被提升为常量 4,甚至整条消掉 load s, ? → 若与 M1、M2 的写地址可能重叠: Ms = phi(M1, M2) 处仲裁 —— phi 也可以长在内存上
这层版本化的直接收益:死存储删除(后一个写覆盖前一个写且中间无读,前者即死)、读提升(store 后紧跟同地址 load,load 替换为被存值)、以及别名分析结论的缓存载体。代价同样明确:版本链的维护随每个内存操作发生,别名分析不精确时版本链退化成一条长链,推理能力跟着缩水。现代编译器普遍把它作为独立的分析设施挂在 SSA 旁边,而不是混进标量 SSA 本体。
三、门控方向:把"走哪条路"写进数据流
标准 phi 只说"从哪条边来取哪个值",不携带路径成立的条件。有一类优化恰恰需要条件本身:若 if (c) x = a; else x = b; 之后紧接着 if (c) y = x;,人一眼看出第二个判断恒真——但 phi 把 c 的信息抹掉了,y = x 无法化简成 y = b。
GSA(Gated Single Assignment)给 phi 装上门:
标准 SSA: GSA: if c if c x1 = a x1 = a else else x2 = b x2 = b x3 = phi(x1, x2) x3 = phi(c ? x1 : x2) (门记录:取 x1 当且仅当 c 成立)
类似的意图在 psi 形式里以"谓词化的定义"表达:每个带条件的定义额外携带成立谓词,优化器沿谓词做蕴含推理即可折叠冗余分支。这一族形式是分支预测、谓词执行与值推测优化的理论底座。代价是表示更重、通用性更差——多数编译器不把门控信息留在 IR 里,而是按需临时重算控制依赖(第4章的控制流分析正是重算的素材)。
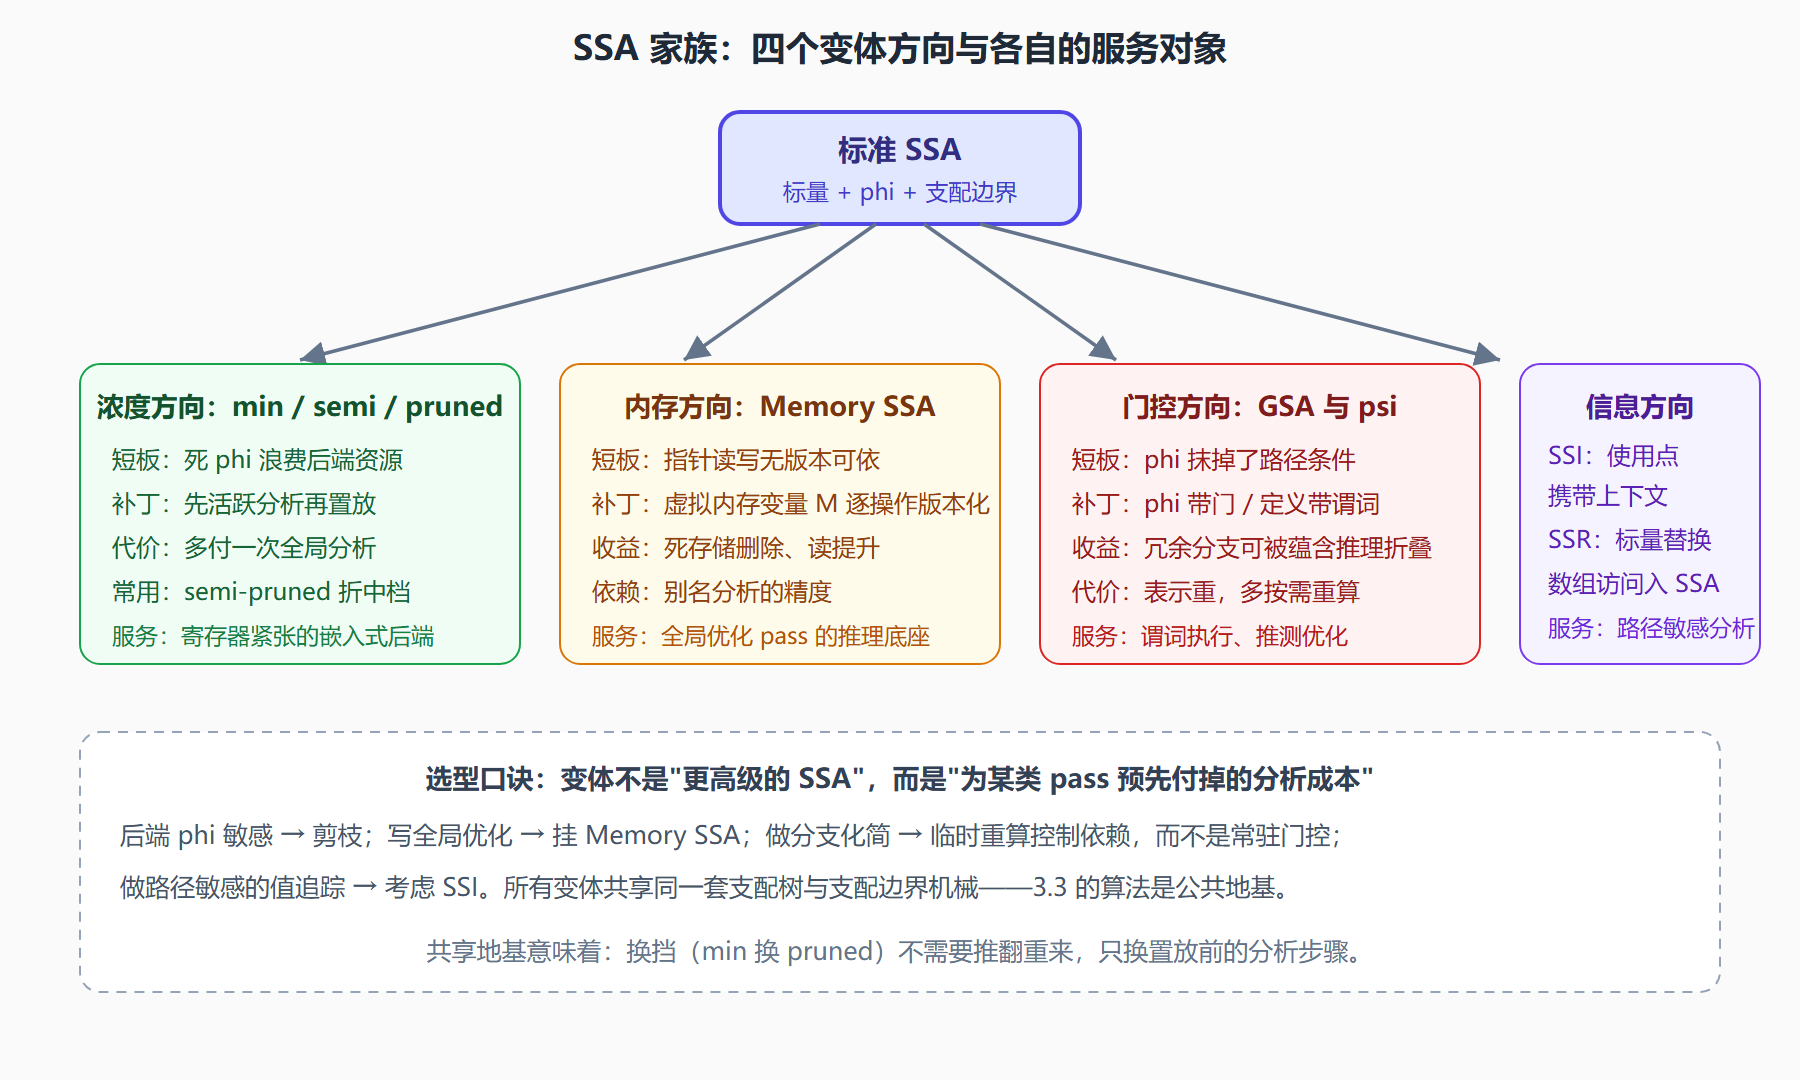
图:SSA 变体谱系——每个分支补标准形式的哪块短板
四、变体之外的"扩展用例"
谱系图之外,还有两个用法值得知道,它们不是新形式,而是 SSA 思想的越界使用。
数组与循环的 SSA 化。数组元素 a[i] 在标准 SSA 里原样保留(对内存的访问归 Memory SSA 管);但对"整个数组当作值"的场景,可以把 a 整体版本化:a1 = store(a0, i, v)。循环携带的数组依赖随之变成 a2 = phi(a0, a1),依赖距离一目了然。向量化 pass 依赖这种整体视角判断"这圈循环能不能改成 SIMD"。
SSA 图与即时编译。JIT 编译器常把前端来的线性 IR 在内存里直接铸成 SSA 形式的图结构(def-use 边即指针),让热点探测后的优化从 SSA 图起步。这等于把 3.2/3.3 的静态概念挪到运行期限时完成——也解释了为什么 JIT 对"构造算法要快"偏执:支配树求近线性,不是学术洁癖,是延迟预算的硬约束。
本节要点回顾:
- 浓度三档:min 无分析、semi-pruned 局部分析、pruned 全局活跃分析,phi 越来越少;
- Memory SSA:内存作为虚拟变量版本化,死存储删除与读提升的推理底座;
- GSA/psi:把路径条件写进数据流,服务谓词与推测优化,常驻成本高;
- SSI/数组 SSA:让使用点或聚合对象携带更多信息,服务路径敏感分析与向量化;
- 共同地基:支配树与支配边界;变体之间换挡不换骨架。
phi 的故事还剩最后一环:优化做完、要下后端了,这些 phi 怎么体面地退场。下一节讲 De-SSA。
快问快答
问:既然 pruned SSA 最省,为什么不全用它? 因为剪枝的前提是全局活跃分析,而构造 SSA 的时机常常在分析管线早期——分析还没跑、信息还不全。semi-pruned 的聪明在于用"局部可见性"这个便宜信号近似了剪枝的大头收益。等管线后期信息齐了,死 phi 会被死代码删除顺手清掉——殊途同归,只是成本支付的时点不同。
问:Memory SSA 与别名分析谁先谁后? 互相供养。别名分析为 Memory SSA 的版本链提供"这俩访问撞不撞"的判定;反过来,版本链让别名结论有了可缓存的载体,不必每个 pass 重算一遍。理解成" Memory SSA 是别名分析的簿记系统"最贴切——账本本身不做判断,但让判断结论可以被复用与失效。