7.2 LLVM IR 的三种形态
7.2 LLVM IR 的三种形态
本节摘要:同一份 IR 以三种形态存在:文本 IR(人类可读,
.ll)、位码(紧凑二进制,.bc)、内存中的 IR 对象(pass 操作的实体)。三者语义等价、可互相转换,但服务对象迥异——文本形态给人读与调试,位码给存储与传输(LTO 的载体),内存形态给 pass 改写。本节讲三种形态的转换工具链、位码为什么比文本小一个量级、内存 IR 的句柄体系(Value/User/Use 三角),以及"信息只在内存形态存在"带来的可重现性话题。读完你应当能按场景选对形态与转换命令,并解释 LTO 为什么必须依赖位码。
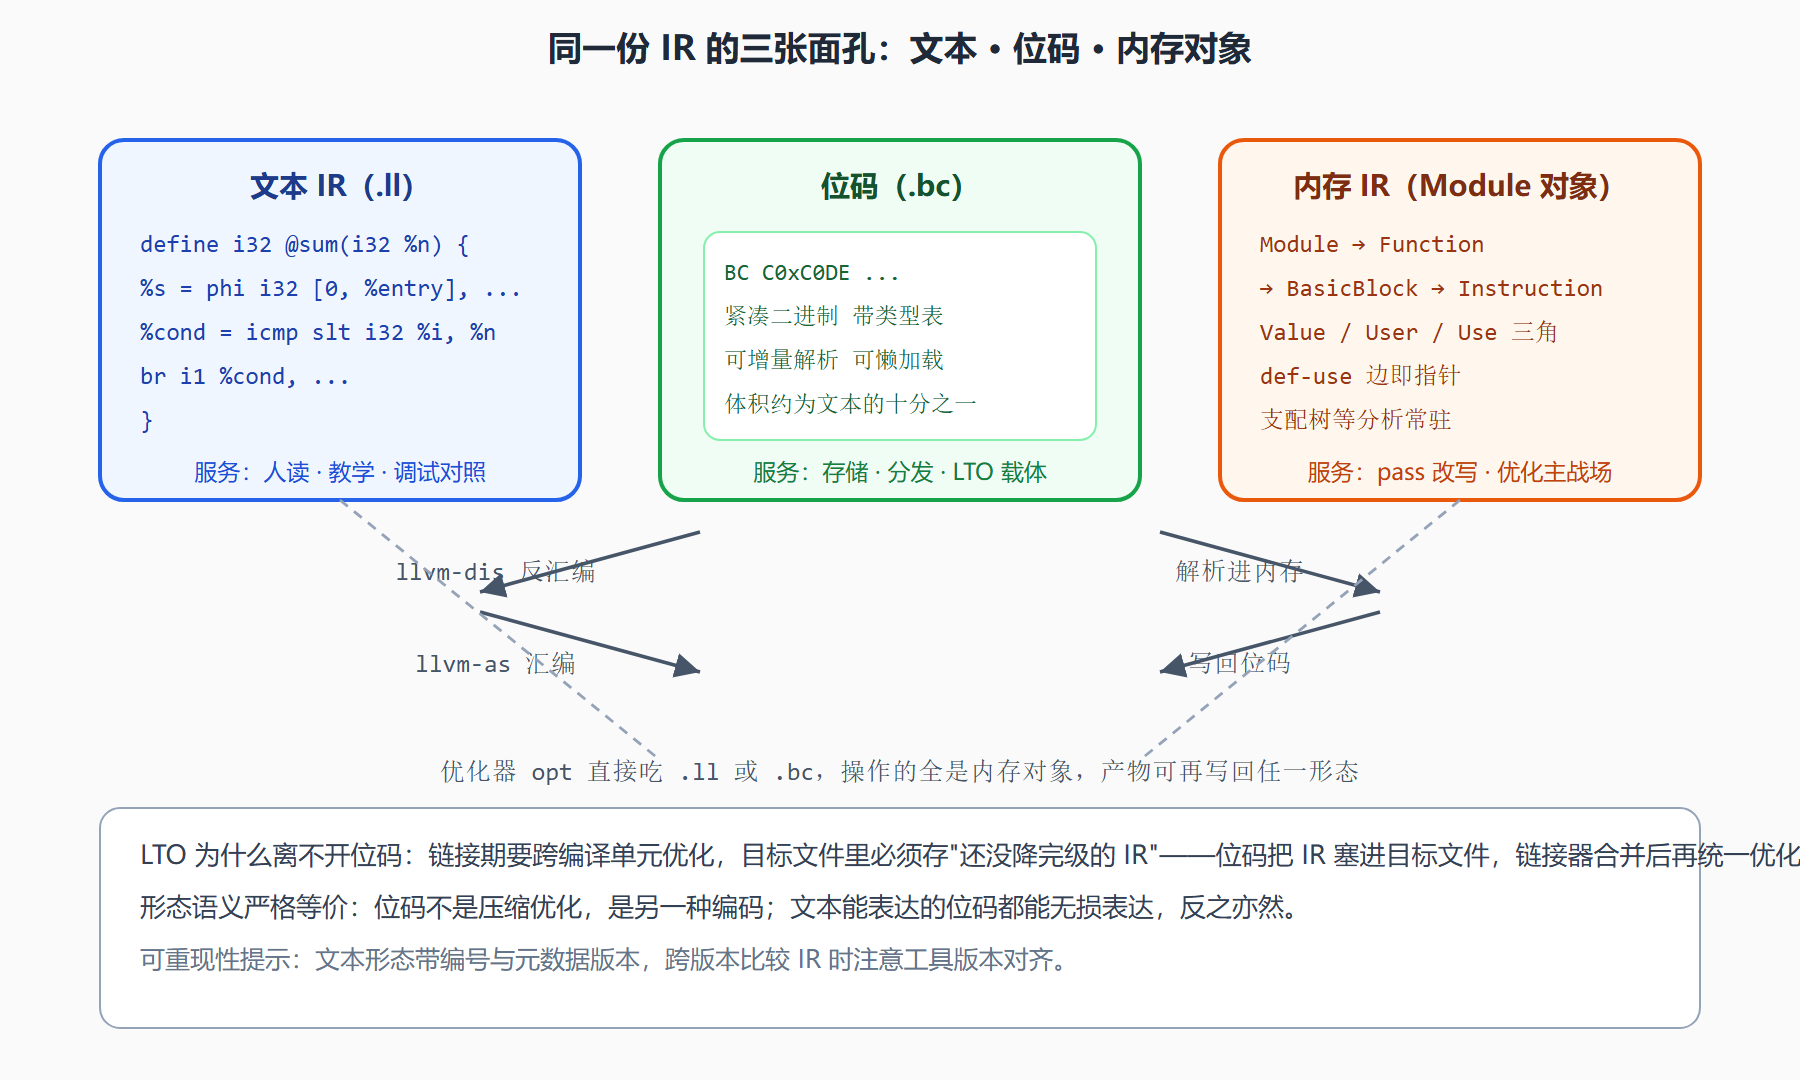
7.1 读的是文本形态的 IR——那是给人看的化妆。同一份函数在磁盘上还有一张二进制的脸,在内存里还有一副骨骼。三种形态一张图看完:
图:LLVM IR 的三种形态与转换工具
一、文本形态:给人看的 SSA
文本 IR 的设计目标是"可读、可写、可 diff"。7.1 那段 @sum 就是它。三个对读者最友好的设计:显式块标签(entry:、exit:——CFG 的形状直接印在文本上)、每个值带类型(不用猜宽度)、无限 % 名字(SSA 的版本化扑面而来)。阅读技巧在 7.1 已经给过:找 phi 即找汇合点,找回跳 br 即找循环。
文本形态也是调试优化的工作台:改写前后各 dump 一份,逐块对照"哪个 pass 动了哪条指令"——7.4 的完整实例全程用这个手法。代价是冗长:同一段代码,文本形态的体积通常是位码的十倍上下,且解析慢——所以它不适合作为存储与分发格式。
二、位码:给机器存的 IR
位码(bitcode)把 IR 编码成紧凑二进制:类型表去重、指令按操作码变长编码、频繁模式走捷径表。两个工程特性让它成为 LTO 的唯一选择。其一体积:分发与增量构建的成本大幅下降。其二懒加载/增量解析:链接器可以只解析函数清单(符号表)、把函数体留到位码里,谁被优化真正需要才解析谁——全程序优化时,几十万函数里真正进入优化管线的只是一小部分,懒加载直接砍掉解析时间。
位码还有一个战略后果:它是"未降级的程序"的存储形态。目标文件里的机器码只能给一种 CPU 用,位码里的 IR 还保有全部高级语义——同一份位码可以等 LTO 时按目标机型优化,这正是"应用商店按设备重编译"类玩法的技术基础。
三、内存形态:pass 的战场
优化运行时,IR 是一堆互相指着的 C++ 对象:Module 持有 Function,函数持有块,块持有指令。三个基础角色构成三角:Value(一切"有值的东西",指令、常量、参数都是)、User(使用别的值的东西——几乎所有指令)、Use(一条具体的"使用"边)。指令想知道"我被谁用了"(def-use 链,3.2 的第二项红利)沿着 Use 链表一步到位;pass 删除指令前的"replaceAllUsesWith"就是在这张三角网上换线。
内存形态里还常驻着分析结果对象:支配树、循环树(4.3/4.4 的产物)、别名分析(4.5)——它们由 pass 管理器(7.5)按需构造、缓存、失效。换句话说:优化时编译器内存里同时存在"表示"(IR 对象)与"事实"(分析对象)两个世界,pass 的工作就是在事实的背书下改写表示。
⚠️ 实操提醒:三种形态的转换命令要对号——文本到位码用汇编工具,位码到文本用反汇编工具;优化器两者都吃。混淆命令是初学者第一坑,记住方向即可:向文本走是"反汇编"(给机器的给人看)。
本节要点回顾:
- 三种形态一个语义:文本给人、位码给存储、内存给 pass;
- 转换双向:汇编/反汇编一对命令,优化器两种磁盘形态都吃;
- 位码两大特性:紧凑(约十分之一)+ 增量解析(LTO 只解析真正需要的函数);
- 内存三角:Value/User/Use,def-use 链是 3.2 红利在实现层的形状;
- 分析与表示并存:内存里常驻支配树、循环树、别名结论,pass 在事实背书下改写。
形态看清了,接下来看谁在改写它们:两 KB 级的 pass 清单怎么分类、各自值几个百分点的加速。
变式演练与追问
演练:一次转换全流程。把 7.1 的 @sum 走一遍三形态:先由前端产出文本形态(.ll,人可读,用于阅读 SSA);再"汇编"成位码(.bc,体积骤减,这一步同时是发布给 LTO 的形态);链接期优化工具把位码解析进内存(第三个形态),跑完优化管线后写回位码或直接进入后端生成机器码。三个形态各出场一次,各司其职——这个流程里没有任何一步是"为了走流程",每步转换都对应一个真实的消费场景。
问:文本形态会丢信息吗? 语义上不会——三种形态严格等价,文本能表达的一切位码都能无损表达。会变的是"外观":数值常量的进制、临时名字的编号在往返转换中可能重排。所以"diff 两份 IR 判断 pass 做了什么"时,要么用同一工具的同一版本产出,要么用专门的比较工具忽略编号差异,否则 diff 里一半是噪音。
问:为什么不用统一的"既可读又紧凑"格式? 因为两个目标在根本上打架:可读性要求全量展开每个细节(类型、名字、结构),紧凑性要求把重复结构编码成表引用与变长整数。一头熊掌一头鱼,工程的选择是干脆做两份——反正语义层只有一份实现,两种格式只是两套编码器,维护成本可控。这是"表示的多形态化"思想又一次胜过"寻找万能格式"。
问:内存形态的对象会被序列化压缩吗? 不会,内存里就是完整展开的对象图,为的是 pass 改写时的零解析开销。代价是内存占用大——大型程序的优化进程动辄几个 GB,其中大部分是 IR 对象与分析结果的常驻。这也解释了链接期全程序优化为什么吃内存:把全部编译单元的 IR 同时请进内存,就是用内存换全局视野。
一个收尾的观察:三种形态对应三种"读者"——人、存储系统、pass——而编译器工程里"为不同读者定制同一语义的不同表示"是个反复出现的主题。位码的紧凑、文本的直白、内存的灵活,没有一种形态试图讨好所有人。当你设计自己的工具链(哪怕是简单的配置格式),"一份语义、多种编码、按读者分工"依然是最经得起考验的答案。