7.3 优化 Pass 分类与典型加速比
7.3 优化 Pass 分类与典型加速比
本节摘要:LLVM 的优化 pass 数以千计,但按四个坐标可以收拾得井井有条:作用范围(局部/全局/循环/过程间,第5章的坐标系直接平移)、消费的分析(谁给它背书)、改写对象(指令/循环结构/调用图)、运行档位(O0–O3 的取舍哲学)。本节给出一张常用 pass 清单——每项标注它对应本册哪一节的概念、以及业界常见的收益量级——并解释"加速比为什么不兼容相加"。读完你应当能对任何 LLVM pass 报出它的坐标,并在面对"-O2 比 -O0 快 N 倍"这类说法时拆出 N 的构成。
第5章讲的是"优化思想",本节讲"优化商品":思想如何在真实编译器里被切成一个一个可开关、可组合、可测试的 pass。
一、四个坐标:给 pass 建户口
给任何 pass 报户口,问四个问题就够:
- 作用范围:盯基本块(局部)、跨块(全局)、绕循环(循环)、跨函数(过程间)——第5章的四档原样适用;
- 消费什么分析:支配树?活跃性?别名?Memory SSA?——分析依赖决定它在管线里的位置(7.5 的主题);
- 改写什么:改指令(等价重写)、改控制流(折叠分支)、改调用结构(内联)、改数据布局(向量化);
- 风险档位:数学上严格等价(如死代码删除)还是语义放松(如浮点重结合)——后者必须开关显式授权。
二、常用 pass 清单与收益量级
下表是出现频率最高的一批 pass,"出处"列指向本册对应节——学完本册再读 pass 名单,应该是点名而不是背书:
| Pass | 干什么 | 坐标 | 出处 | 典型收益量级 |
|---|---|---|---|---|
| instcombine | 指令规范化合并 | 局部 | 5.1 折叠与化简 | 间接:给下游喂规整输入 |
| SCCP | 稀疏条件常量传播 | 全局 | 5.1 + 3.4 phi | 常量密集代码 5%–20% |
| DCE/adce | 死代码删除 | 全局 | 5.1 + 4.2 活跃 | 间接:减小体积与压力 |
| licm | 循环不变量外提 | 循环 | 5.2 外提三道闸 | 热循环 5%–30% |
| indvars | 归纳变量规整 | 循环 | 5.2 强度削减 | 为向量化铺路 |
| loop-unroll | 循环展开 | 循环 | 5.2 展开 | 1.1–1.5 倍(热点内核) |
| loop-vectorize | 自动向量化 | 循环 | 5.2 SIMD | 科学计算内核 2–8 倍 |
| inline | 函数内联 | 过程间 | 5.3 发动机 | 触发连锁,整体常达 10%+ |
| gvn/newgvn | 全局值编号消重 | 全局 | 3.4 值编号 | 冗余计算多的代码 5%–15% |
| mem2reg | 提升 alloc 到 SSA 值 | 全局 | 3.3 构造 | 前端配套:把栈变量变 SSA |
| regalloc 群 | 寄存器分配 | 后端 | 6.2/6.3 | 决定内存流量大盘 |
两个阅读要点。mem2reg 的存在感:前端(如 Clang)偷懒不构造 SSA,先把变量全放栈上,再由 mem2reg 统一提升——3.3 的构造算法在工业里被编排成"先降级后提升"的 pipeline 开头。收益量级的口径:表里的百分比对"该优化能吃到的代码",不是全程序平均——向量化 8 倍的神话属于矩阵内核,不是整个程序。
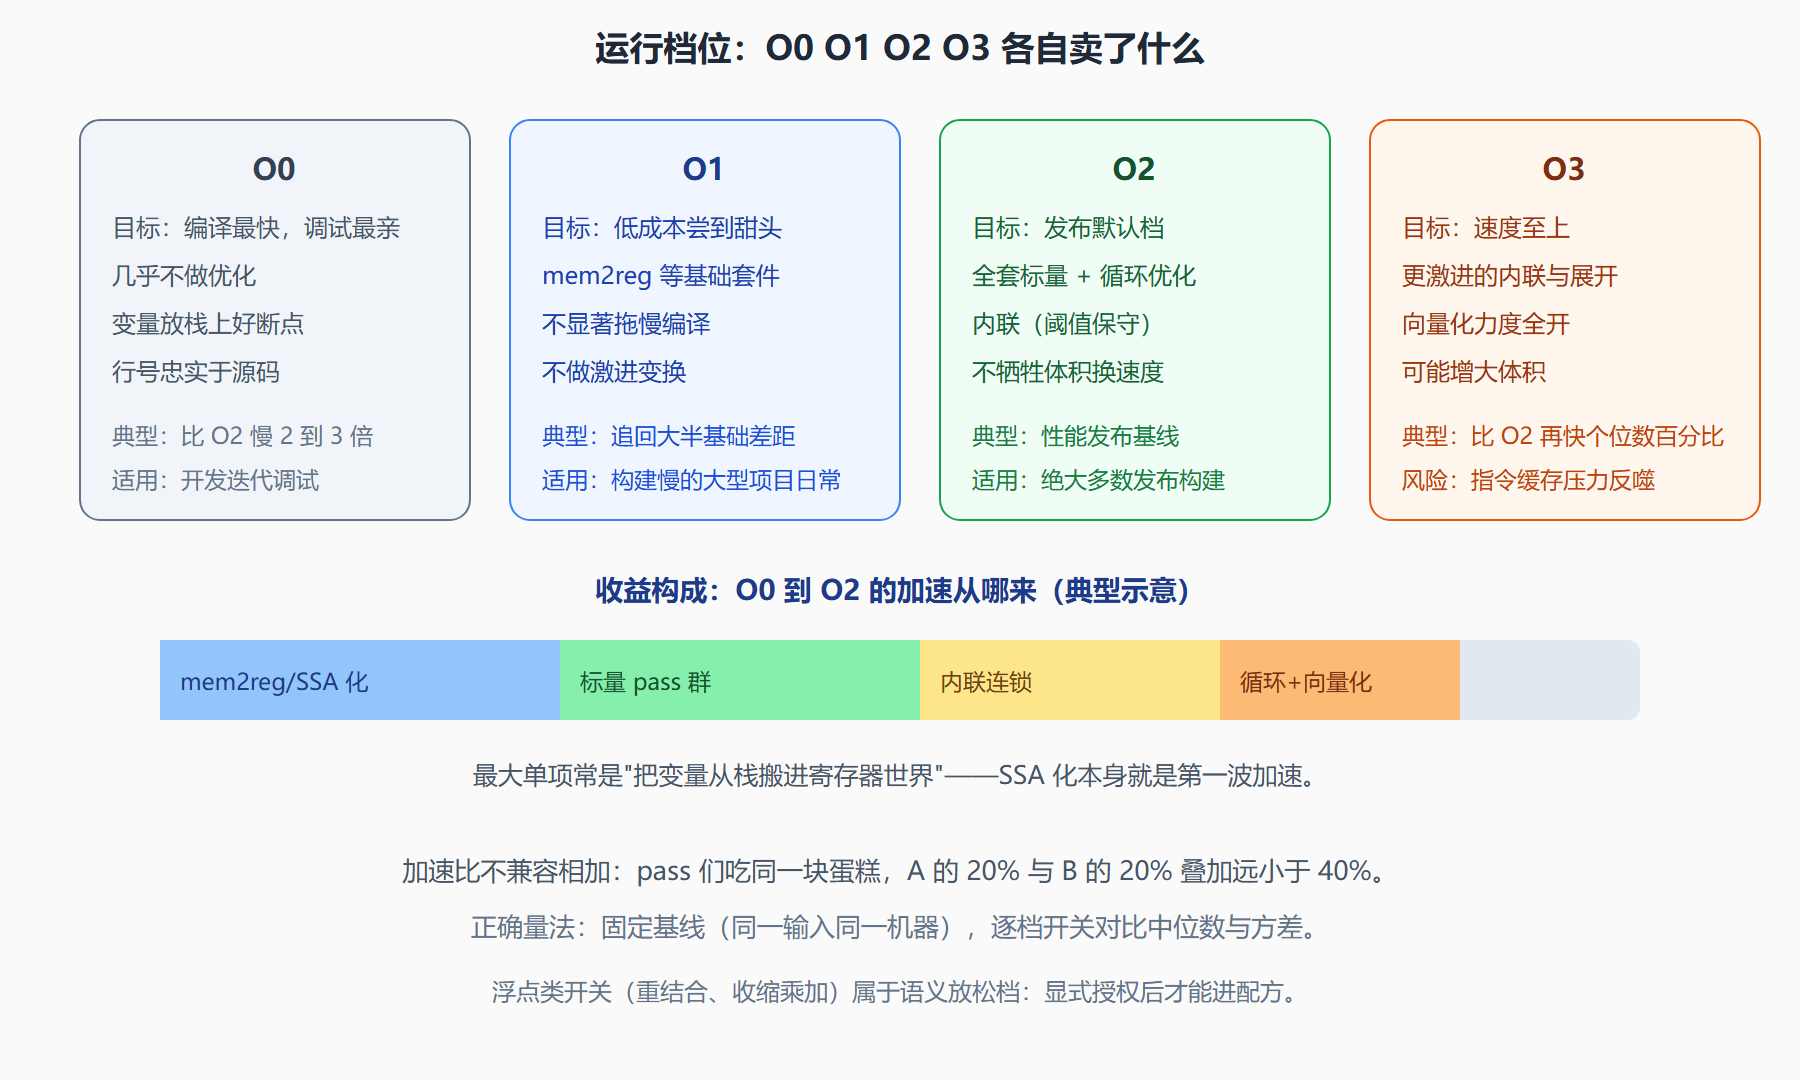
图:O0 到 O3 的取舍哲学与收益构成
三、加速比的三条纪律
对着数字做工程判断,三条纪律防踩坑:
- 收益不可加。每个 pass 的"20%"都以"进入它时的代码状态"为基线——pass 互相吃蛋糕:内联开启后,内联前的常量传播收益被重新计算。管线是生态系统,不是购物车。
- 单项最大头是 SSA 化本身。O0 与 O2 的差距里,最大一块常来自"变量从栈进寄存器世界"(mem2reg + 基础标量套件)——呼应本册主线:表示的先进性直接兑换性能。
- 量法固定基线。同一机器、同一输入、关掉频率调节、跑中位数(不跑单次),对比才有意义。工程上评估一个新 pass 的标准动作是 A/B 两次全量跑分,不是看 pass 自己声称的数字。
💡 关键直觉:看 pass 清单别背名字,背"它消费什么分析"。任何 pass 的威力上限 = 它消费的分析精度——别名分析不准,死存储删除就瞎;支配树现成,SSA 类 pass 就便宜。这条推理链能让你对新 pass 的收益上限做出一秒钟的直觉估计。
本节要点回顾:
- 四坐标户口制:范围、分析依赖、改写对象、风险档位——任何 pass 都能快速定位;
- 清单即索引:每个 pass 对应本册一节,优化商品是优化思想的切片;
- 档位哲学:O0 调试、O1 基础、O2 发布、O3 激进;O0→O2 的最大单项是 SSA 化;
- 收益不可加:pass 互相吃蛋糕,评估必须固定基线跑中位数;
- 威力上限公式:pass 的收益 ≤ 它消费的分析精度。
清单看完了,纸上谈兵到此为止——下一节动手:从一段 C 源码出发,把本册全部概念在命令行里走一遍。
一组快问快答
问:pass 那么多,编译器怎么保证它们不出错? 靠三层防线。第一层是正确性证明义务——每个 pass 的变换必须保持可观测行为,这是写 pass 时的纪律与测试覆盖;第二层是验证器——每次改写后验证器检查 IR 不变式(SSA 合法、支配一致),违规当场报错而不是带病传播;第三层是差分测试——同一份代码在有无某 pass 的两种管线下各自编译成可执行文件,用同一输入对比输出行为,编译器社区的持续集成里这类测试日日都跑。
问:"典型加速比"的数字从哪来? 两个来源要分清:基准测试套件上统计的中位数(可信但平均主义,往往只有个位数百分点),以及精心构造的内核上的峰值(吸引眼球但前提苛刻,比如向量化 8 倍要求循环无依赖、数据对齐、缓存命中)。读性能宣传先问口径:什么基准、什么硬件、多少次取中位——三个问题问完,数字的水分就拧得差不多了。
问:为什么 O0 与 O2 的产物差距那么大? 复习 7.3 的收益构成图:O0 把变量全放栈上、每条赋值都是访存,等于把最便宜的优化都关了;O2 从 mem2reg 起步,把值请进寄存器世界,再叠标量与循环 pass。两者的差距里没有魔法,大头是"表示先进性"的直接兑现——这也是本册把 SSA 放在核心位置的原因:表示对了,优化才有得做。