8.1 MLIR 的核心架构
8.1 MLIR 的核心架构
本节摘要:MLIR(Multi-Level Intermediate Representation)用一套极小的统一抽象支撑"多级 IR":方言是命名空间,操作(operation)是唯一的一等公民,属性与类型携带元信息,块与区域承接 SSA/CFG 语义——本册第3章的控制流概念原封适用。在此之上,"编译"被重新定义为"从高语义方言逐级降级到低语义方言",每次降级本身就是一个 pass(第7章的机制直接继承)。本节讲清这套抽象为什么能同时容纳张量运算与标量指令,以及"可扩展 IR"解决了单级 IR 的什么死结。读完你应当能用四件套的术语描述任意 MLIR 代码片段,并说清降级链的运行机制。
LLVM 章末尾留了个悬念:"多级中间表示"到底比单级多出了什么。本节从单级 IR 的一个具体困境讲起,再看 MLIR 的抽象怎么解。
一、单级 IR 的死结:语义过早蒸发
把"C = A × B(两个 1024×1024 的矩阵相乘)"编译到 LLVM IR,会发生什么?矩阵乘的三重循环结构进 IR 后只剩标量指令:load、fmul、fadd、br。张量的形状(1024?还是 4096?)、访问模式(行主序?分块策略?)这些最高价值的语义,在进入 IR 的第一刻就没了。优化器想把它变回高效的 SIMD 内核,只能靠启发式反推:认归纳变量、猜依赖方向、赌对齐——5.2 的向量化 pass 干的就是侦探工作。
问题不在 LLVM 做得不好,而在单级表示天然只能选一个抽象档位。选高了(离机器远),后端要自己降;选低了(离机器近),高阶语义没地方放。AI 负载把这个死结顶到了明面上:张量运算与机器指令之间的语义落差,比 C 与指令之间大了整整一个数量级,垫一层 IR 根本不够用。
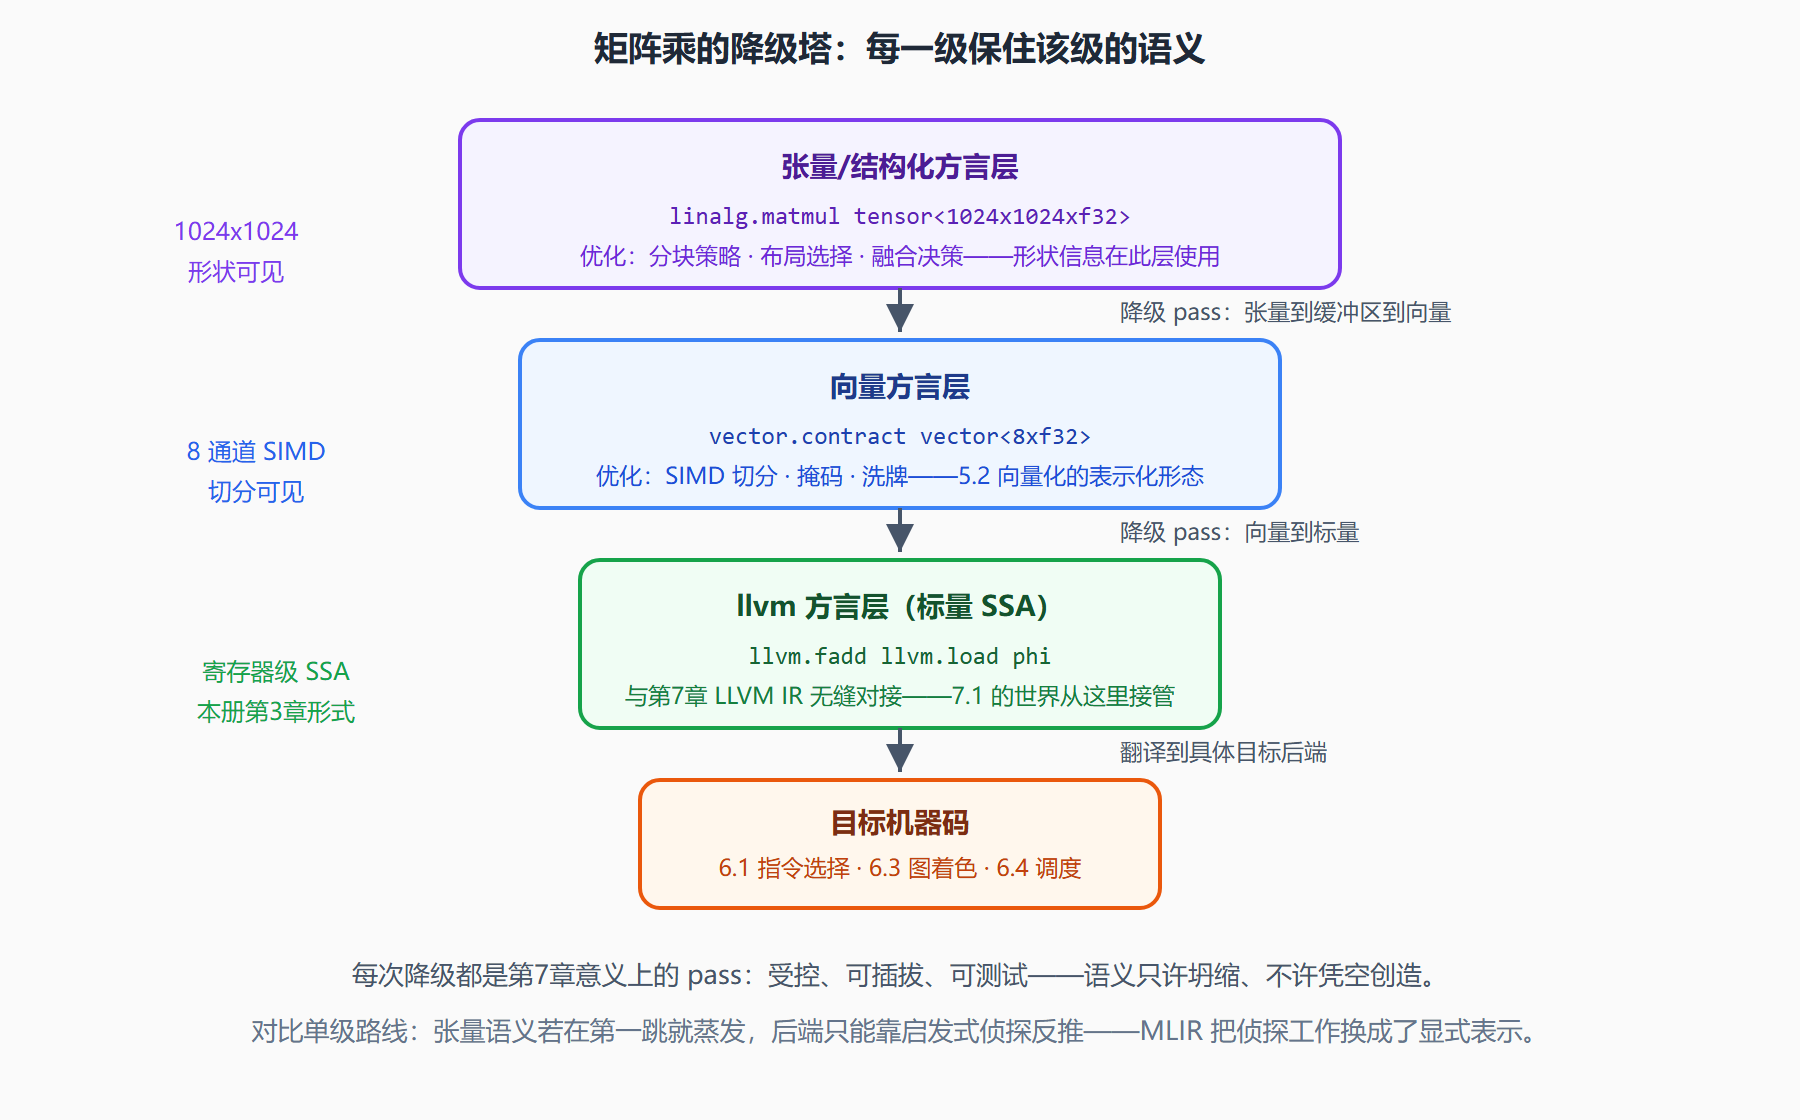
MLIR 的回答:IR 的抽象层级不该是编译器的常量,而应是编译过程的变量。同一个编译器里并存多种方言(dialect)——张量级的、向量级的、标量级的——编译即从高语义方言"逐级降级"到低语义方言,每一级保住该级的语义做该级的优化。张量乘在最高层还是"乘",形状与布局都在;降到向量层才变成 SIMD 切分;降到 llvm 方言才是 7.1 读过的那种 IR。
二、四件套:方言、操作、属性、类型
MLIR 的一切由四个构件拼成。看一段真实的 MLIR(张量乘的降级链起点):
%result = linalg.matmul ins(%A, %B : tensor<1024x1024xf32>, tensor<1024x1024xf32>) outs(%C : tensor<1024x1024xf32>) -> tensor<1024x1024xf32>
- 操作(operation):唯一的一等公民。
linalg.matmul是一个操作——它把"矩阵乘"作为原语表达,而不是拆成三重循环。传统 IR 的一条指令 ≈ 一个操作;区别在于操作的集合可无限扩展。 - 方言(dialect):命名空间。
linalg.前缀表示它属于 linalg 方言;vector.transfer属于 vector 方言;llvm.add属于承接 LLVM 的方言。方言 = 一族相关操作的集合 + 它的降级规则。 - 类型(type):形状与元素类型直接写在值上——
tensor<1024x1024xf32>。7.1 的类型系统思想被放大:类型不描述"32 位整数"这种机器概念,还能描述"1024×1024 的单精度张量"这种领域概念。 - 属性(attribute):挂在操作上的编译期常量与元信息(步长、排列、padding 策略)。它让"这个 matmul 想怎么切"这样的策略信息有处可放——单级 IR 里这类信息通常只能丢。
结构层面,操作包含区域(region),区域里是块(block),块里是操作——递归自指。但块、参数、跳转的语义与 3.1 的基本块/CFG 完全同源;标量计算降到最低层后,形式上就是熟悉的三地址码加 phi。新瓶装的是旧酒 + 新的酒:控制流理论原封继承,"值唯一赋值"的 SSA 纪律原封继承,被扩展的只是"操作与类型可以自定义"。
图:降级塔——语义逐级受控坍缩
三、降级机制与基础设施的继承
降级(lowering)在 MLIR 里被建模成方言间的转换 pass:A 方言 → B 方言 的每条规则是一个可单元测试的小变换,pass 管理器(7.5)照单编排。第7章学到的机制几乎全数继承:分析缓存与失效(降级也弄脏 IR)、分层执行(张量级 pass 不必看到标量)、管线描述即配置(降级链是一份名单)。7.4 的"逐 pass 验收"工作法在这里同样成立——对照降级前后各 dump 一份,看哪个操作被拆、被换、被折叠。
基础设施之外,还有两个设计决策值得点名。其一,dialect 的开放性是双刃剑:任何团队可以造自己的方言(确实有大量 AI 芯片厂商这么干),表达力与生态碎片化的张力始终存在——评估"要不要自建方言"时,问的正是一个新 IR 该不该被造出来的老问题,只是代价从"改编译器本体"降到了"写一套新操作"。其二,通用基础设施的复利:因为四件套统一,为新方言写 pass 时,支配树、别名框架、序列化全部现成——3.x 与 7.x 的全部积累,以基础设施的形式再次变现。
💡 关键直觉:MLIR 没有发明新的数据流分析或新的 SSA——它发明的是"让 IR 本身可编程"。当表示可以按抽象层级定制,"编译"就从"一次翻译"变成了"沿受控阶梯的逐级换挡",而每一级挡位上的优化都站在完整语义的地板上。
本节要点回顾:
- 语义过早蒸发:单级 IR 只能选一个抽象档位,高阶语义进 IR 即丢失;
- 四件套:操作(一等公民)、方言(命名空间)、类型(含领域形状)、属性(策略元信息);
- 结构同源:块/区域/参数与第3章 CFG、SSA 完全一脉,扩展的是操作与类型的开放性;
- 降级 = 方言间 pass:受控、可测试、由第7章的 pass 管理机制编排;
- 开放性的代价:表达力与生态碎片化的张力,自建方言前先算生态账。
抽象讲完了,下一节沿一条真实的降级链走一遍——把"多级"从口号变成读得懂的代码。