8.2 典型 MLIR 方言应用
8.2 典型 MLIR 方言应用
本节摘要:本节沿"矩阵乘的三级降级链"读三段真实风格的 MLIR:linalg(结构化张量层——表达"做什么")、vector(SIMD 层——表达"怎么并行")、llvm 方言(标量层——表达"最后落地"),每一级标注它与本册哪一节的概念接轨。顺带看两个常见方言的功能定位:memref 承接缓冲区,func/cf 承接传统函数与控制流。读完你应当能独立读懂 MLIR 测试用例级别的代码,并对"AI 编译栈为什么纷纷长在 MLIR 上"给出四个技术理由。
8.1 把四件套讲成规范,本节把它用成阅读理解。材料是同一次矩阵乘在降级链三个站点上的形态——读它的过程,就是看语义如何"受控坍缩"。
一、第一站:linalg 方言——"做什么"的层
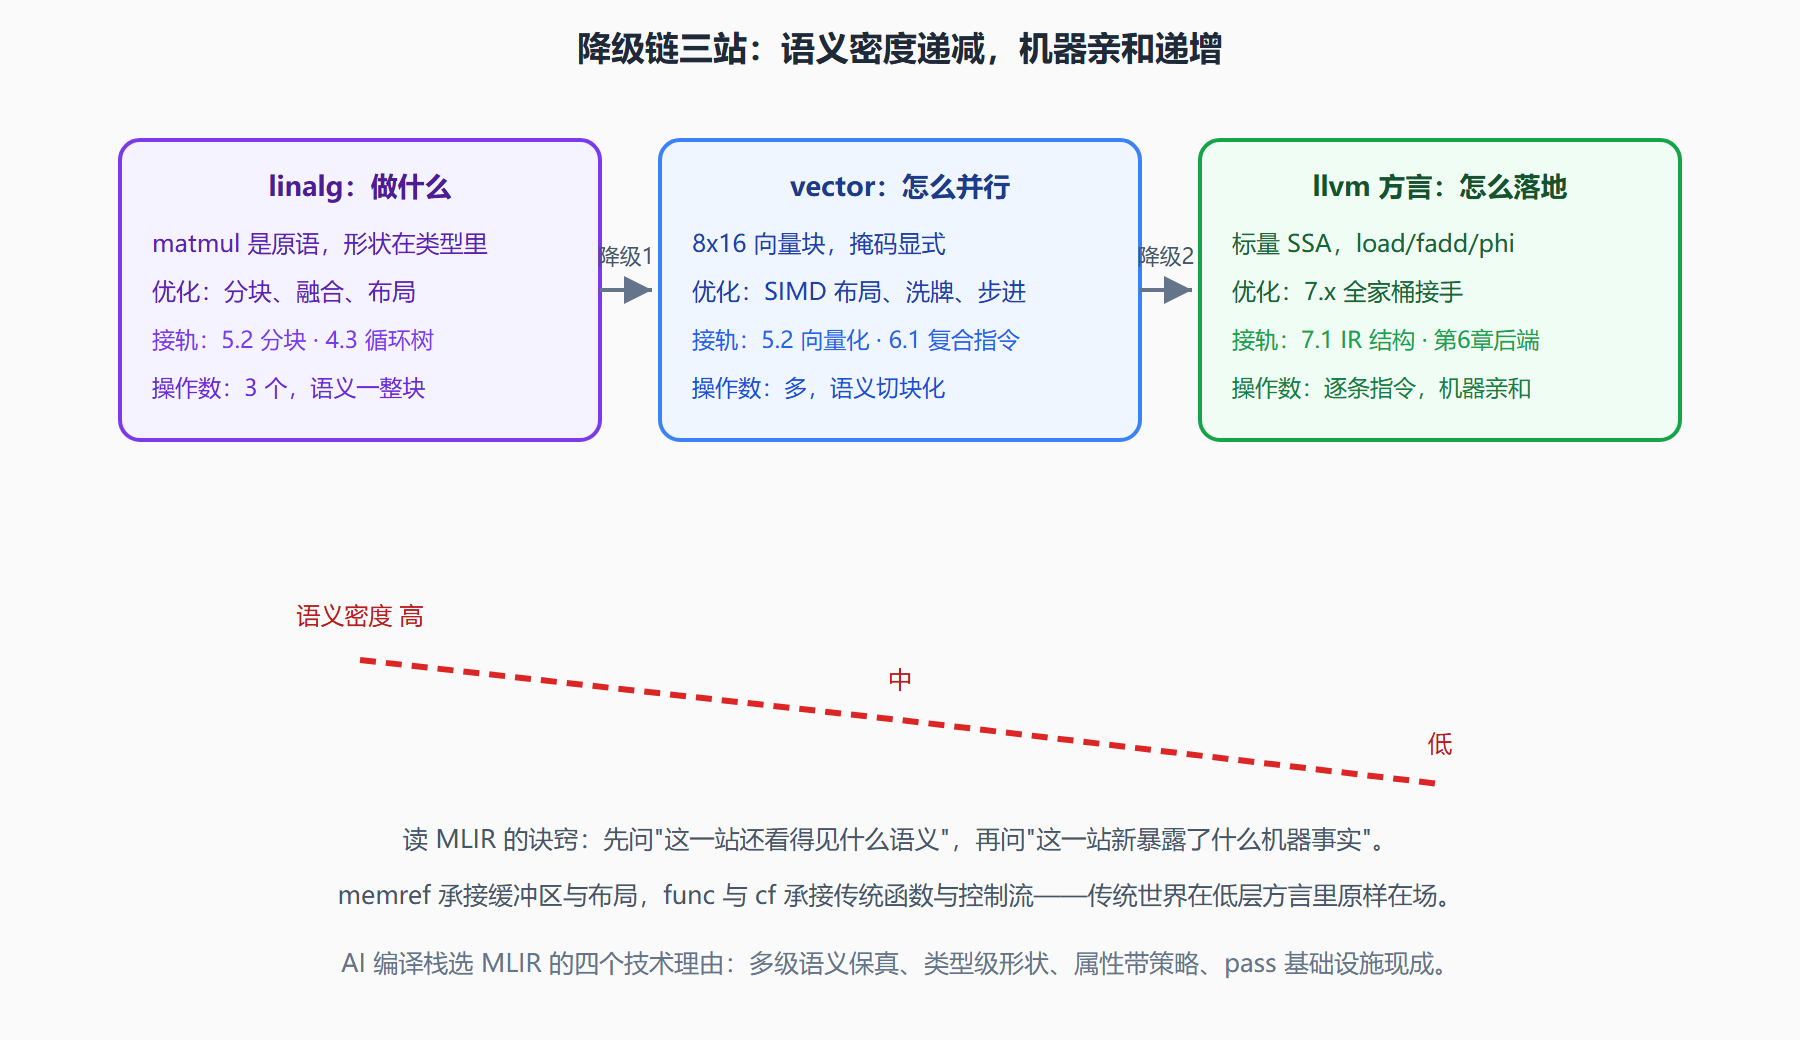
张量层的矩阵乘只有一行(8.1 已见),关键在它的结构化性质:
linalg.matmul ins(%A, %B : tensor<MxKxf32>, tensor<KxNxf32>) outs(%C : tensor<MxNxf32>) -> tensor<MxNxf32>
linalg 方言的每个操作都自带"迭代空间描述":哪个维度是行、哪个是列、哪个是规约维,类型系统里写得明明白白。这意味着 5.2 的分块决策不再靠启发式猜——tiling pass 直接读形状,按目标缓存大小选块尺寸,在张量层完成分块变换(循环树的 MLIR 版)。融合(fusions)也在此层决策:相邻的 matmul 与逐元素加法可以合并成一个 linalg 泛化操作,避免中间张量落内存。这些变换全部发生在"矩阵乘还是矩阵乘"的世界里——8.1 说的"每一级保住该级的优化机会",第一站的兑现。
二、第二站:vector 方言——"怎么并行"的层
降一级,张量变成缓冲区(memref),计算切成向量块:
// 张量先物化为缓冲区(tensor → memref 的降级,引入显式内存) %c0 = arith.constant 0 : index %tile = vector.transfer_read %A[%c0, %c0], %pad {in_bounds = [true, true]} : memref<1024x1024xf32>, vector<8x16xf32> // 向量级的规约乘加:SIMD 通道并行完成 8x16 小块的乘累加 %acc = vector.contract { indexing_maps = [map_row, map_col, map_out], iterator_types = ["parallel", "parallel", "reduction"] } %va, %vb, %vc : vector<8x16xf32>, ...
两处值得停留。vector.transfer_read 是"带语义的访存"——边界处理、越界填充都写在操作语义里,后端据此生成掩码或安全循环(对比 7.1 的裸 getelementptr,语义密度高了两个级别)。vector.contract 是规约乘加,其 indexing_maps 与 iterator_types 属性(8.1 四件套里 attribute 的用武之地)精确描述"哪些维并行、哪一维规约"——5.2 里"向量化要认出无迭代间依赖"的侦探工作,在这里变成了类型与属性上的直接事实。把 8 路向量铺到具体目标(AVX/SVE),是这个方言的降级 pass 的事。
图:三站连读——同一计算的语义密度递减曲线
三、第三站:llvm 方言与传统世界的会合
再降一级,向量拆成标量,形式回归 7.1:
%v0 = llvm.load %ptrA {alignment = 4 : i64} : !llvm.ptr -> vector<8xf32> %s0 = llvm.fadd %v0, %v1 : vector<8xf32> // 最终由翻译 pass 换成 LLVM IR 的 load/fadd,交给第6章后端: // 指令选择、图着色、指令调度接管——全册闭环。
控制流方面,func 方言给出函数,cf 方言给出分支与循环(br、cf.cond_br),语义与 3.1 的 CFG 完全一致;标量 SSA、支配树、数据流分析在 llvm 方言层全部无缝可用。传统编译器的全部遗产没有丢——它们被安放在降级塔的底部两层,而塔的新增楼层(张量、向量)负责承接单级 IR 接不住的高语义。
四、应用版图与选型思考
方言生态里有几类典型玩家。AI 编译栈(各训练/推理框架的下层)主要消费 linalg → vector → llvm 这条主链,分块与融合策略直接决定模型吞吐;领域加速器厂商为自研硬件造专属方言(描述其指令系统的操作与类型),复用 MLIR 全套基础设施,把"为芯片写编译器"的成本从"写一个编译器"降到"写一套降级规则";传统语言前端也有试验性的方言用于表达并行语义。反过来也有清醒的声音值得听:方言不是越多越好——每多一个方言,调试工具链、文档、团队心智都多一份负担。选型判断与前两章一脉相承:为"语义与机器之间落差的跨度"垫层,落差小就别多垫。
💡 关键直觉:读任何 MLIR 片段,问三个问题——这个操作属于哪个方言(抽象档位)、它的类型里藏着什么形状信息、它的属性里写了什么策略。三问答完,这段代码在降级塔上的位置与去向就已清楚——这就是统一抽象给读者的导航能力。
本节要点回顾:
- linalg 层:矩阵乘是原语,形状在类型里,分块与融合在此决策;
- vector 层:带语义的访存与规约乘加,"无依赖可向量化"从侦探题变成属性事实;
- llvm 层:标量 SSA 与 cf 控制流,与第3、6、7章无缝会师;
- 生态三玩家:AI 编译栈、加速器厂商、语言前端,共用一套 pass 基础设施;
- 选型守则:语义与机器的落差决定要不要垫层,落差小不多垫。
全册到此收束。回望:从"为什么需要中间表示"的算术账出发,经词法语法立骨架、语义符号表定含义、三地址码与 SSA 定表示、数据流控制流定分析、优化与后端定落地,最后在 MLIR 看到 IR 范式本身的进化——每一章都是下一章的地基,这正是当初那张知识地图许诺过的路线。