3.3 智能路径选择:链路切换决策
3.3 智能路径选择:链路切换决策
指标体系就位(3.2),本节到了 SD-WAN 数据平面最核心的动作:决策。这是"传统 WAN 一条路走到黑"与"SD-WAN 按需挑路"的分水岭所在。读完本节,你应当能画出一条流量的完整决策链,并说清切换的三要素:判据、滞回、回切。
决策发生在哪里
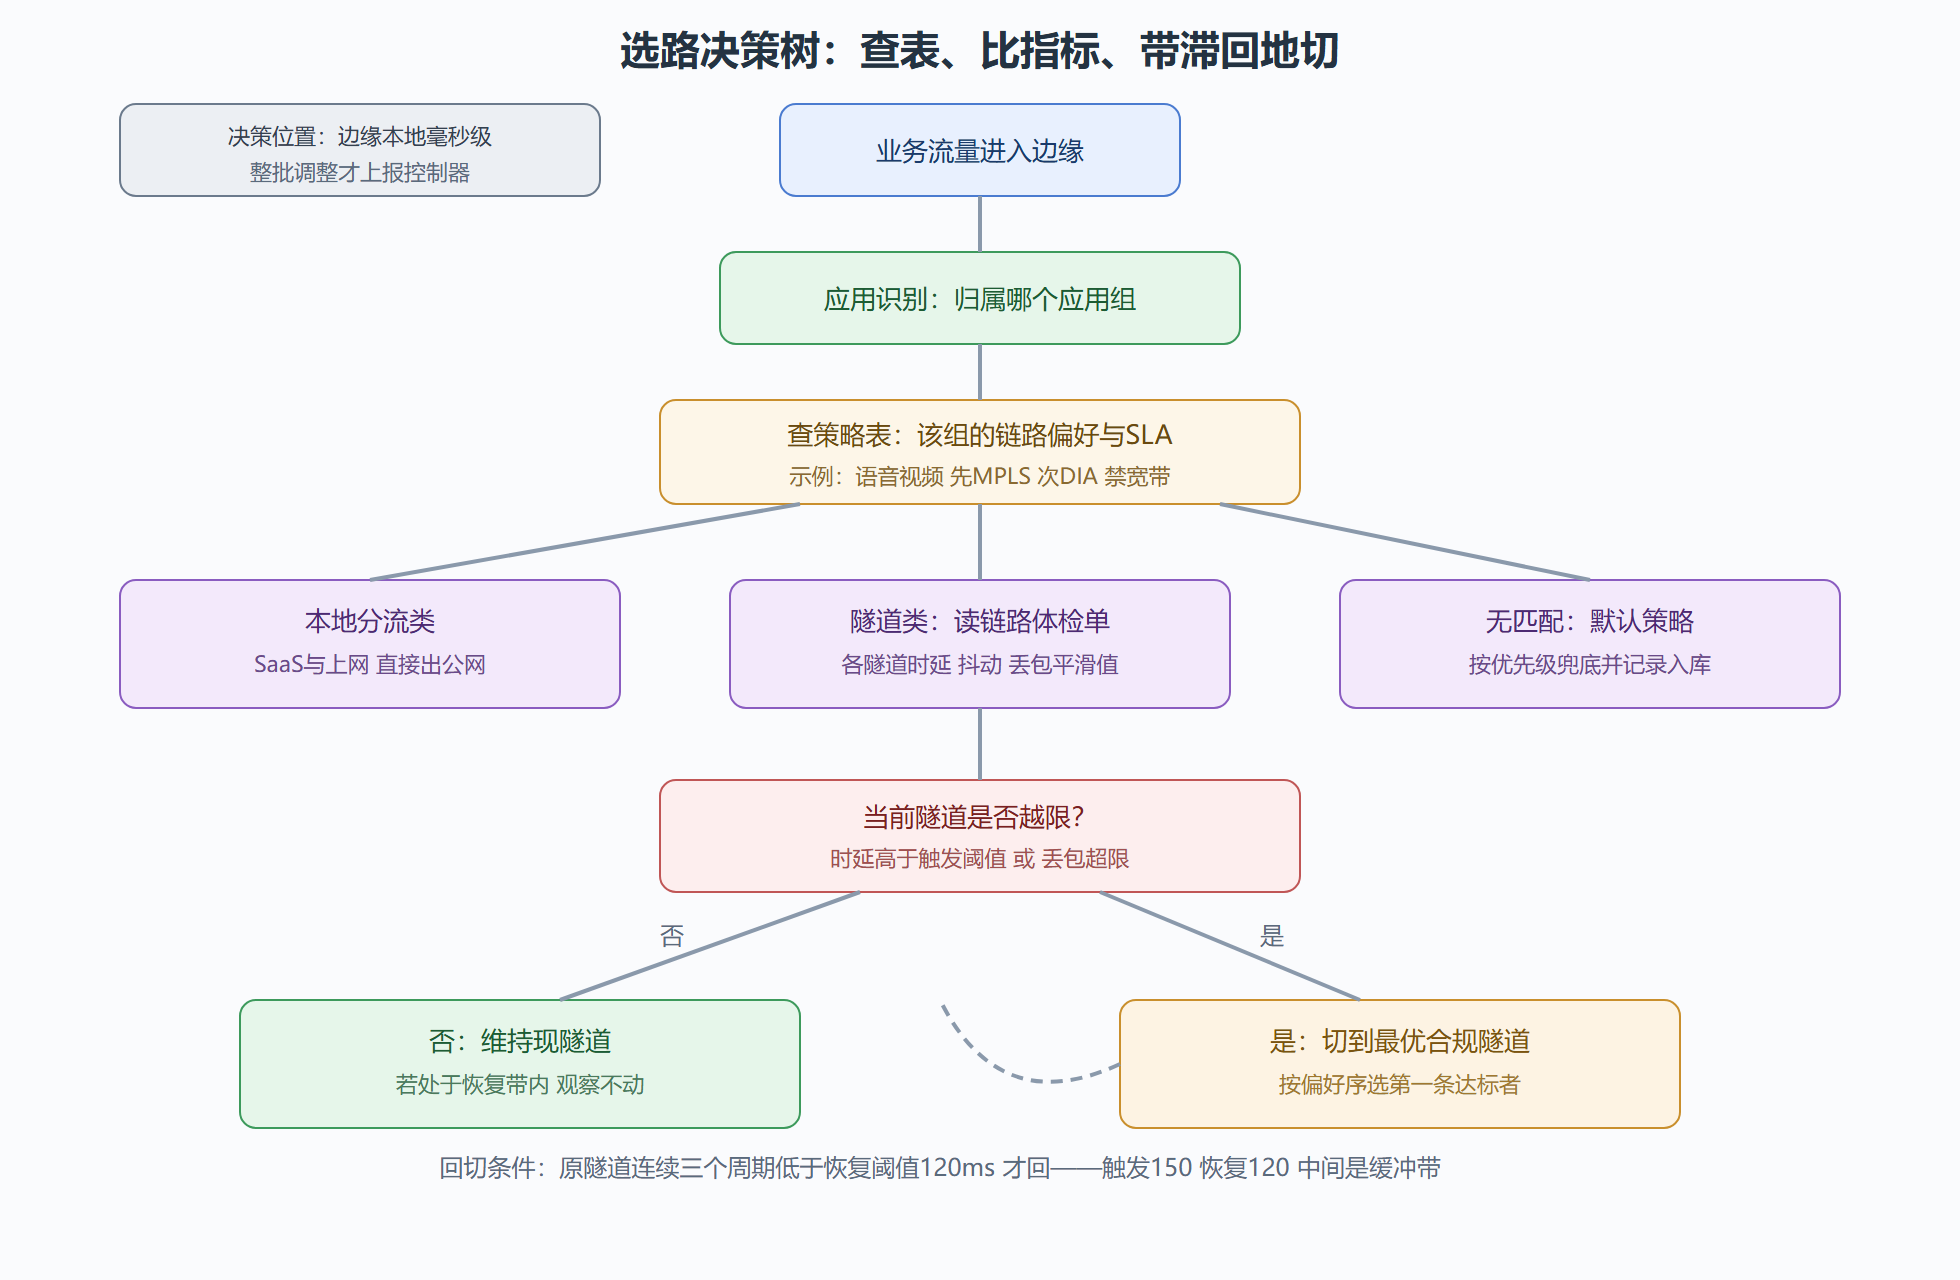
先纠正一个流行误解:选路决策并不都在控制器。按决策位置分两档。边缘本地决策:每个应用流的每个包,边缘设备查策略表——这个流属于哪个应用组、该组绑哪类链路偏好、当前各链路体检单如何——当场决定引入哪条隧道。它处理的是秒级以下的高频决策,不依赖控制器在线。控制器全局决策:涉及跨站点协同的动作(如某条宽带整体劣化、把该站点一批应用的偏好临时改走 MPLS),由控制器统一调整策略再下发。分工原则一句话:能本地决的不上报,需要全局权衡的才上收。
决策的输入:一张应用策略表
策略表的典型行项目长这样(示意):应用组"语音视频",绑定偏好"先 MPLS,次 DIA 专线,禁走普通宽带",SLA 触发条件"时延高于 150 毫秒或丢包高于 1%",恢复条件"连续三个探测周期低于 120 毫秒"。应用组"批量备份",偏好"仅宽带,夜间窗口",无 SLA 约束。应用组"互联网访问",偏好"本地分流直出"。应用识别(谁属于哪个组)由边缘的深度包检测与 4.3 节的应用库完成。
图:链路选路决策树:从流量进站到隧道出局
切换三要素之一:判据
切换判据 = 应用组的 SLA 阈值 + 链路体检单的实时比较。要点是比较的是同一口径:应用组要的是"端到端时延低于 150 毫秒",体检单给的必须是该应用流所经隧道的端到端平滑时延,而不是探测点之间的裸 RTT。口径错位是很多"为什么指标全绿用户体验却差"案件的根因。
切换三要素之二:滞回
没有滞回的切换系统会在阈值附近反复横跳:时延 149 维持、150 切走、149 切回——每次切换本身都有代价(流表更新、部分实现里还有短暂乱序)。滞回的设计是触发与恢复拉开距离:触发 150,恢复 120,中间 30 毫秒的缓冲带里只观察不动作。再配合"连续 N 个周期确认"(典型三个周期),把毛刺过滤掉。评估厂商实现时,这两组参数必须可配置——写死在代码里的滞回,遇到现网基线特殊的应用组会很难受。
切换三要素之三:回切与粘性
链路修好了,流量要不要切回来?多数方案支持"回切",但工程上建议对长连接类应用(文件会话、数据库连接)开启粘性:只要当前隧道达标,就不因原链路恢复而折腾。回切动作安排在业务低峰或由控制器择机批量执行。另一个细节是新流与老流:切换通常对新建流立即生效,存量流按应用特性决定是否迁移——TCP 大流迁移有乱序成本,语音小流迁移几乎无损。
全都不达标怎么办
决策树还有一条隐藏分支:当没有任何隧道满足该应用组的 SLA 时怎么办?成熟方案的行为是"择优劣化"——按综合评分选最不坏的隧道,同时上报告警与事件记录(哪条链路、超限多少、持续多久),供第 6 章的可见性平台呈现。此时第 4 章的纠错加速(FEC、重传、抖动缓冲)接力上场,把"劣化"尽量拉回"可用"。选路、纠错、告警三者构成完整的质量兜底链条。
一版可直接改用的策略骨架
把本节全部概念装进一份策略配置骨架(示意语法,按厂商规范改写),它同时也是给团队评审策略时的讨论底稿:
policy app-routing: group "voice-video": apps: [sip, rtp, teams, zoom, webrtc] path-preference: [mpls, dia-1] # 优先序,禁普通宽带 sla: latency: {trigger: 150, recover: 120, unit: ms} loss: {trigger: 1.0, recover: 0.5, unit: percent} switch: confirm-cycles: 3 # 连续三个周期确认 sticky: false # 实时流不粘性,随时切优 drain: fast # 存量流快速迁移 group "erp-crm": apps: [sap-gui, https:erp.example-app.cn] path-preference: [mpls, dia-1] sla: latency: {trigger: 100, recover: 80} switch: {confirm-cycles: 3, sticky: true} group "backup": apps: [rsync, s3-replication] path-preference: [broadband-only] schedule: "22:00-06:00" sla: none # 只求送达,无 SLA 约束 default: path-preference: [broadband] # 未识别流量兜底 sla: none
评审这份骨架时逐行问三个问题:每个组的应用清单全不全(漏掉的应用掉进 default);偏好序里的链路在目标站点真的存在吗(策略引用了不存在的链路是常见翻车点);触发与恢复的缓冲带够不够宽(抖动大的链路要加宽)。
问题:切换瞬间会不会丢数据?
取决于流量类型与实现。对 UDP 实时流(语音视频),切换只影响切换瞬间的个别包,丢一两个包在纠错(4.1 节 FEC)与应用自身的容错下基本无感。对 TCP 长连接,迁移存量流有乱序风险——多数实现对 TCP 新流立即生效、存量流保持原隧道直到自然结束(配合粘性策略),从根上避开乱序。少数支持存量流迁移的实现靠双发过渡(新旧隧道同时发直到对端确认),代价是短暂带宽翻倍。方案评审时问清"存量 TCP 流切换时的行为"属于哪一种,能提前避开上线后最诡异的性能投诉。
本节要点
- 决策分两档:边缘本地毫秒级查表决策为主,控制器只做跨站点全局权衡。
- 策略表是决策的唯一依据:应用组、链路偏好序、SLA 触发与恢复条件,缺一行就有一类流量失控。
- 滞回是防乒乓的生命线:触发 150、恢复 120,缓冲带内只观察;连续三个周期确认再动作。
- 切换默认对新流立即生效,存量流按应用特性迁移;长连接建议开粘性。
- 全不达标时择优劣化并告警,接力棒交给第 4 章的纠错加速。
选路把流量放到了"当下最好"的链路上,但如果最好的链路本身质量平庸呢?下一章解决廉价链路的先天短板。