1.3 威胁模型与隐私度量
1.3 威胁模型与隐私度量
本节摘要:没威胁模型谈隐私保护是空谈。本节讲清楚威胁模型(半诚实/恶意/隐蔽)、隐私度量(ε-差分隐私/k-匿名/t-接近)、以及怎么把"隐私保护"量化成可验证的指标。读完你能给项目定威胁模型、选度量、验证保护效果。
一、为什么需要威胁模型
隐私保护不是绝对的——"完全隐私"无意义(数据要能用)。必须明确:
- 防谁:防外部攻击者?内部运维?参与方?云服务商?
- 防什么:防看到原始?防推断?防关联?防重新识别?
- 在什么假设下:参与方诚实吗?能串通吗?硬件可信吗?
威胁模型回答这些,定义"在什么威胁下保证什么"。没威胁模型,"隐私保护"是营销词不是技术指标。
二、参与方行为模型
PETs 中参与方的行为假设是威胁模型核心:
1. 半诚实(Honest-but-Curious, Semi-Honest)
- 参与方按协议执行(不偏离),但记录所有中间信息尝试推断。
- 最弱威胁——只防"偷看"不防"作弊"。
- 多数 MPC 协议先证半诚实安全,再扩展到恶意。
2. 恶意(Malicious)
- 参与方可能任意偏离协议——输入假数据、错误计算、中途退出、串通。
- 更强威胁——要防"作弊"。
- 恶意安全协议更复杂(加承诺、零知识证明、MAC 校验),性能开销大。
3. 隐蔽(Covert)
- 介于半诚实和恶意——参与方可能作弊,但怕被发现(声誉损失)。
- 协议保证"作弊以高概率被发现",作弊方因怕被发现而不作弊。
- 性能介于半诚实和恶意之间。
4. 理性(Rational)
- 参与方按博弈论理性——按自己利益最大化行为。
- 协议设计让"诚实"是纳什均衡——诚实比作弊有利。
- 理论性强,工程少用。
选模型要按场景——银行间合作可能半诚实(有合同约束),跨竞争企业合作要恶意(怕对手作弊)。
三、攻击者能力模型
攻击者能做什么:
1. 计算能力
- 多项式时间:标准假设,攻击者多项式时间算法。
- 量子:量子计算机攻击(影响 RSA/ECC,后量子密码学应对)。
- 无限:信息论安全——不依赖计算假设,但成本高。
2. 通信访问
- 被动:只观察通信(窃听)。
- 主动:可修改/重放/注入通信(中间人)。
- 网络位置:能控制多少网络节点。
3. 串通
- 不串通:参与方独立。
- 串通:多个参与方私下协商,联合推断。
- 门限:能串通多少方(如 t-of-n,t 个串通才破解)。
4. 侧信道
- 时间:测量计算时间推断数据。
- 功耗:测量功耗推断。
- 缓存:缓存状态推断。
- 电磁:电磁辐射推断。
- TEE 特别受侧信道威胁,要专门防护。
四、隐私度量
"隐私保护多少"怎么量化?几种度量:
1. ε-差分隐私(Differential Privacy)
- 定义:相邻数据集(差一个个体)的查询输出概率比 ≤ e^ε。
- 直觉:加入/移除任意个体,输出分布几乎不变——个体不可识别。
- ε 越小越隐私(ε=0 完全隐私但无信息,ε=∞ 无隐私)。
- 实践:ε=0.1-1 强隐私,ε=1-10 中等,ε>10 弱。
- 是统计隐私的金标准,Apple/Google/美国普查用。
2. k-匿名(k-Anonymity)
- 定义:发布数据集中,任意记录在准标识符(如邮编+年龄+性别)上至少和 k-1 个其他记录相同。
- 直觉:任意个体混在至少 k 人群中,不能唯一识别。
- k 越大越隐私(k=1 无隐私,k=100 强)。
- 缺陷:不防同质攻击(k 个都同敏感值)和背景知识攻击,已被差分隐私超越。
3. l-多样性(l-Diversity)
- k-匿名的扩展——每个 k-匿名组内敏感属性至少有 l 个不同值。
- 防同质攻击(k 个都同敏感值时仍泄露)。
4. t-接近(t-Closeness)
- 进一步——敏感属性分布和全局分布距离 ≤ t。
- 防背景知识攻击(知道全局分布推断个体)。
5. 信息论度量
- 互信息:输出和输入的互信息,越小越隐私。
- 猜测熵:攻击者猜中个体的不确定性。
- 更理论,工程少用。
五、威胁模型的实例
场景:两家银行联合信用评分
威胁模型:
- 参与方:银行 A、银行 B,各持客户数据。
- 行为:半诚实——按协议执行,但想推断对方客户。
- 攻击者:对方银行(不是外部黑客),怕对方知道自己的客户名单和信用。
- 串通:不适用(只有两方)。
- 侧信道:不考虑(协议层防护)。
- 隐私目标:A 不知道 B 的客户名单,B 不知道 A 的;只输出联合评分。
选型:MPC(两方半诚实,性能可接受),不用恶意协议(合同约束半诚实)。
场景:手机输入法联邦学习
威胁模型:
- 参与方:千万用户手机 + 服务器。
- 行为:用户可能恶意(注入坏数据),服务器半诚实(好奇用户输入)。
- 攻击者:服务器推断用户输入习惯。
- 隐私目标:服务器学不到用户个体输入,只学到群体模型。
选型:联邦学习 + 差分隐私(防服务器推断)+ 安全聚合(防服务器看到个体梯度)。
六、度量的工程意义
度量不是学术装饰,是工程必需:
1. 合规验证:GDPR 要求"可证明隐私保护",度量给可验证指标(ε-差分隐私的 ε 可计算)。
2. 性能权衡:度量让"隐私-性能"权衡可量化——ε 小则噪声大则精度低,可调参。
3. 攻击验证:红队攻击验证保护——给定 ε,攻击者能推断多少?度量给理论上界。
4. 透明度:公开度量(如 Apple 公布 ε)让用户和监管信任。
5. 持续监控:度量随数据/查询累积变化(差分隐私隐私预算消耗),要监控不超限。
没度量的"隐私保护"是黑箱——不知道保护多少,无法验证、无法权衡、无法合规。所以 PETs 工程必须配度量。
⚠️ 常见误读:以为"上了 PETs 就完全隐私"。隐私保护是相对的——在威胁模型下保证特定度量。没威胁模型和度量,"隐私保护"是营销词。ε-差分隐私的 ε 是关键——ε 大则弱保护。
💡 关键直觉:威胁模型定义"防谁防什么在什么假设下"——参与方行为(半诚实/恶意/隐蔽/理性)、攻击者能力(计算/通信/串通/侧信道)。隐私度量量化保护——ε-差分隐私(金标准,相邻数据集概率比≤e^ε)、k-匿名/l-多样性/t-接近(防同质/背景攻击)、信息论(互信息/熵)。度量是工程必需——合规验证、性能权衡、攻击验证、透明度、持续监控。
核心回顾
- 威胁模型必要性:隐私保护相对,需明确防谁/防什么/在什么假设下,没模型是营销词。
- 参与方行为:半诚实(只偷看)、恶意(任意作弊)、隐蔽(怕被发现而不作弊)、理性(博弈论)。
- 攻击者能力:计算(多项式/量子/无限)、通信(被动/主动)、串通(门限 t-of-n)、侧信道(时间/功耗/缓存/电磁)。
- 隐私度量:ε-差分隐私(相邻数据集概率比≤e^ε,金标准)、k-匿名(混在 k 人群)、l-多样性(防同质)、t-接近(防背景知识)、信息论(互信息/熵)。
- 实例:银行联合评分(半诚实 MPC)、手机联邦学习(恶意用户+半诚实服务器,FL+DP+安全聚合)。
- 工程意义:合规验证(GDPR 可证)、性能权衡(ε-噪声-精度)、攻击验证(理论上界)、透明度(公开 ε)、持续监控(隐私预算消耗)。
- 关键:PETs 工程必须配威胁模型和度量,否则是黑箱。
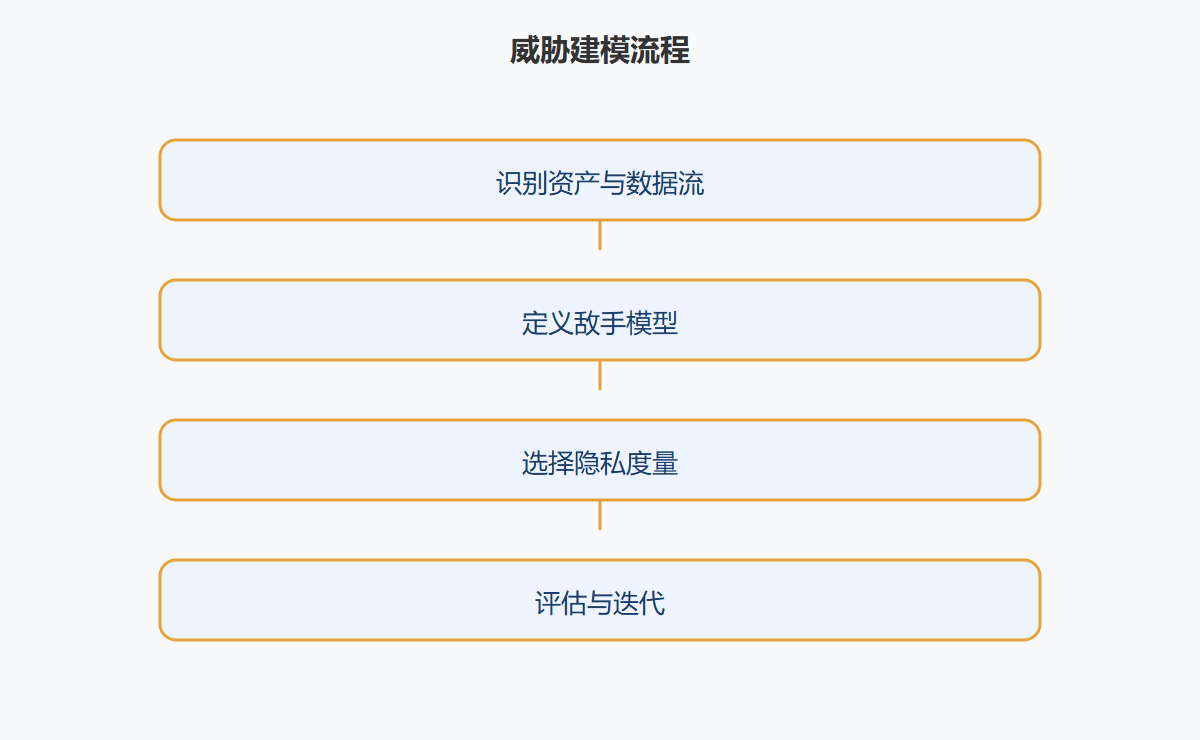
威胁建模流程