1.1 并行计算基础理论与性能极限
1.1 并行计算基础理论与性能极限
本节摘要:并行计算不是"把任务切开分给人"那么简单,它是依赖约束下的协同执行,受三个不可剥离的锚点制约:依赖约束(真数据依赖不可并行)、协同开销(同步和通信本身消耗资源)、目标双重性(延迟最优与吞吐最优导向不同权衡)。本节讲清这个本质,用阿姆达尔定律和古斯塔夫森定律界定并行加速的理论上限,区分强扩展性与弱扩展性,并解释为什么增加处理器反而可能让总耗时上升。
本节目标
阅读完本节,你应当能够:
- 说清并行计算的定义和三个锚点
- 用阿姆达尔定律估算加速上限,解释串行段的"幽灵"效应
- 区分强扩展性与弱扩展性,说清它们各自衡量什么
- 解释为什么增加处理器不一定提速
一、问题与直觉
初学者常把并行计算误解为"把任务切开,分给多个人干"。这没错,但远远不够。如果只停留在这一层,没法解释三个现象:为什么有些问题天然抗拒并行化;为什么增加处理器数反而让总耗时上升;为什么一台峰值很高的超算,跑某些实际任务时效率不到峰值的百分之几。
关键在于:并行性不是外加的优化手段,而是问题内在结构的镜像投射。考虑矩阵乘法,每个输出元素的计算看似独立,天然有并行性。但如果按输出元素划分任务,每个计算都要访问整行和整列——数据局部性崩塌,内存带宽成瓶颈;如果按内积维度切分(如 Cannon 算法),则要精心设计数据循环移位,让每个处理器在本地缓存维持活跃子块,此时通信模式和计算节奏严格耦合。并行策略的选择,本质上是对问题数据流、控制流、依赖流的三维建模。
这就是为什么并行计算的定义里,有三个不可剥离的锚点:依赖约束、协同执行、目标双重性。理解这三点,才能看清并行的能与不能。
判断一个问题是真并行还是假并行,有一个实用办法:把它的依赖图画出来,看最长依赖链有多长。最长链决定了"在不加任何额外硬件的前提下,这件事最快也得多少步完成"——这就是临界路径长度。并行能做的,只是把不在临界路径上的工作分摊到多个单元同时做,从而缩短总时间;临界路径本身一步都省不掉。所以工程师拿到一个串行算法,第一件事不是急着加线程,而是先问:哪些计算在依赖链上,哪些不在。在依赖链上的,是优化的硬骨头;不在的,才是并行的领地。
二、核心原理
2.1 并行的三个锚点
第一是依赖约束。这是并行的铁律。如果任务二必须等任务一输出才能启动,二者构成真数据依赖,不可并行。阿姆达尔定律里那个挥之不去的串行段,就是不可分解依赖的量化体现。
第二是协同执行。并行不是散兵游勇。处理器间需要同步、通信、共识。这些活动本身不产生计算结果,却消耗时间、能量和带宽——它们是并行世界的"摩擦力"。
第三是目标双重性。并行既追求时间最优(延迟受限问题,如实时天气预报),也追求吞吐最优(吞吐受限问题,如基因序列批量比对)。二者导向截然不同的架构权衡:前者偏爱低延迟互连和确定性调度,后者拥抱高吞吐网络和弹性资源池。
2.2 阿姆达尔定律:串行段的幽灵
阿姆达尔定律(Amdahl's Law)界定了固定问题规模下,并行能带来的最大加速。它的核心公式是:最大加速比等于一除以(串行比例加上并行比例除以处理器数)。
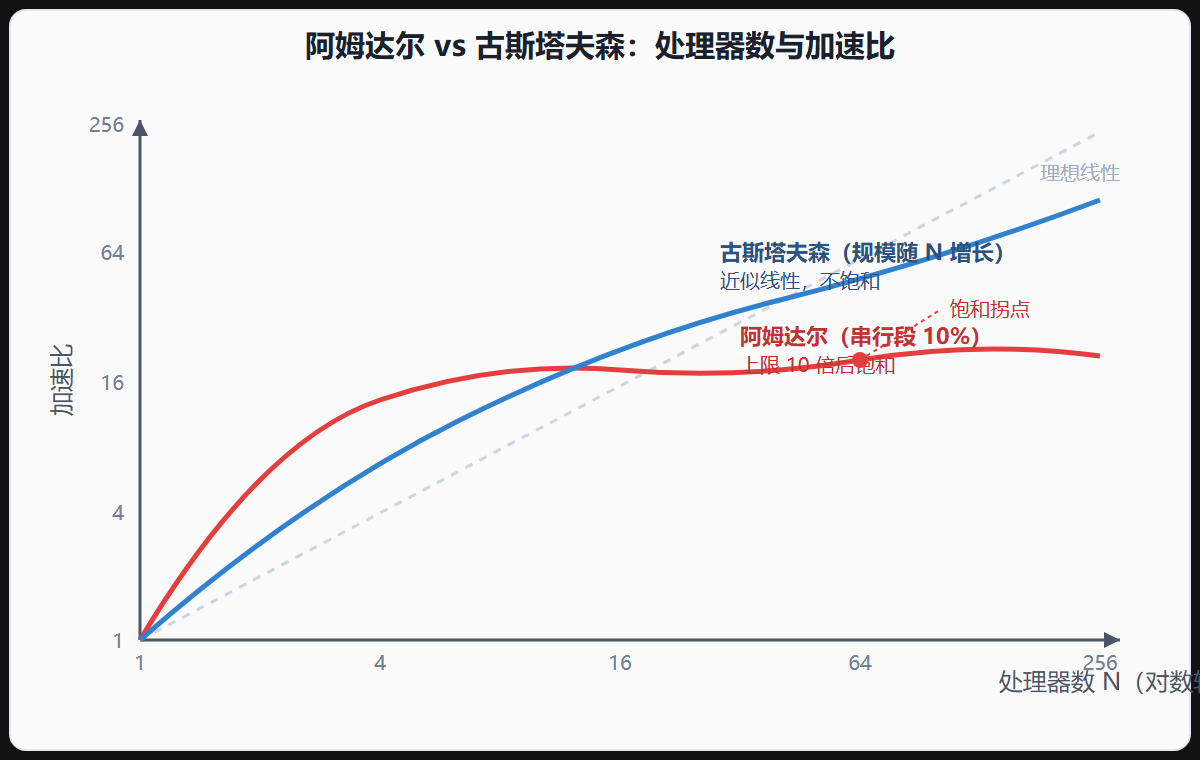
这个定律揭示一个残酷现实:哪怕你有无限多个处理器,最大加速也被串行段死死卡住。如果一个问题有百分之十的串行段,无论你堆多少处理器,最大加速都不超过十倍。这就是为什么盲目堆硬件没用——得先把串行段压下去。
把这条定律用工程语言翻译一遍。设串行段占比是 s,那么理论加速上限就是 1/s。s 等于 0.1,上限是 10 倍;s 等于 0.01,上限是 100 倍;s 等于 0.001,上限是 1000 倍。注意这条曲线在双对数坐标下不是直线,而是一条迅速弯下去的渐近线。它给我们的工程启示很直接:在低核数阶段,压串行段的边际收益最大。一台四核机器上从串行段 20% 压到 10%,可能就把加速从 4 倍抬到 8 倍;但同一台机器上再去优化已经只占 1% 的串行段,几乎看不出变化。所以调优的火力应该集中在串行段占比还高的阶段,等它被压到个位数百分点,再继续抠的收益就微乎其微了。
还有一个容易被忽略的点:阿姆达尔定律里的"串行段"不只是源代码里一眼能看出来的那段串行循环。初始化、结果汇总、IO 读写、全局同步、串行化的归并——这些都属于广义的串行段。很多时候你以为已经把程序"完全并行化"了,profiler 一跑才发现还有 5% 的时间花在某个不起眼的串行 IO 上,它就把你的加速上限卡死在 20 倍。识别这些隐性串行段,靠的是测量而不是猜。
阿姆达尔定律解释了"增加处理器反而变慢"的部分原因:当并行段已经被加速到远小于串行段时,再增加处理器只增加通信和同步开销,而不缩短总时间,净效果是变慢。
2.3 古斯塔夫森定律:规模可扩展的乐观
古斯塔夫森定律(Gustafson's Law)从另一个角度看问题:它假设问题规模随处理器数增长(弱扩展场景),得出的结论乐观得多——加速比随处理器数近似线性增长,前提是你愿意让问题规模也跟着涨。
| 定律 | 假设 | 结论 | 适用场景 |
|---|---|---|---|
| 阿姆达尔 | 问题规模固定 | 加速有上限 | 强扩展、延迟受限 |
| 古斯塔夫森 | 问题规模随处理器增长 | 加速近似线性 | 弱扩展、吞吐受限 |
两个定律不矛盾,它们描述的是不同场景。现实中很多 HPC 应用是弱扩展的——给超算更多核,不是为了把同样的问题算得更快,而是为了算更大的问题(更高分辨率的气候模型、更精细的分子模拟)。这时古斯塔夫森定律更贴切。
但有一个工程上的反直觉点要讲清楚:弱扩展"看起来更乐观",并不等于它做起来更轻松。弱扩展把问题规模和处理器数一起涨,意味着每张卡要处理的数据量不变,但全局数据总量在膨胀。随之而来的是全局通信量的增长、检查点体积的膨胀、并行文件系统带宽的压力。换句话说,古斯塔夫森定律保住的是"单卡的计算效率",但没保住"系统的工程复杂度"。很多团队在从一千张卡扩到一万张卡时栽跟头,不是因为算力不够,而是因为检查点写不下、故障恢复太慢、通信拓扑撑不住。这些是弱扩展特有的工程税,定律本身不会替你交。
判断你手上这个应用到底该看哪条定律,有一个简单的判据:固定输入规模,你愿意让它算得更快吗?如果是,那是强扩展场景,阿姆达尔约束压顶;如果你宁愿算一个更大的问题、时间能接受不缩短,那是弱扩展场景,古斯塔夫森给你留了余地。气象部门做台风路径预报,关心的是强扩展——同样分辨率的模型能不能在一小时内出结果;做气候百年推演的团队,关心的是弱扩展——能不能把分辨率从十公里提到一公里,跑一百年。同样是大气模拟,两个团队面对的扩展性曲线完全不同。
图 阿姆达尔与古斯塔夫森的加速曲线对比
2.4 强扩展性与弱扩展性
强扩展性(strong scaling)衡量的是:固定问题规模下,增加处理器能缩短多少时间。理想情况下时间随处理器数线性下降,但受阿姆达尔定律约束,实际会饱和。
弱扩展性(weak scaling)衡量的是:处理器和问题规模同步增长时,时间能否保持不变。理想情况下时间不变(每个处理器分到的工作量不变),但受通信开销约束,实际会上升。
💡 关键直觉:评估一个并行系统,先搞清楚你关心的是强扩展还是弱扩展。延迟受限的应用(实时预报)关心强扩展——同样的问题能不能算得更快;吞吐受限的应用(批量比对)关心弱扩展——能不能用更多资源算更大的问题。两者的优化方向完全不同。
三、工程实践要点
3.1 先找串行段
调优并行程序的第一步,不是急着加并行,而是找出串行段在哪。一个常见的误区是花大力气优化已经很快的并行部分,却忽视了占大头的串行段。用性能分析工具(profiler)先定位热点,把串行段能并行化的并行化、不能并行化的尽量缩短,这才是提升整体加速比最有效的路径。
| 优化对象 | 效果 | 难度 |
|---|---|---|
| 串行段 | 提升加速上限(阿姆达尔) | 高,常需重构算法 |
| 并行段效率 | 提升实际性能 | 中,调通信和负载 |
| 通信开销 | 减少摩擦力 | 中,优化数据分布 |
3.2 评估扩展性别只看小规模
⚠️ 常见坑:只在四核、八核的小规模上测扩展性,得出"线性加速"的乐观结论,一上到几百核就崩。小规模下通信开销占比小,掩盖了真实瓶颈。评估扩展性一定要从小规模测到目标规模,看曲线在哪里开始偏离理想——那个拐点就是你的通信或负载瓶颈所在。
3.3 问题本身的并行性
有时候扩展性差不是实现的问题,是问题本身的并行性有限。隐式时间积分里的大型稀疏线性方程组求解,其收敛速度随问题规模恶化,导致并行效率随处理器数塌缩。这类问题不适合"粗粒度并行",可能需要异步并行、事件驱动、近似计算这些非常规思路。识别问题本身的并行性上限,比盲目优化实现更重要。
判定一个问题是不是"算法受限",有个工程经验值可以参考。把同一份代码在 8、32、128、512 个进程上各跑一遍,画出效率对进程数的曲线。如果效率随规模下降但每翻一倍只掉几个百分点,那多半是通信或负载问题,能通过工程手段缓解;如果效率在某个规模之后断崖式塌缩,掉到原来的几分之一,那基本是算法层面有不可并行的内核,再怎么加硬件都没用,得换算法或者改数学模型。这个诊断成本很低——几小时就能跑完——但能帮你避免在死胡同里耗几个月。
还有一类问题更狡猾:它们在理论上并行度很高,但实际并行起来效率很低,因为依赖是数据相关的——也就是计算到一半才知道下一步该取哪块数据。典型的例子是不规则图遍历、自适应网格细化的求解。这类问题不是不能并行,而是没法预先把任务切好,得靠动态调度、任务队列、工作窃取这些机制在运行时分配。这类问题的并行效率往往远低于规则网格问题,不是工程师菜,是问题本身的性质决定的。
一节小结
- 并行的本质是依赖约束下的协同执行,三个锚点:依赖、协同开销、目标双重性。
- 阿姆达尔定律:固定问题规模下,加速被串行段死死卡住,堆硬件有上限。
- 古斯塔夫森定律:问题规模随处理器增长时,加速近似线性(弱扩展乐观)。
- 强扩展看时间降不降,弱扩展看时间稳不稳,两者优化方向不同。
- 调优先找串行段:盲目优化并行部分不如先压缩串行段提升上限。
下一节看这些理论在什么硬件上落地——并行计算机的体系结构。