1.2 并行计算机体系结构
1.2 并行计算机体系结构
本节摘要:并行计算的理论要落在具体硬件上。本节讲清弗林分类法(SISD、SIMD、MISD、MIMD)这个体系结构的基本坐标系,重点对比共享内存(多核 CPU、统一地址空间)与分布式内存(集群、消息传递)的取舍,以及 GPU 等异构加速器在 HPC 里的角色——它们用海量轻量线程换高吞吐,适合数据并行但灵活性弱。读完你会知道不同并行硬件各自适合什么任务,以及为什么现代超算几乎是"多核 CPU 加 GPU 加高速互连"的异构组合。
你能学到什么
阅读完本节,你应当能够:
- 用弗林分类法区分四类体系结构
- 说清共享内存与分布式内存的编程模型差异和取舍
- 解释 GPU 为什么适合数据并行但不适合所有任务
- 理解现代超算为什么是异构组合
一、问题与直觉
选并行硬件时,很多人第一反应是"挑算力最强的"。但算力峰值只是表象,真正决定适不适合的是硬件的"性格"——它是擅长大量简单计算(GPU),还是擅长复杂逻辑控制(CPU);它的内存是大家共享一份(共享内存),还是各管各的(分布式内存);它的线程是少量重量级(CPU 多核),还是海量轻量级(GPU)。性格不匹配,再强的算力也发挥不出来。
这就是为什么并行计算机体系结构值得专门讲——它决定了你能用什么编程模型、适合什么算法、瓶颈会出在哪。一台 GPU 集群跑矩阵乘法飞快,但跑强依赖、分支密集的任务可能比 CPU 还慢。选硬件和选工具一样,没有最强的,只有最匹配的。
二、核心原理
2.1 弗林分类法
弗林分类法(Flynn's Taxonomy)按指令流和数据流的数量,把体系结构分成四类:
| 类型 | 指令流 | 数据流 | 特点 | 例子 |
|---|---|---|---|---|
| SISD | 单 | 单 | 传统串行 | 老式单核 CPU |
| SIMD | 单 | 多 | 一条指令处理多个数据 | GPU、向量处理器 |
| MISD | 多 | 单 | 多指令处理同一数据 | 罕见,容错系统 |
| MIMD | 多 | 多 | 多指令多数据,最灵活 | 多核 CPU、集群 |
实际 HPC 系统几乎是 MIMD 的,但在 MIMD 框架内部,又会用 SIMD 手段(比如 CPU 的向量指令、GPU 的 SIMT 执行)来榨取数据并行性。所以现代体系结构是"宏观 MIMD、微观 SIMD"的混合。
弗林分类法的价值不在于它有多精确——学术界早就指出它粗糙,比如把 GPU 笼统归为 SIMD 就掩盖了 SIMT 和纯 SIMD 的区别。它的真正价值是提供了一套坐标系:拿到一台陌生机器,先问它指令流几条、数据流几条,你立刻就知道它属于哪一象限,能套用什么编程模型。这是一种快速归类的心智工具,而不是精确的物理描述。工程实践里更常用的是另一套更细的划分:按内存模型分(共享/分布式)、按地址空间是否统一分(UMA/NUMA)、按是否含加速器分(同构/异构)。这些维度才是真正影响编程决策的。
2.2 共享内存与分布式内存
这是并行体系结构最根本的分野,它直接决定了编程模型。
共享内存架构里,所有处理器访问同一份内存(统一地址空间)。好处是编程简单——任何处理器都能直接读写任何数据,不需要显式通信;代价是扩展性差——处理器一多,内存带宽和一致性协议就成了瓶颈,典型上限在几十核。多核 CPU、多路服务器是典型。
分布式内存架构里,每个处理器有自己的私有内存,处理器间靠网络消息传递交换数据。好处是扩展性好——加节点就加内存和算力,能堆到成千上万核;代价是编程复杂——数据在不同节点间要显式搬运,通信延迟和带宽成了核心瓶颈。计算集群、超算是典型。
| 维度 | 共享内存 | 分布式内存 |
|---|---|---|
| 地址空间 | 统一 | 各自私有 |
| 数据交换 | 直接读写 | 消息传递 |
| 编程模型 | OpenMP 等线程级 | MPI 等消息传递 |
| 扩展性 | 差(几十核) | 好(上万核) |
| 典型瓶颈 | 内存带宽、一致性 | 通信延迟和带宽 |
💡 关键直觉:共享内存和分布式内存的取舍,本质是"编程便利"和"扩展能力"的权衡。小规模任务用共享内存省心,大规模任务必须上分布式内存。现代超算几乎都是分布式内存的节点(每个节点内部又是共享内存的多核),这就是为什么 HPC 编程里 MPI(节点间)和 OpenMP(节点内)经常搭配使用。
需要补充一点容易被忽视的细节:共享内存不是铁板一块,它还分 UMA(统一内存访问)和 NUMA(非统一内存访问)两种。小规模的多核 CPU 是 UMA,所有核访问任何内存位置的延迟都差不多;但一旦上到多路服务器,物理上是几个 CPU 各自带着一部分内存,访问"自己的"内存快、访问"别人的"内存慢,这就是 NUMA。NUMA 在编程模型上还是共享内存,但要发挥性能得显式做内存亲和性绑定——把数据和访问它的线程放在同一个 NUMA 节点上,否则跨节点访问的延迟可能比预期高三四倍。很多新手在双路服务器上跑 OpenMP,发现性能不如预期,一查就是线程在访问远端内存。
这也是为什么"共享内存扩展到几十核就到顶"这个说法要打折扣——限制它的不只是带宽,更是 NUMA 效应。八路以上的服务器,NUMA 拓扑会变得很复杂,跨 NUMA 节点的访问延迟能差出一个数量级。这种机器上写共享内存并行,得像写分布式一样精细地处理数据分布。
2.3 GPU 与异构加速
GPU(图形处理器)原本为图形渲染设计,但其海量轻量线程的架构意外地适合通用并行计算。CPU 和 GPU 的"性格"对比很能说明问题:
| 维度 | CPU | GPU |
|---|---|---|
| 核心数 | 少(几个到几十个) | 多(成千上万) |
| 单核能力 | 强,复杂逻辑和分支 | 弱,简单计算 |
| 适合任务 | 控制密集、分支密集 | 数据并行、计算密集 |
| 内存层次 | 深缓存,低延迟 | 浅缓存,高带宽 |
GPU 用海量轻量线程换高吞吐,适合矩阵运算、卷积这类数据并行的计算——这也是为什么深度学习训练几乎离不开 GPU。但 GPU 不适合强依赖、分支密集的任务,那些任务在 GPU 上反而比 CPU 慢。
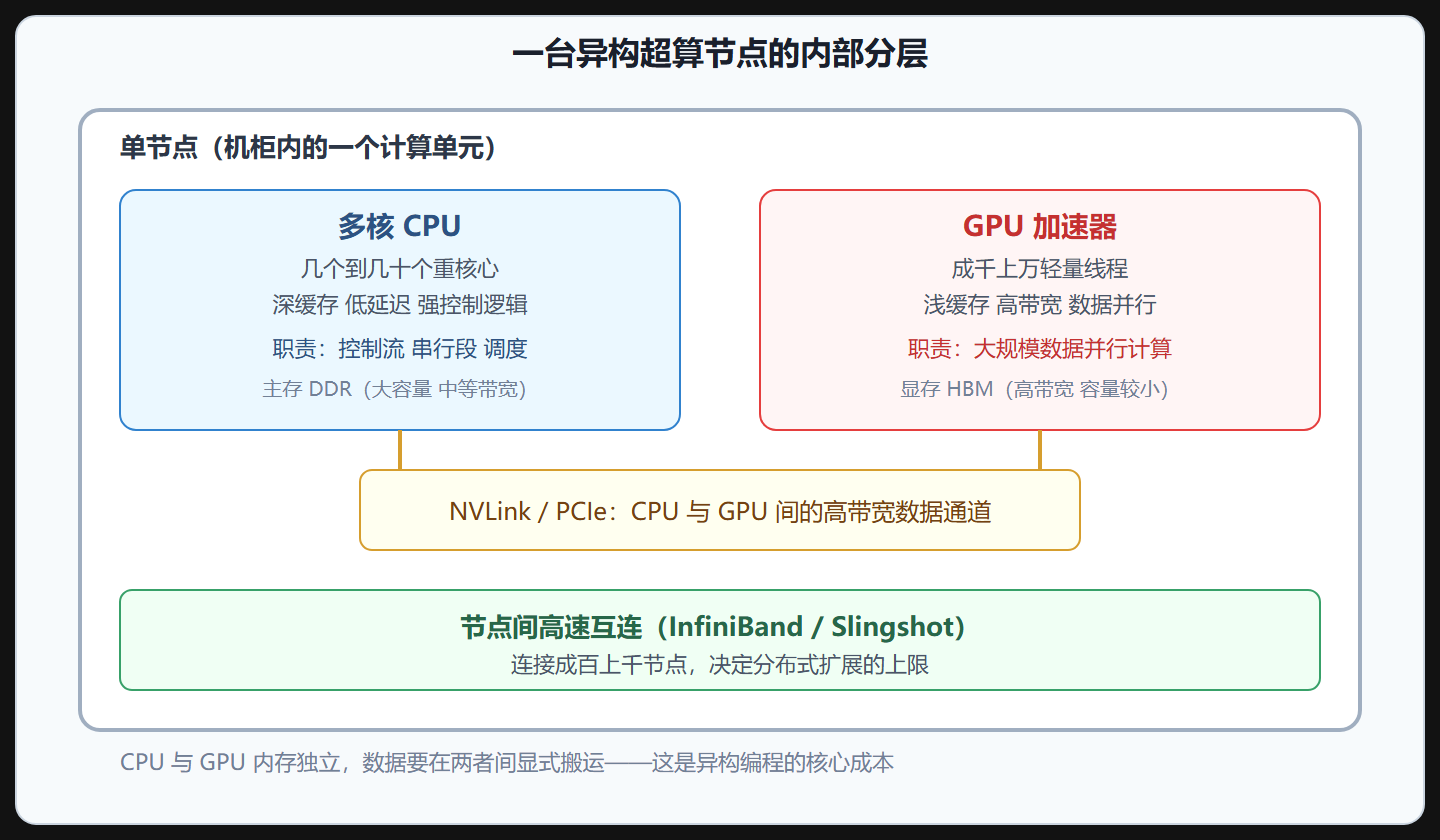
现代超算几乎是"多核 CPU 加 GPU 加高速互连"的异构组合:CPU 负责控制流和串行部分,GPU 负责大规模数据并行,节点间用 InfiniBand 等高速网络互联。这种异构架构榨取了各类硬件的长处,但也让编程更复杂——你得把任务合理地分配到 CPU 和 GPU 上,还得管理数据在两者间的搬运。
异构节点的内存层次尤其值得展开。一张现代 GPU 上同时挂着 HBM(高带宽内存)和访问主机 DDR 内存的两条通道。HBM 带宽能到几个 TB 每秒,是主机内存带宽的好几倍,但容量有限(通常几十 GB)。这意味着算法设计时要分清哪些数据是"热"的——频繁访问、需要塞进 HBM;哪些是"冷"的——偶尔读一次、放在主机内存也无所谓。一个常见错误是让 kernel 频繁从主机内存取数,结果 PCIe 带宽(几十 GB 每秒)成了瓶颈,GPU 的算力完全空转。好的异构算法会先把一大块数据预取进 HBM,反复计算完再一次性写回主机,让搬运的代价被大量计算摊薄。
选 GPU 也不能只看峰值算力。同样标称 50 TFLOPS 的两张卡,一张 HBM 大、一张 HBM 小,跑内存受限的应用(比如稀疏矩阵向量乘)性能能差好几倍。深度学习训练里,卡的 HBM 容量直接决定能训多大的模型;通信带宽(NVLink 还是 PCIe)决定多卡并行的效率。这些参数的选择依据是应用特征,不是"越贵越好"。
图 当代异构节点的分层透视
三、工程实践要点
3.1 选硬件先看任务特征
| 任务特征 | 推荐硬件 | 理由 |
|---|---|---|
| 数据并行、计算密集 | GPU | 海量线程高吞吐 |
| 控制密集、分支密集 | CPU 多核 | 单核强、逻辑灵活 |
| 小规模、需简单编程 | 共享内存多核 | 无需消息传递 |
| 大规模、需扩展 | 分布式集群 | 可堆到上万核 |
| 大规模数据并行 | GPU 集群加高速互连 | 异构组合 |
3.2 异构编程的难点
⚠️ 常见坑:把 CPU 代码直接搬到 GPU 上跑,期待自动加速。GPU 要发挥性能,算法必须适应它的执行模型——数据要能并行展开、内存访问要合并、分支要尽量少。直接搬上去往往比 CPU 还慢,因为没利用 GPU 的优势反而踩了它的短板(如分支惩罚、数据搬运开销)。异构计算的核心是"为硬件重写算法",不是"把代码挪个地方"。
数据搬运是异构计算的隐形杀手。CPU 和 GPU 有各自独立的内存,数据要在两者间复制。如果计算量不够大、搬运开销占比高,GPU 的算力优势就被搬运吃掉了。所以异构编程的第一原则是"计算强度够大"——每个搬运过来的数据要能被反复计算多次,让算力开销远大于搬运开销。
3.3 互连网络的重要性
分布式系统和 GPU 集群里,节点间的互连网络常被忽视,但它往往决定真实性能。一台峰值算力很高的集群,如果互连带宽低、延迟高,跑通信密集的应用时效率会大打折扣。InfiniBand、NVLink 这类高速互连的存在,就是为了缩短数据搬运的时间。评估 HPC 系统别只看算力峰值,互连的带宽和延迟同样关键。
互连网络有几个关键参数要会读。延迟(latency)反映小消息往返一次要多少微秒,对频繁小消息的应用敏感(比如分子动力学里的力计算)。带宽(bandwidth)反映大消息能跑多快,对块传输的应用敏感(比如矩阵转置)。拓扑(topology)决定了哪些节点间通信快、哪些慢——Fat-Tree 拓扑让任意两点间路径等长但线缆多,Dragonfly 拓扑线缆少但路径不等长,选哪个取决于应用对全局通信均匀性的要求。一个经验法则:做大型 Allreduce 的应用(大模型训练)要选拓扑均匀的网络;做点对点邻居通信的应用(规则网格模拟)对拓扑要求低一些。
还有一个工程上的反直觉:互连是"共享资源"。一条链路上的多个并发通信会争抢带宽,profiler 里单个通信看起来很快,但很多进程同时通信时,实际带宽会被摊薄到几分之一。这就是为什么大规模集群上跑通信密集应用,效率掉得比预期快——网络争抢是隐形的。预测这种性能塌缩,得用通信模型加上网络争抢的修正项,不能光看单条消息的峰值带宽。
核心回顾
- 弗林分类法分四类,实际 HPC 是"宏观 MIMD、微观 SIMD"的混合。
- 共享内存编程省心但扩展差,分布式内存扩展好但编程复杂,现代超算两者混合。
- GPU 用海量轻量线程换高吞吐,适合数据并行,不适合强依赖分支密集任务。
- 现代超算是 CPU 加 GPU 加高速互连的异构组合,各取所长但编程复杂。
- 异构计算的核心是为硬件重写算法,不是直接搬代码,数据搬运是隐形杀手。
下一章进入怎么在这些硬件上写并行程序——编程模型和算法设计。